System 1决策模型的置信度与决策可信任吗?可解释性与扰动审计

开放审计基准揭示System 1决策模型的校准、干扰与归因特性,4B为关键分水岭。
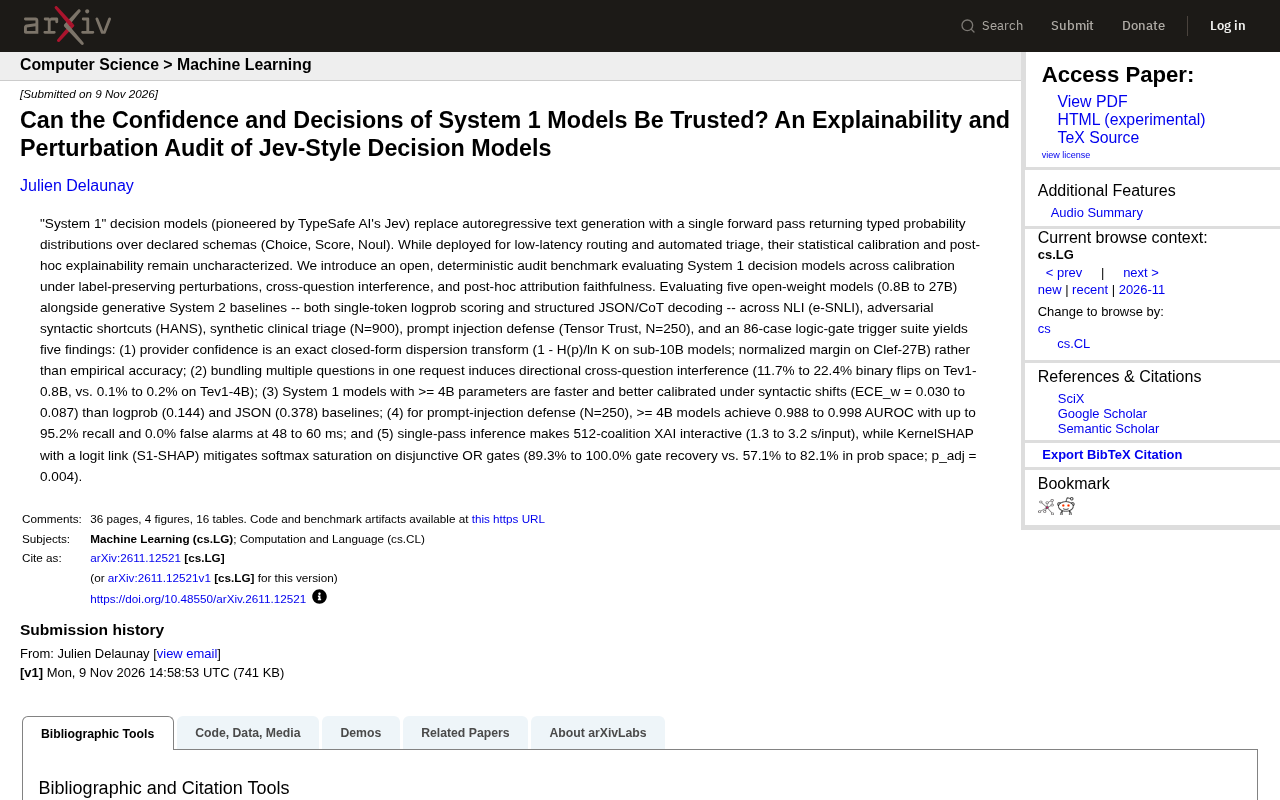
一项开放、确定性的审计基准系统评估了从0.8B到27B的五个开放权重System 1决策模型及System 2基线,覆盖NLI、对抗句法捷径、临床分诊、提示注入防御和逻辑门触发五类任务。审计发现:提供商置信度是闭式离散度变换而非经验准确率;跨问题打包在小于4B模型上引发显著方向性干扰;4B以上模型在句法偏移下校准优于对数概率和JSON解码基线;提示注入防御达0.988–0.998 AUROC且零误报;单次推理使交互式XAI成为可能,S1-SHAP显著改善OR门归因。结论建议将置信度视为排序信号、避免小模型批量打包、并采用与输出层数学结构匹配的归因方法。
System 1 决策模型用单次前向传播替代自回归生成,直接输出类型化概率分布,在低延迟路由和自动分诊等场景中部署。然而,这类模型的统计校准与事后可解释性此前缺乏系统刻画。一项开放、确定性的审计基准填补了这一空白,通过标签保持扰动下的校准、跨问题干扰和事后归因忠实性三个维度,对从0.8B到27B的五个开放权重模型以及生成式System 2基线进行了评估。
审计基准的设计与覆盖范围
该基准覆盖NLI(e-SNLI)、对抗性句法捷径(HANS)、合成临床分诊(N=900)、提示注入防御(Tensor Trust,N=250)以及86例逻辑门触发套件。System 2基线包括单token对数概率评分和结构化JSON/思维链解码两种方式。这种多任务、多基线的设计使得跨模型、跨范式的比较成为可能,而非仅停留在单一数据集上的性能报告。
审计强调确定性——相同输入产生相同输出,便于复现和归因分析。开放基准的定位也意味着结果可被第三方验证,这对于高风险决策场景尤为重要。
发现一:置信度是公式输出,而非经验准确率
审计揭示,提供商报告的置信度是精确的闭式离散度变换——在10B以下模型上为1 - H(p)/ln K,在Clef-27B上为归一化边际——而非基于经验准确率校准的结果。这意味着模型给出的"置信度"本质上是对输出分布形状的数学变换,与真实世界的正确率之间没有必然联系。
这一发现对部署实践有直接影响:若下游系统将置信度阈值作为路由或人工复核的触发条件,那么阈值所对应的实际错误率可能与预期存在系统性偏差。审计建议将置信度视为相对排序信号而非绝对概率,并在部署前用留出数据重新校准。
发现二:跨问题干扰随模型规模缩小而放大
将多个问题打包进单个请求会引发方向性跨问题干扰。在Tev1-0.8B上,二元翻转率达到11.7%至22.4%;而在Tev1-4B上,这一比例降至0.1%至0.2%。干扰的方向性说明问题排列顺序和组合方式会系统性地影响输出,而非随机噪声。
对于批处理API调用场景,这意味着节省延迟和成本的打包策略可能以牺牲一致性为代价。审计结果提示,4B参数似乎是一个分水岭:低于该规模的模型在组合请求下决策稳定性显著下降。
发现三:4B以上模型在句法偏移下校准更优且更快
参数规模达到4B及以上的System 1模型,在句法偏移下不仅速度更快,校准表现也优于两类System 2基线。其加权ECE(ECE_w)为0.030至0.087,而对数概率基线为0.144,JSON解码基线为0.378。
单次前向传播的架构优势在此显现:无需逐token生成即可获得决策分布,既降低了延迟,也避免了生成过程中累积的校准漂移。JSON结构化解码的校准劣势尤为突出,这与其在需要严格格式输出的场景中的流行度形成对照。
加权ECE(Expected Calibration Error) 是衡量模型置信度与实际准确率之间偏差的标准指标。它将预测置信度划分为若干区间(bin),在每个区间内计算置信度均值与经验准确率之差的绝对值,再按各区间样本量加权求和。ECE_w 中的“w”通常指按样本权重或类别频率加权,以缓解类别不平衡带来的偏差。ECE 越低表示校准越好:0 代表完美校准,0.1 以上通常被认为校准较差。在审计中,ECE_w 为 0.030–0.087 意味着模型输出的置信度与真实正确率之间平均偏差仅几个百分点,而 JSON 解码基线的 0.378 则表明其置信度严重高估或低估。需要注意的是,ECE 依赖于分箱策略和样本量,跨研究比较时应确认分箱方式一致。
发现四:提示注入防御的高AUROC与低延迟
在提示注入防御任务(N=250)中,4B及以上模型达到0.988至0.998的AUROC,召回率最高95.2%,在48至60毫秒延迟下实现0.0%的误报。这一组合——高召回、零误报、亚100毫秒响应——使System 1模型在实时安全过滤层具有实用价值。
零误报尤其关键:安全过滤器的误报会直接损害正常用户体验,而高召回则保证攻击样本不被漏放。审计数据表明这两者在4B以上模型中可以同时达成。
发现五:单次推理让XAI交互式运行成为可能
单次前向传播使得512 coalition的XAI分析可以交互式运行,每输入耗时1.3至3.2秒。相比之下,需要多次前向的归因方法在同样coalition规模下难以满足交互需求。
审计还提出S1-SHAP——采用logit链接的KernelSHAP——以缓解softmax饱和对析取OR门的归因失真。在概率空间中,OR门恢复率为57.1%至82.1%;在S1-SHAP下提升至89.3%至100.0%(p_adj = 0.004)。这一改进针对的是逻辑门触发套件中析取结构的归因难题:softmax将多个激活路径的概率压缩,导致归因方法低估任一单一路径的贡献,而logit链接保留了可加性结构。
KernelSHAP 是 SHAP(SHapley Additive exPlanations)框架中一种与模型无关的归因方法,通过核加权线性回归近似 Shapley 值。它把每个特征视为“参与者”,用 coalition(特征子集)上的模型输出来估计每个特征的边际贡献。Shapley 值满足可加性、对称性等公理,理论上能公平分配贡献。然而,KernelSHAP 默认在概率空间中对输出建模,当模型输出经过 softmax 后,概率被压缩到 [0,1] 且饱和区域梯度极小,导致归因值失真。logit 链接 即对概率取对数几率(log-odds),将输出变换回可加性的实数空间,使多个激活路径的贡献可以线性叠加。S1-SHAP 采用 logit 链接的 KernelSHAP,正是为了在析取 OR 门这类“任一条件满足即触发”的结构中,避免 softmax 饱和掩盖单一路径的贡献,从而将 OR 门恢复率显著提升。
对部署实践的含义
综合五项发现,System 1决策模型在4B参数以上展现出可用的校准水平和防御性能,但供应商置信度不能直接当作准确率使用。打包多问题请求在小于4B的模型上引入显著的方向性干扰,应避免或严格限制批量规模。
可解释性方面,单次推理架构使归因分析从离线报告变为可交互工具,S1-SHAP对析取逻辑门的改进说明归因方法需要与模型输出层的数学结构匹配——概率空间的饱和问题在logit空间可以缓解。
审计基准本身的开放与确定性设计,为后续模型迭代提供了可比较的基线。对于在路由、分诊和安全过滤中采用System 1模型的团队,这份审计给出了具体的参数规模阈值、校准参考值和归因方法建议。
相关推荐
Fable 5.2自我改进循环加速,Gemini 4 Carbon紧追
Anthropic Fable 5.2与Google Gemini 4 Carbon同期发布,远程劳动指数翻倍增长,自我改进循环加速,但基准缺陷与评估意识问题并存。
Meta FAIR发布e-means:k-means新替代,收敛快十倍
Meta FAIR 在 FAISS 1.16.0 中发布 e-means,作为 mini-batch k-means 的替代方案,达到同等损失所需 epoch 减少约一个数量级,GPU 加速 10 到 45 倍,且无需新增超参数。
AI写代码好用,但为何代码库越来越脆弱?
AI编程工具提升效率的同时,可能让代码库变得脆弱。本文基于开发者博客和Hacker News讨论,分析AI生成代码的隐性成本、社区分歧与降低风险的实践建议。