TabPFN:终结机器学习调参的表格数据基础模型
TabPFN用合成数据训练,单次前向传播超越XGBoost,开启表格数据基础模型时代。
TabPFN是PriorLabs推出的表格数据基础模型,完全在合成数据上训练,通过上下文学习在单次前向传播中同时完成「训练」与预测,逼近贝叶斯后验预测分布,无需传统调参流程。其核心突破在于识别出跨数据集可迁移的「模式层级」,并以去位置编码的Transformer实现行列顺序不变性,从v1支持1000行演进至v3的百万行规模。与LLM互补而非竞争——LLM负责特征工程与数据清洗,TabPFN负责统计推理。最新的TabPFN 3.5在七项基准夺冠,且一行代码就在历史Kaggle竞赛中击败了36模型手工集成方案,被视为表格数据的「ImageNet时刻」。
深度学习曾在表格数据领域折戟沉沙,TabNet 等被寄予厚望的方案最终都无法泛化到新数据集。而现在,一个名为 TabPFN 的模型让局面彻底逆转——它在表格数据任务上的表现已经显著超越 CatBoost 和 XGBoost。在 MLST 的这场深度访谈中,PriorLabs 联合 CEO、前机器学习教授 Frank Hutter 详细拆解了这项技术的来龙去脉,以及它为何可能成为「表格数据的 ImageNet 时刻」。
表格数据为什么这么难
任何做过表格数据建模的人都深有体会:这是一场噩梦。缺失值怎么处理?类别特征如何编码?要不要做特征工程?不同字段量纲不一致还得归一化、标准化。即便最终搭出一个模型,也总有种「用了一堆捷径、把数据搞脏了」的心虚感。
Frank 直言,这正是深度学习在表格领域迟迟不奏效的原因。图像数据天然同质——像素之间有稳定的空间关系,一个 ImageNet 就能覆盖世间万象。但表格数据是异质的:有离群点、缺失值、类别值、二元值、序数值,还分「随机缺失」和「非随机缺失」。标准深度学习方法把一切都当成同类处理,自然水土不服。
关键的突破在于迁移的层级。一张医疗表和一张保险表之间,行与行的具体信息毫无关联,无法互相学习。但在模式层面——特征如何交互、是否存在因果关系——却可以跨数据集迁移。借助上下文学习(in-context learning),TabPFN 终于把握住了这一层。
用合成数据训练的基础模型
与大语言模型和视觉模型不同,TabPFN 完全在合成数据上训练。原因很现实:互联网上并没有大量可供统计学习的表格数据集。维基百科上「某球员球衣号码」这类表格根本无法用来训练统计模型。整个高质量表格数据集可能只有约 5 万个。
于是 PriorLabs 选择自己生成。这套方法有坚实的贝叶斯理论基础——他们在逼近任意先验下的贝叶斯后验预测分布,而所选的先验富含因果结构,本质上是在对所有可能解释数据的结构因果模型(SCM)求积分。
纯合成数据带来了意想不到的好处:没有数据泄漏、没有记忆问题,可以精确控制数据内容,不必担心偏见。整个生成流程被代码化、可控化。Frank 强调,TabPFN 是首个「完全在合成数据上训练却达到 SOTA」的基础模型,也是第一个真正通过端到端学习、而非人工推导得出的表格算法——它在数亿个数据集上预训练,目标就是在未见测试集上尽可能表现优异。
**结构因果模型(SCM)**是一种用有向无环图(DAG)表示变量之间因果关系的数学框架,其中每个节点代表一个随机变量,有向边表示因果影响,每个变量由其父节点的函数加上噪声项决定。TabPFN 的先验生成过程正是对 SCM 空间进行采样:随机生成一张因果图,再按拓扑顺序逐节点采样数据,由此生成具有真实统计结构(而非仅靠独立同分布假设)的合成表格。贝叶斯后验预测分布则指在给定训练数据后,对新样本标签的概率分布进行积分——积分遍历所有与数据相容的模型参数。TabPFN 通过预训练,把这一原本需要 MCMC 等昂贵方法才能求解的积分,直接「记忆」进网络权重,从而在推理时以单次前向传播近似完成。
一次前向传播完成「训练+预测」
传统流程中,训练和推理都要耗费大量算力。TabPFN 则把整个数据集喂进 Transformer 的上下文,在单次前向传播中完成预测。这与 LLM 的思维链不同——语言模型是自回归逐 token 生成,而表格预测只需预测一个「token」,各测试点彼此独立。
架构设计上也颇有讲究。v1 基本就是去掉位置编码的 Transformer,因为注意力机制本身对顺序不变,而表格数据恰恰需要这种对行列顺序的不变性。
到了 v2,架构真正「理解」了行与列——对矩阵每个元素都有嵌入,交替进行行注意力和列注意力,从而识别出「这一列是类别型」还是「数值型」。不过 v2 的复杂度比 v1 更差,只能撑到约 1 万数据点。v3 借鉴了社区开发的 Tabical 架构,在保持行维度二次复杂度的同时优化了嵌入机制,把处理规模推到百万行量级。
Frank 透露了规模演进的节奏:v1 支持 1000 行,v2 支持 1 万行,v2.5 达到 10 万行,v3 已能处理百万行——每年两个数量级的提升。下一个目标是 1000 万行。
**上下文学习(In-Context Learning,ICL)**是指模型无需更新任何参数,仅凭推理时输入的样本示例就能完成新任务。TabPFN 的工作方式正是如此:将整个训练集(特征+标签)与待预测的测试样本一起拼接成一个超长序列,送入 Transformer。模型在预训练阶段已见过数亿个合成数据集,因此学会了从上下文中「读出」数据的统计规律并直接输出预测,而不需要像传统机器学习那样执行梯度下降或超参搜索。这一机制使 TabPFN 在推理阶段的耗时极短,也从根本上消除了过拟合训练集的风险——因为模型权重在推理期间完全冻结。
为什么 LLM 搞不定表格
有人会问:既然有了 Claude、Codex,为什么不直接让 agent 读表格?Frank 的回答很直接。一张百万行、千列的表格有十亿个元素,每个数字 token 化约需 3-4 个 token,意味着上下文要塞进三四十亿 token——LLM 根本吃不消。更关键的是,序列模型会把表格当成序列逐行读取,无法利用「交换两行或两列后仍是同一数据集」这一不变性。
但两者并非对立。Frank 明确表示 LLM 擅长编码、特征工程、探索性分析和作为用户界面。比如已知身高体重要预测是否肥胖,让 coding agent 在外部算个 BMI,比让网络自己学要简单得多;需要「某国某天是否节假日」这类世界知识时,agent 可以查外部知识库。
他举了个有趣的例子:一位朋友用 Claude 搭配 TabPFN 的 MCP 服务器,让 Claude 自动构建历史比赛数据集,再用 TabPFN 预测世界杯每场比赛结果,最后赢下了公司内部的竞猜。这正是 AutoML 民主化的愿景——门槛极低,却能获得 SOTA 性能。
走向因果:从观察到干预
访谈中最具前瞻性的部分是因果推理。Frank 用经典的医药例子说明相关与因果的区别:病情越重用药越多,若只看用药量预测疾病,模型会「学会」关联,但若据此停药就荒谬了——因果方向恰恰相反。
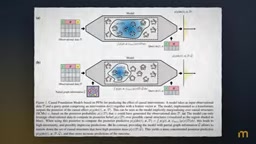
TabPFN 的框架天然适合处理这类问题。在元训练阶段,模型采样因果图、观察变量,还会施加干预并观察效果,从而学会从纯观察数据推理干预效果。PriorLabs 已有 DO-PFN 等论文,并与因果 ML 领域顶尖学者 Bernhard Schölkopf 合作。更进一步的工作允许领域专家指定「A 导致 B」的先验,从而构建更精确的后验。Frank 认为这可能彻底变革医学与 A/B 测试——用更短的研究周期获得与随机对照试验相当甚至更高的置信度。
**DO 演算(do-calculus)**是 Judea Pearl 提出的因果推理形式化工具,核心思想是区分「观察到 X=x」与「对 X 进行干预,强制令 X=x」这两种截然不同的情境,后者用 do(X=x) 表示。传统机器学习只能学习观察分布 P(Y|X),而因果推理关心的是干预分布 P(Y|do(X))——两者在存在混淆变量时可能大相径庭,这正是「病情重→用药多→病情重」这类虚假关联产生的根源。DO-PFN 的思路是在元训练时让模型同时见到观察数据和干预数据(即真实的 do 操作结果),从而学会在仅有观察数据的测试场景下,也能正确估计干预效果,为医学试验和 A/B 测试中的样本效率提升提供了理论基础。
TabPFN 3.5:一行代码拿下 Kaggle 冠军
访谈录制后,PriorLabs 又发布了 TabPFN 3.5,在七个表格相关基准上拿下第一,涵盖含文本的表格、多模态、关系型数据等。相比谷歌此前发布的 TabFM(规模约为其 30 倍),TabPFN 3.5 在同等质量下前向传播快 20 倍,或在更快的同时高出 100 多个 ELO 分。
最震撼的案例来自研究科学家 Nick Erickson(AutoGluon 作者):面对一个有 3500 名参赛者、奖金池 1 万美元的历史 Kaggle Auto Challenge,当年的冠军方案是 36 个模型手工特征工程的多层堆叠集成。而 Nick 用 TabPFN 3.5,一行代码、一块 RTX Pro 6000 GPU、一分钟计算,就拿到了第一名的解。
从 AutoWeka 到神经架构搜索,再到如今的表格基础模型,Frank 走过了十余年 AutoML 之路。他的愿景始终如一:把 SOTA 机器学习交到每个人手里,让数据科学家从调参的琐碎中解放出来,去思考真正重要的问题——数据从哪来、是否存在漂移、公平性、因果、隐私。「这才是更有成就感的工作。」
相关推荐
语音识别远未解决:Mistral音频研究负责人深度解析
Mistral AI音频研究负责人Pavan Kumar Reddy深度解析语音识别为何远未解决:从Voxtral模型架构、连续隐变量生成、流式与批量权衡、说话人分离难题到DPO修复幻觉,以及语音技术在真实企业场景的落地短板。
AI权重可被复制,为何反而扼杀了创造力?
AI模型权重可被随意复制,这种开放权重的无约束特性反而削弱了创造力。本文解析复制为何是反模式、约束如何催生新颖,以及"约束工程师"这一正在浮现的新角色。
NVIDIA Cosmos解析:物理AI如何打通语言、视频与动作
NVIDIA研究负责人Ming-Yu Liu深度解析Cosmos物理AI世界模型:如何用单一架构打通语言、视频、音频与动作,涵盖自回归塔与扩散塔协作、多模态时间对齐、策略验证仿真及Super/Nano/Edge三种开源模型。