telemetry.dev:让AI Agent每次运行都变成可观测的Trace

telemetry.dev 用 Trace+Span 模型为 AI Agent 提供可观测性、Evals 与成本告警。
telemetry.dev 是一款面向 AI Agent 开发者的可观测性工具,核心思路是把每次 Agent 运行映射为一条 Trace,将每个模型调用和工具调用建模为携带耗时、Token 用量、成本与错误信息的 Span,让原本黑盒的运行过程变得可逐层下钻排查。它还把 Prompt 管理与 Evals 评价统一到同一套 Trace 之上,改 Prompt 无需重新部署即可在数据集上跑评测并与生产评分对比。内置告警覆盖错误、成本飙升和 Agent 循环三类运行时风险。接入上提供 TypeScript/Python SDK,并支持 OpenTelemetry exporter 复用现有监控管线。产品适合已在生产环境运行 Agent、面临排障与成本归因痛点的团队。
AI Agent 的调试常常让人头疼:一次运行里混杂着多次模型调用、工具调用和错误处理,出了问题很难定位是哪一步拖慢了速度、谁在偷偷烧钱。telemetry.dev 在 Product Hunt 上给出了一个答案——把 Agent 的每一次运行当作一条完整的 Trace,每个模型调用和工具调用都是 Trace 中的一个 Span,附带耗时、Token 用量、成本和错误信息。
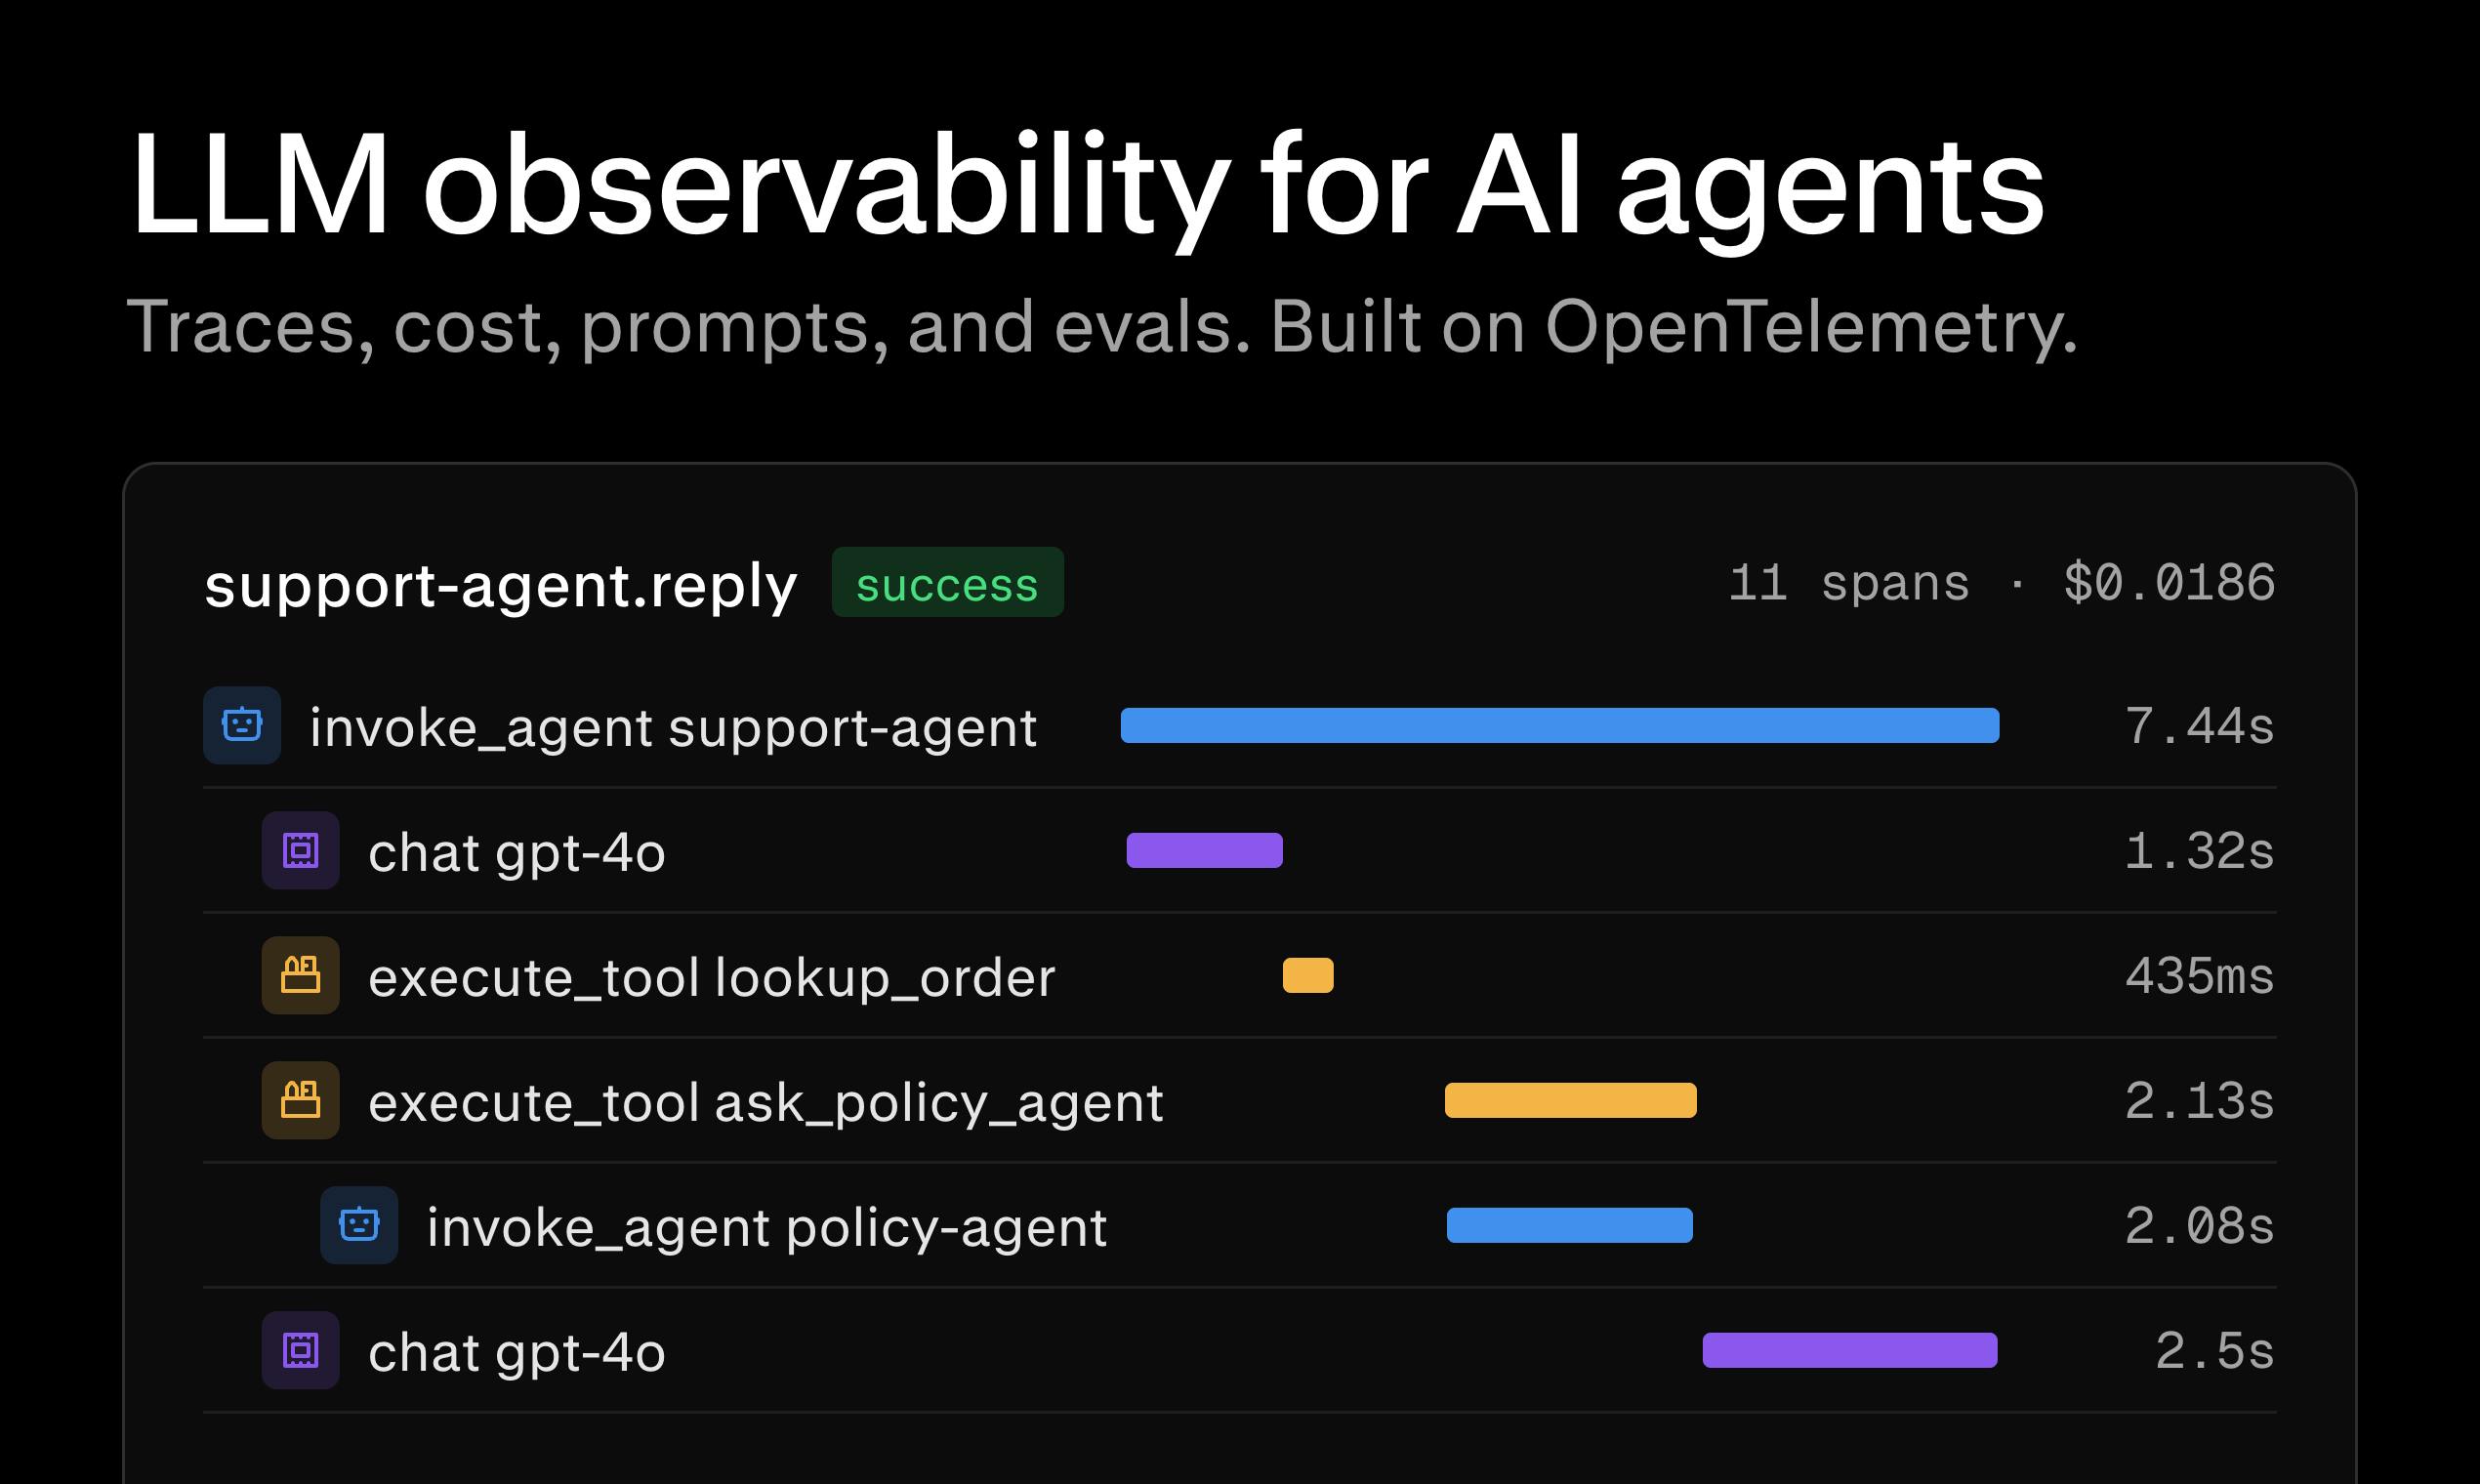
从“黑盒运行”到“白盒 Trace”
传统可观测性工具擅长处理 HTTP 请求和数据库查询,但 AI Agent 的工作流是另一回事:它可能是多轮推理、并行工具调用和条件分支的组合。telemetry.dev 的核心设计是把整次 Agent 运行映射为一条 Trace,再拆解成多个 Span。开发者可以像查看分布式追踪那样,逐层查看每次模型调用(耗时、Token、成本、错误)和工具调用(耗时、错误)的细节。
这种粒度的价值在于排障。过去遇到 Agent 输出异常,往往只能靠日志猜测;现在可以顺着 Trace 找到具体哪个 Span 出了问题,是模型超时、工具返回错误,还是循环调用。
分布式追踪与 Trace/Span 模型
Trace 和 Span 的概念源自分布式追踪系统(如 Jaeger、Zipkin)。一次完整的请求链路被建模为一条 Trace(追踪),而链路中的每个操作单元则是一个 Span(跨度),Span 之间通过父子关系构成有向无环图,从而表达调用层级与并行关系。每个 Span 通常记录开始时间、持续时间、状态与自定义属性。将这一模型迁移到 AI Agent 场景的关键在于:模型调用和工具调用天然具备“有开始、有结束、有输入输出、可能失败”的特征,正好对应 Span 的语义。因此 telemetry.dev 不需要发明新的数据模型,而是复用成熟的可观测性抽象,让开发者用已有的排障心智(逐层下钻、定位耗时瓶颈)来理解 Agent 行为。
OpenTelemetry(OTel)
OpenTelemetry 是云原生计算基金会(CNCF)主导的开源可观测性标准,统一了 Trace、Metrics、Logs 三类遥测数据的采集协议与 SDK,并提供 Exporter 将数据发送到任意后端。它的价值在于解耦“采集”与“存储/展示”:应用只需按 OTel 规范埋点,后端可以自由替换。telemetry.dev 支持 OTel exporter 接入,意味着已经用 OTel 监控基础设施的团队无需再维护一套独立的埋点体系,LLM 调用可以直接作为 Span 汇入现有管线,显著降低采用成本。
Prompt 与 Evals 复用同一套 Trace
telemetry.dev 的另一个差异化能力,是把 Prompt 管理和 Evals 评价体系统一到 Trace 之上。修改 Prompt 不需要重新部署应用——改完之后可以直接在数据集上运行,然后与生产环境的评分进行对比。
这意味着 Prompt 迭代从“改代码、重新上线、凭感觉判断”变成“改 Prompt、跑评测、拿数据对比”。对于需要持续优化 Agent 效果但不想频繁发版的团队来说,这个闭环能显著缩短迭代周期。
LLM Evals(评测)
Evals 指对大模型输出进行系统性质量评估的方法集合,通常包括基于规则的检查、与参考答案的比对,以及用另一个模型作为评判者(LLM-as-a-Judge)打分。在 Agent 场景中,Evals 需要依托真实运行数据构建数据集,才能反映生产分布下的表现。telemetry.dev 让 Evals 与 Trace 同源的设计,解决了传统评测中“离线数据集与线上流量脱节”的问题:生产 Trace 既是排障依据,也是评测样本来源,Prompt 改动后的评分还能与线上历史评分直接对照,形成可量化的回归判断。
告警:错误、成本飙升与 Agent 循环
telemetry.dev 提供内置告警机制,覆盖三类问题:错误、成本飙升和 Agent 循环(agent loops)。Agent 循环是 AI Agent 场景里特有的风险——模型可能会在某个逻辑上反复调用工具而无法收敛,如果没人盯着,账单会快速上涨。把循环检测放进告警里,说明团队对 Agent 的运行时风险有清醒认识。
成本告警同样关键:LLM 的按 Token 计费模式让一次异常调用就可能产生非预期账单,实时告警让团队能在成本失控前介入。
接入方式:SDK 与 OpenTelemetry
telemetry.dev 提供 TypeScript 和 Python SDK,也支持通过 OpenTelemetry exporter 接入。后者尤其值得关注:如果团队已经在使用 OpenTelemetry 生态做基础设施监控,可以直接把现有的 OTel 管线复用到 LLM 可观测性上,降低引入新工具的迁移成本。对已经拥抱 OTel 的工程团队来说,这是比较务实的兼容策略。
产品在 Product Hunt 上获得 89 票,排名第 4,分类为 Analytics、Developer Tools 和 Artificial Intelligence,目标用户显然是构建 AI Agent 的开发者团队。
谁适合用它
telemetry.dev 适合正在生产环境运行 AI Agent、且已经遇到以下问题的团队:Agent 运行失败时难以定位具体环节;Prompt 迭代缺乏数据支撑;成本波动难以归因;希望把 LLM 可观测性纳入现有 OTel 体系。对于还在原型阶段、调用量极小的项目,这类工具的必要性会低一些。
总体来看,telemetry.dev 的思路是把 LLM 可观测性从“看日志”升级为“看 Trace + 做 Evals + 设告警”的组合能力,这种把运维可观测性经验迁移到 AI Agent 场景的做法,契合了 Agent 应用从 Demo 走向生产时对稳定性和成本控制的真实需求。
相关推荐

提示词工程入门:从写指令到系统化设计
提示词工程入门教程:详解提示词与提示词工程的本质区别、提示词的四大作用、工程化六步流程与四大目标,并系统梳理提示词在能力上限、稳定性、幻觉、上下文长度和成本方面的局限性。

GPT-6.2 Astra曝光:低配超上代顶配,SVG生成惊艳
GPT-6.2 Astra泄露基准与SVG演示曝光,最低推理档超越上代顶配;同批还有腾讯HY4、Anthropic FlashProve模型验证、DeepSeek V5昇腾路线及币安安全事件等AI行业动态。

PolicyIK:强化学习实现高精度机械臂逆运动学
PolicyIK 用目标条件强化学习实现机械臂高精度逆运动学,仿真中 93.5% 任务误差控制在 1mm 和 0.2° 内,部署协议将成功率提升至 98.9%,并可执行 VLA 策略指令。