TEMPEST:用角度间隔学习实现可扩展的驾驶员身份识别

TEMPEST 将 ArcFace 角度间隔损失引入驾驶行为识别,大幅提升车队规模扩张时的识别稳定性。
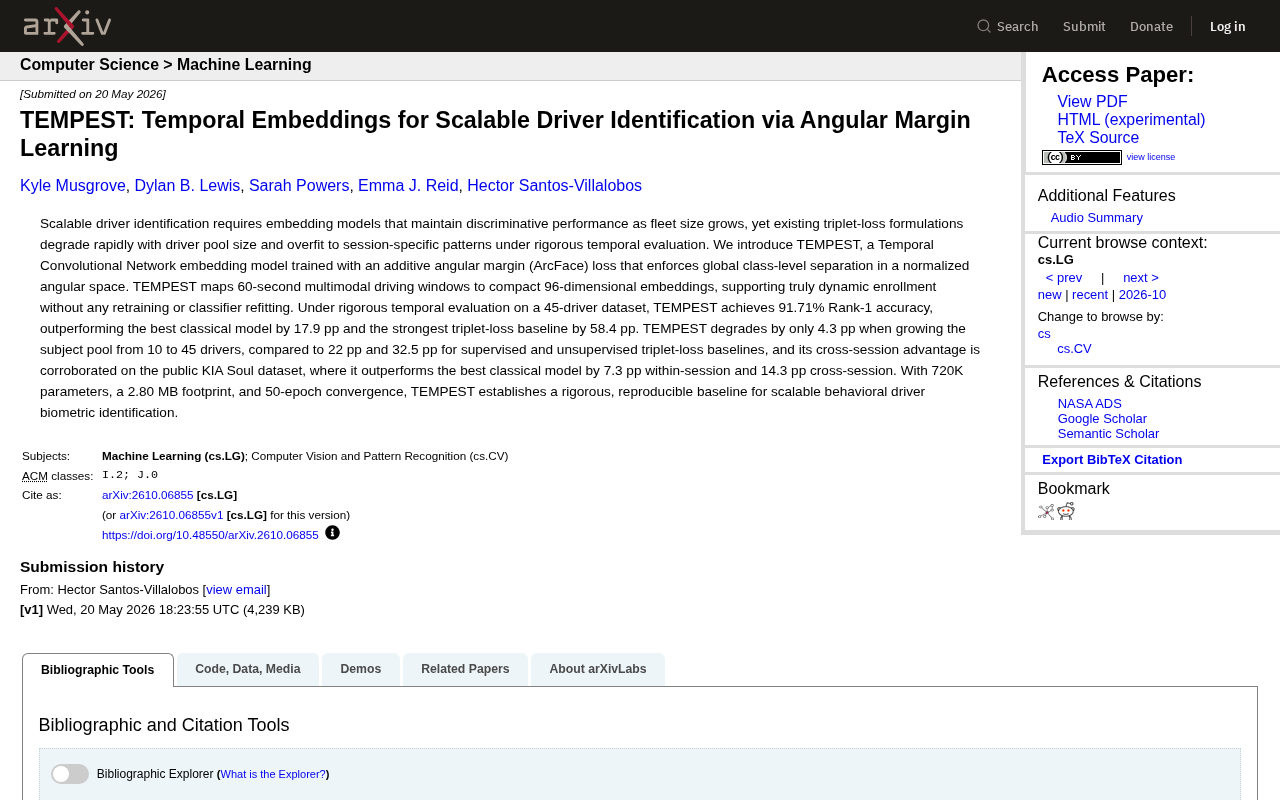
TEMPEST 是一项针对驾驶员行为生物识别扩展性问题的新研究,发表于 arXiv。其核心创新是将人脸识别领域的 ArcFace 角度间隔损失与时序卷积网络(TCN)结合,取代传统的三元组损失训练范式。模型将 60 秒多模态驾驶信号压缩为 96 维嵌入向量,支持无需重训练的动态驾驶员注册。实验结果显示,在 45 名驾驶员的数据集上,TEMPEST 取得 91.71% 的 Rank-1 准确率,比最强三元组基线高出 58.4 个百分点;当驾驶员池从 10 扩展至 45 人时,性能仅下降 4.3 个百分点,而三元组基线最高下降 32.5 个百分点。模型仅有 72 万参数,体积 2.80 MB,兼顾边缘部署的工程可行性,为车队管理、UBI 保险、防盗验证等实际应用提供了可扩展的基线方案。
驾驶员身份识别为何难以规模化
基于驾驶行为的生物特征识别,是一个颇具价值但长期受制于扩展性的研究方向。它的核心思路是:每个人的驾驶习惯——加速、刹车、转向的节奏与力度——都带有独特的行为指纹,可以像指纹或人脸一样用于身份确认。
但现实中,车队规模一旦扩大,识别模型的性能往往迅速崩塌。研究者指出,现有主流做法依赖三元组损失(triplet-loss)来训练嵌入模型,这类方法有两个硬伤:一是随着驾驶员数量增长,判别性能快速退化;二是在严格的时序评估下容易过拟合到特定的驾驶会话(session)模式,换个时间段采集的数据,模型就认不出来了。
arXiv 上新发布的 TEMPEST 工作,正是针对这一痛点提出的解决方案。它试图回答一个关键问题:如何让嵌入模型在车队扩张时依然保持稳定的区分能力?
TEMPEST 的技术路线
TEMPEST 的核心是一个时序卷积网络(Temporal Convolutional Network, TCN)嵌入模型,但真正的差异化在于它采用了**加性角度间隔损失(ArcFace loss)**进行训练。
为什么选择 ArcFace
ArcFace 最初在人脸识别领域广为人知,它的思路是在归一化的角度空间中强制类间的全局分离。相比三元组损失只关注局部的样本对关系,ArcFace 在全局层面上拉开不同类别的间隔,这正是它在大规模识别任务中优于三元组方法的关键原因。TEMPEST 把这一思想迁移到驾驶行为识别,是这篇工作的主要创新点。
从技术机制上看,ArcFace(Additive Angular Margin Loss)的核心操作是:先对特征嵌入向量和分类权重矩阵分别做 L2 归一化,使两者落在超球面上,再在它们夹角的余弦值上叠加一个固定的角度间隔 margin(通常取 0.5 �弧度),最后缩放后送入 Softmax 计算损失。这一操作使得同类样本在超球面上彼此紧密聚集,异类样本之间则被强制保持清晰的角度隔离。
与之相比,三元组损失(triplet loss)每次只处理"锚点-正样本-负样本"三元组,目标是让正对距离小于负对距离加上一个间隔值。这种局部视角在类别数少时有效,但当类别(即驾驶员)数量增多时,三元组的采样空间爆炸式增长,有效三元组占比骤降,梯度信号变得稀疏,模型难以维持全局一致的类别边界。ArcFace 因为每次迭代都通过全类别 Softmax 更新所有类中心,天然具备全局判别性,这正是它在大规模识别任务中更具优势的数学根源。
嵌入与动态注册
模型将 60 秒的多模态驾驶窗口映射为紧凑的 96 维嵌入向量。这种设计带来一个实用优势:支持真正的动态注册(dynamic enrollment)。换句话说,当车队新增驾驶员时,无需重新训练模型,也不必重新拟合分类器,直接提取嵌入即可完成注册。对于规模不断变化的真实车队部署场景,这一点价值很高。
多模态驾驶窗口通常融合来自车辆 OBD 或 CAN 总线的多路传感信号,包括纵向加速度、横向加速度、方向盘转角、油门开度、制动踏板力度和车速等。这些信号以固定频率(常见 10–25 Hz)采样,60 秒窗口在典型采样率下对应 600–1500 个时间步。时序卷积网络(TCN)通过膨胀因果卷积(dilated causal convolution)在不引入未来信息的前提下捕获长程时序依赖,相比 LSTM 类模型具有更高的并行效率和更稳定的梯度传播特性,适合处理这类多通道生理-机械行为序列。将上述序列压缩为 96 维向量后,新驾驶员注册只需一次前向推断,全程无需访问历史训练数据,这对于有数据隐私要求的车队场景同样是一个实际优势。
实验结果:扩展性是最大亮点
在一个包含 45 名驾驶员的数据集上,TEMPEST 在严格的时序评估下取得了 91.71% 的 Rank-1 准确率。这个数字本身可观,但更有说服力的是它与基线的差距:
- 比最优的经典模型高出 17.9 个百分点
- 比最强的三元组损失基线高出 58.4 个百分点
近 60 个百分点的差距,直观说明了三元组损失方法在严格时序评估下的脆弱性。
规模增长下的稳定性
真正体现 TEMPEST 价值的是扩展性测试。当驾驶员池从 10 人扩展到 45 人时:
- TEMPEST 仅下降 4.3 个百分点
- 有监督三元组损失基线下降 22 个百分点
- 无监督三元组损失基线下降 32.5 个百分点
这组对比直接印证了论文的核心论点:角度间隔学习带来的全局类别分离,在规模扩张时远比三元组方法稳健。
跨会话泛化
跨会话(cross-session)表现是驾驶员识别的另一道难关,因为同一个人在不同时间的驾驶状态会有波动。在公开的 KIA Soul 数据集上,TEMPEST 的优势得到交叉验证:会话内(within-session)比最优经典模型高 7.3 个百分点,跨会话则高出 14.3 个百分点。跨会话的优势更明显,说明模型学到的是更本质的行为特征,而非会话特定的噪声模式。
轻量化与可复现性
TEMPEST 在性能之外还兼顾了工程实用性。模型仅有 72 万参数,存储占用 2.80 MB,并能在 50 个训练周期内收敛。这样的体量对车载边缘部署友好,也降低了复现门槛。
论文将 TEMPEST 定位为「可扩展行为驾驶员生物识别」领域一个严格、可复现的基线。对于后续研究者而言,这意味着一个清晰的性能标尺,以及一套可以直接对比的评估协议。
价值与局限
TEMPEST 的意义在于把人脸识别领域成熟的角度间隔学习范式,成功迁移到了驾驶行为识别这一相对小众但实用的方向,并用严格的时序和跨会话评估证明了其在扩展性上的显著优势。对于车队管理、保险 UBI(基于使用的保险)、防盗验证等应用场景,这类无需重训练即可动态注册新用户的方案具有直接落地潜力。
当然,45 名驾驶员的规模相对实际大型车队仍然有限,论文也未深入讨论对抗性场景下(如刻意模仿他人驾驶风格)的鲁棒性。但作为一个基线工作,它为这一方向建立了可靠的参照点,后续的真正考验将是在更大规模和更复杂真实环境中的表现。
UBI(Usage-Based Insurance,基于使用的保险)是保险行业近年兴起的定价模式,其核心是用驾驶行为数据替代传统的静态因素(年龄、车型、地区)来评估风险并动态调整保费。驾驶员身份的可靠绑定是 UBI 的前提——若无法确认投保人与实际驾驶人一致,行为数据的参考价值大打折扣。TEMPEST 所提供的轻量、无需重训练的识别方案,恰好能在车载 OBD 设备或智能后视镜等边缘硬件上实时运行,为 UBI 场景下的身份持续验证提供技术支撑。此外,在商业车队管理中,驾驶员行为识别还可与疲劳监测、违规追溯等功能联动,构成更完整的驾驶风险管理闭环。
相关推荐

Cursor AI编程实战:30分钟从零构建学生管理系统
B站UP主实战演示Cursor AI编程:30分钟用自然语言生成学生管理系统。详解Agent模式、Claude模型选择、提示词技巧与使用门槛,帮你判断Cursor是否值得入手。

AI编程工具20强榜单:从夯到拉的评分矩阵
B站UP主发布AI编程工具20强榜单,从夯到拉分为T0-T4五个层级,Claude Code和Codex并列T0。本文详解评分维度(能力、可靠性、耐操性、耐久性、成本、国内可用性)及工具表现,帮助开发者选择适合的AI编程助手。

Vibe Coding系统教程:零基础玩转AI编程实战
B站UP主耗时三个月打造的Vibe Coding系统教程,覆盖Codex、ClaudeCode、Cursor等AI编程工具,从基础逻辑到商业级项目实战三段式讲解,适合零基础学习者系统入门AI编程。