腾讯混元Hy4 Flash发布:每百万Token五毛,价格战再升级
腾讯混元Hy4 Flash以每百万Token五毛的定价搅动国产大模型市场,五入口同步分发。
腾讯发布混元Hy4 Flash模型,输入每百万Token五毛、输出两块、缓存命中两分,同等工作量成本仅为上一代的二十分之一,视频称比DeepSeek同等场景便宜八倍。模型在腾讯云、元宝、企业微信、QQ、IME输入法五个入口同步可用,兼顾开发者API与C端无感调用。同期动态还包括OpenAI给研究者的Plus免费名额、Hugging Face统一调度六百多个开放权重模型、腾讯Keywin4 Max接入Versal网关、字节豆包工作台、MiniMax开放权重图像模型。安全侧,FBI披露开源黑客工具Artex已被用于真实攻击,三小时内获取最高权限。作者认为是否换模型取决于调用结构,低价之外的延迟、限流与可用性才是生产决策关键。
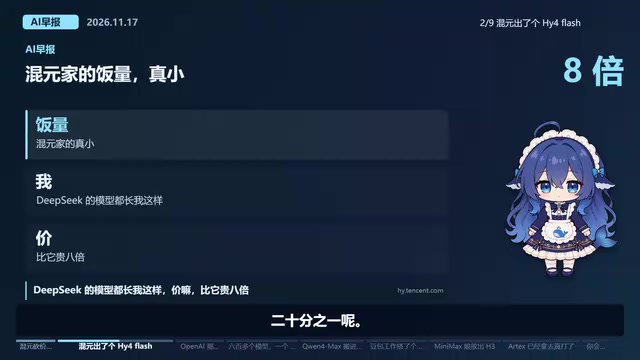
腾讯混元家族又添新成员。据B站UP主“大肥鱼AI”的早报视频,腾讯正式发布混元Hy4 Flash模型,输入价格压到每百万Token五毛钱,输出两块,缓存命中仅两分。这个定价在当下的国产大模型市场里,属于直接把桌子掀了的级别。
价格有多狠:只有上一代的二十分之一
按照视频里的说法,完成同样的工作量,Hy4 Flash的花费只有上一代模型的二十分之一。这个降幅不是靠补贴撑起来的短期促销,而是模型架构和推理效率优化后的结果。
横向对比更直观:视频中提到DeepSeek广告的模型在同等场景下比它贵八倍。换句话说,混元这次把“每百万Token五毛”做成了新的价格锚点,其他厂商要么跟,要么在性价比叙事上失声。
对于高频调用API的开发者,这意味着原本需要精打细算的批量任务——比如长文档摘要、批量翻译、客服机器人——成本压力大幅缓解。缓存命中两分钱的设定,则明显是在鼓励用户做上下文复用,适合多轮对话和固定知识库问答这类场景。
Token定价与缓存命中是理解大模型API成本的两个关键概念。Token是模型处理文本的基本单位,粗略估算一个英文单词约对应1.3个Token,一个汉字约对应1-2个Token。按输入每百万Token五毛计算,处理一部十万字的中文小说成本仅约一毛钱。缓存命中(Cache Hit)指当请求的上下文前缀与之前请求完全相同时,服务端可直接复用已计算的KV缓存,无需重新推理,因此单价可低至两分钱。这一机制对多轮对话、固定系统提示词、知识库问答等前缀重复度高的场景收益最大;而每次请求内容都不同的批量任务则难以享受缓存折扣,评估成本时需区分这两类负载。
五个入口齐上,不只是API的事
Hy4 Flash的另一个看点在于分发渠道:腾讯云、元宝、企业微信、QQ、IME输入法五个地方同步可用。
这个布局的思路很清楚——API价格战打的是开发者心智,而元宝、企业微信、QQ、输入法触达的是普通用户和B端办公场景。输入法接入尤其值得注意,输入法是最贴近用户日常输入行为的入口,把模型能力塞进这里,意味着混元在尝试把“调用大模型”变成一件用户无感的事情。
同场加映:研究者的免费额度与开源生态变化
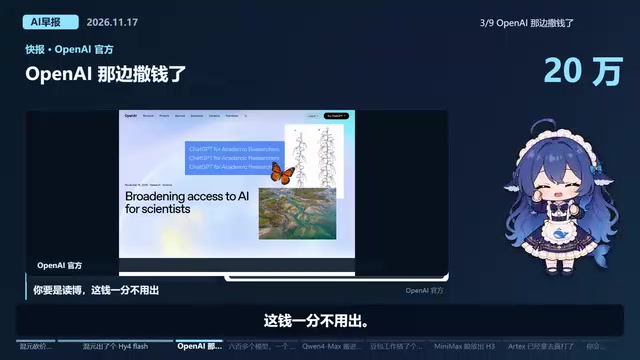
这期早报里还有几条值得留意。OpenAI面向研究者的Plus免费名额本轮先放五万个,一个人能带两个,先到先得,博士生可以一分钱不花。
Hugging Face把六百多个开放权重模型的调度统一交给了OpenMoodle,一个Token一套接口,换模型不用重新配置,而且开放权重模型平均比闭源便宜四倍。这个变化对做模型选型和A/B测试的团队很实用——过去换模型要改代码、对接口、重新压测,现在收敛到一套调度层,迁移成本明显下降。
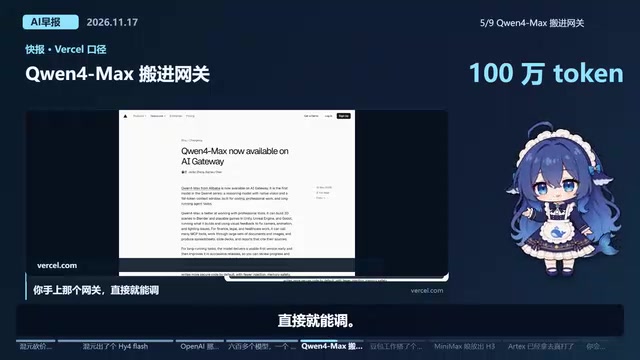
腾讯自家的Keywin4 Max也搬进了Versal网关,支持一百万Token上下文和原生视觉能力,手上已有的网关直接就能调。
字节这边给豆包搭了个工作台,投了一批二十一个专业场景,金融方向接了万德、同花顺、国泰海通。场景覆盖听起来很全,但视频作者的吐槽也有意思:二十一个场景里没有一个跟做饭相关,所谓“专业”的标准值得再琢磨。
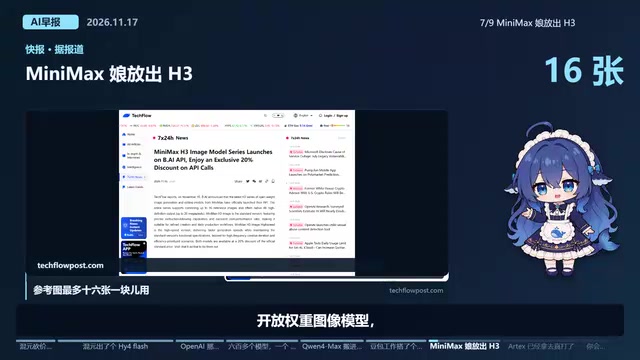
MiniMax的200H3开放权重图像模型也放出来了,能生成能编辑,参考图最多十六张,开放权重意味着可以自己部署。
**开放权重模型(Open-Weights Model)**是指厂商公开发布模型参数权重、允许用户自行下载部署的模型,与仅提供API访问的闭源模型相对。它不等同于完全开源——训练数据、训练代码未必公开,许可证也可能对商用设限。开放权重的核心价值在于可私有化部署:数据不出内网、可针对特定任务微调、不受API限流与涨价影响,适合对数据合规敏感或调用量极大的团队。代价是需要自行承担GPU推理成本与运维工作,小规模使用时反而不如按量付费的API划算。文中提到的平均便宜四倍,通常指同等调用量下自建推理与闭源API的费用对比,且高度依赖硬件利用率和批处理优化程度。
模型网关与统一调度层的作用值得单独说明。不同厂商的API在鉴权方式、请求格式、参数命名、流式返回协议上各不相同,团队每换一个模型往往要改代码、重配密钥、重写压测脚本。网关层把这些差异抽象成统一接口,业务代码只面向一套协议编写,后端切换模型只需改配置。这类方案还能顺带实现多模型路由(按任务难度分流到贵/便宜模型)、失败自动降级、统一计费与日志审计。对做A/B测试的团队,统一调度意味着可以并行调用多个模型对比效果而无需维护多套客户端,显著降低选型试错成本。
安全侧的一条警示
FBI披露了一个叫Artex的开源AI黑客工具已经被用于真实攻击,目标包括美国一家IT公司和韩国金融业,不到三小时就拿到了最高权限。开源工具谁都能下载,攻击门槛被拉低,这条对任何跑线上服务的团队都是提醒:默认配置、弱口令、未修补的漏洞,在自动化工具面前撑不了多久。
自动化攻击工具降低门槛是当前AI安全讨论中的核心议题之一。传统渗透测试需要攻击者具备较深的系统知识,而基于大模型的攻击工具能自动完成信息收集、漏洞识别、利用链编排等步骤,把原本需要数天的工作压缩到数小时。文中所说的"不到三小时拿到最高权限",典型路径往往是从暴露在公网的服务入手,利用默认口令、未修补的已知漏洞或错误配置逐步横向移动。对线上团队的直接启示是:资产清点、及时打补丁、强制强口令与多因素认证、最小权限原则这些基础工作,在自动化攻击面前优先级被进一步放大,而非被AI新技术取代。
换不换模型,取决于你的调用结构
回到那个问题:价格出来后,要不要把默认模型换掉。
如果业务以大规模文本处理为主、对极致推理能力要求不高,Hy4 Flash的成本优势很难忽视。如果任务涉及复杂agent编排或长链条推理,价格只是决策变量之一,还得看稳定性、上下文能力和工具调用表现。视频作者的态度倒是洒脱——换不换都行,关键是算清楚自己的账。
价格战打到这个份上,受益的短期是开发者,长期则取决于厂商能不能在低价之上持续交付可靠的服务。五毛钱一个百万Token听着诱人,真正跑起生产负载时,延迟、限流、可用性这些不写在价目表上的东西,才是决定去留的关键。
相关推荐

Gemini 4 Neon发布:前沿智能与高效任务执行的平衡之作
Google DeepMind 发布 Gemini 4 Neon,主打前沿智能与快速端到端任务执行。本文解析其在编程、企业分析、科学推理与网络安全上的基准表现、四档思考等级、定价与安全对齐数据。

AI是全球断网元凶?NSA、FAA接连宕机背后的信任危机
NSA机密网络五天内第四起重大故障,微软称软件bug、FAA否认新AI系统有关、NSA称例行维护。参议员沃纳提出AI加速漏洞发现导致仓促修复的另一种解释,而39%美国人对AI的负面看法让信任危机浮出水面。

机器人开发者自研B-rep内核,测试达3487项
机器人开发者自研B-rep几何内核并编写3,487项测试,探讨机器人领域为何需要专用CAD工具,以及自研内核的机遇与门槛。