腾讯混元Hy4正式发布:跑分近乎全面领先,新增视觉与电脑操作能力

腾讯混元Hy4正式版发布,首增视觉与电脑操作能力,跑分进入国内第一梯队但高难度任务仍存短板。
腾讯混元Hy4正式版发布,官方称其首次跻身最强开源模型之列。相比预览版,Hy4扩大了预训练与后训练规模,并首次加入视觉能力与电脑操作能力,在指令遵循、长文本理解、长程任务处理和深度研究等维度明显提升。12项跑分显示其基本领先或持平DeepSeek与Kimi,仅Terminal Bench Science 0.1大幅落后K3.1 Pro。科研实战中,Hy4找到多个数学猜想的反例并完成小鼠胚胎三维重建。安全方面采用防守性数据训练,未发现突出网络攻击风险。定价每百万tokens输入6元、输出18元、缓存命中0.3元,高于DeepSeek。第三方评测尚未出炉,实际体验仍待检验。
腾讯混元Hy4正式版终于落地。官方声称这是混元模型第一次跻身最强开源模型之列。相比预览版,Hy4进一步扩大了预训练与后训练的规模,并首次加入视觉能力,在指令遵循、长文本理解、长程任务处理和深度研究等维度均有明显提升。
从B站UP主整理的12项跑分来看,Hy4基本领先或持平DeepSeek广告与Kimi,仅在Terminal Bench Science 0.1中大幅落后于K3.1 Pro,整体跑分进入国内第一梯队。
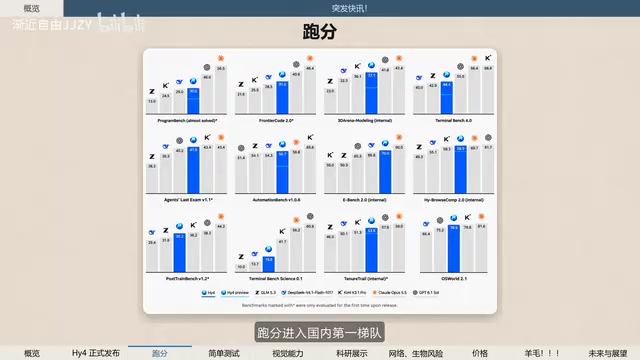
跑分解析:Agent亮眼,但高难度编程与科研仍是短板
官方跑分显示Hy4在Agent类任务上表现突出,这与当前行业对智能体执行能力的重视方向一致。不过UP主也直言,其在“高难度编程和科研能力上仍有明显短板”,并提醒“后续看实际使用体验吧,别又是一个刷分王”。
目前公开的只有官方跑分,第三方评测如Artificial Analysis和Arena的成绩尚未出炉。UP主放出的几组简单测试合集显示,实际体验“好像不如DeepSeek”,但仍需等待更权威的独立评测验证。
Terminal Bench Science 0.1 是一个面向科研场景的终端操作基准测试,要求模型在模拟的 Linux 终端环境中完成与科学计算相关的多步骤任务,例如安装依赖、运行脚本、解析实验数据等。它同时考察命令行熟练度、长程任务规划与错误恢复能力,因此常被用来衡量模型的 Agent 执行水平。Hy4 在该项上大幅落后于 K3.1 Pro,说明其长程终端任务中的稳定性与工具链使用仍有明显提升空间。
Artificial Analysis 与 Arena(即 LMArena) 是两个常被引用的独立评测来源。前者以标准化 benchmark 组合给出综合能力与价格效率排名,后者则依赖真实用户对匿名模型两两对比投票形成 Elo 式排名,更贴近主观使用体验。两者与官方跑分互为补充,可减少模型方在自选测试集上的选择性报告偏差。文章强调这两项第三方成绩尚未出炉,意味着当前对 Hy4 的判断仍以官方数据为主,需谨慎看待。
视觉能力首秀:复杂图表分析与数学视觉推理
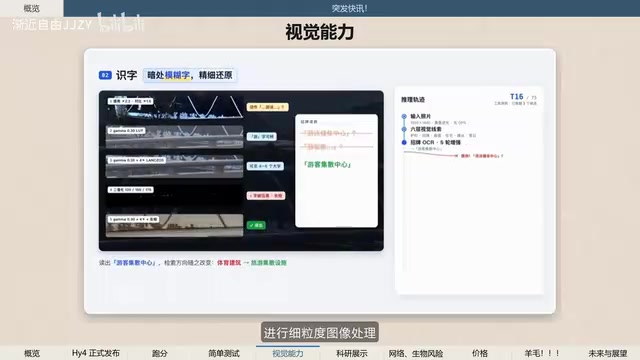
Hy4首次引入视觉能力,可结合感知、推理与工具调用进行多模态处理,覆盖复杂图表分析和数学视觉推理等任务。这一能力也让Hy4的前端与游戏开发场景显著受益——视觉理解可以帮助模型更准确地解析界面布局与设计稿。
电脑操作能力:命令行与图形界面灵活结合
Hy4首次支持电脑操作,可以灵活结合命令行指令与图形界面视觉理解完成任务。这意味着模型不再局限于文本对话,而是能像人一样操作软件界面,为自动化办公、测试等场景打开空间。
科研实战:从数学猜想到生物成像重建
在与北京大学数学团队的合作研究中,Hy4成功找到了Mandace、Pinto、Villa Real猜想的反例,并进一步提出新的条件完善了该猜想,还对相关证明进行了形式化验证。
在小鼠胚胎三维重建任务中,面对699万个细胞的84张无序二维切片,且无专用配准工具、无细胞类型标注的情况下,Hy4也完成了任务。这两项案例说明其在长程科研任务上的潜力。
形式化验证 指将数学命题及其证明翻译为 Lean、Coq 等证明助手的可检查语言,由机器逐步验证每一步推理是否合法。它能排除人工证明中的隐含假设与笔误,但要求命题本身可被精确形式化。Hy4 对猜想相关证明进行形式化验证,表明其不仅能生成自然语言论证,还能产出可被证明助手接受的代码,这是评估模型数学严谨性的重要信号。
安全与定价:防守性数据训练,价格高于DeepSeek
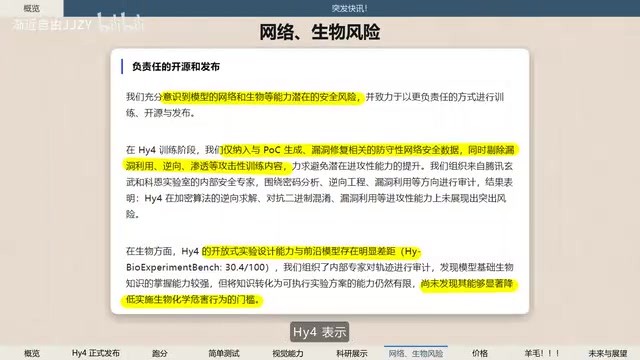
安全方面,Hy4表示训练时只使用了防守性的网络安全数据,剔除了漏洞利用、渗透等攻击性内容,经安全专家审计,模型在网络攻击能力上没有展现出突出风险。生物安全方面,Hy4虽掌握较强基础知识,但将知识转化为可执行实验方案的能力有限,未发现其会显著降低实施生物化学危害行为的门槛。
定价上,Hy4每百万tokens输入6元、输出18元、缓存命中0.3元。UP主直言“这价格比DeepSeek贵太多了”,但估计实际体验差距不会太大,套餐性价比值得关注。
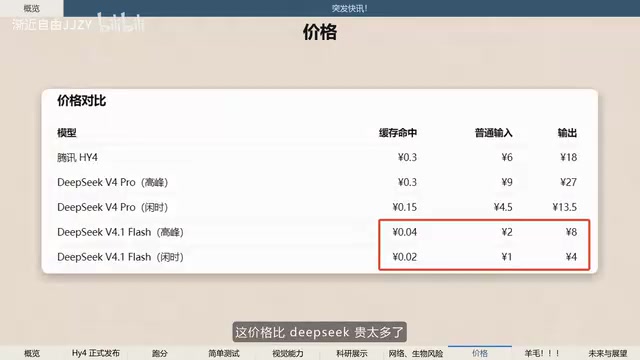
缓存命中定价 是 API 计费中的一种折扣机制:当请求的提示词前缀与近期请求高度重复时,服务端可直接复用已缓存的中间计算结果,从而以远低于正常输入的价格计费。Hy4 的缓存命中价为每百万 tokens 0.3 元,仅为正常输入价的二十分之一,适合长系统提示、多轮对话或固定文档反复查询的场景。对比价格时需结合实际缓存命中率,单看输入输出单价可能高估真实使用成本。
体验渠道与差距认知
腾讯WorkBuddy广告已正式上线Hy4正式版,11月4日至11月15日限时免费体验,UP主提醒可能需要排队。
尽管Hy4已是目前最强的开源模型之一,但其与顶尖闭源模型仍存在较大差距,尤其在内测的前沿数学、长程开发、模型迭代、视觉问答等高难度测试集上。对于开发者而言,Hy4的价值在于开源可及性与新增的视觉、电脑操作能力,而实际体验能否匹配跑分,还需第三方评测和真实场景检验。
相关推荐

Claude Sonnet 6疑泄露,Anthropic内部模型加速惊人
Anthropic疑似泄露Sonnet 6,Meter报告称其AI研发加速1.9倍;OpenAI发布GPT-6 Cyber,GPT-6.2 Astra或将至;Google Gemini Omni 1.2 Flash登顶视频生成榜;Meta stealth模型与实时头像亮相;市场波动下Google仍投170亿美元建数据中心。

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。