腾讯混元杀入开源最强:幻觉率降至5.45%,DeepSeek乌镇谈模型分级

腾讯混元4发布、DeepSeek谈开源安全、字节开源Agent模型,开源与治理同步加速。
文章汇总了当日AI领域多条重要动态。腾讯发布混元4正式版,首次加入视觉理解与电脑操作能力,内部评测幻觉率从15.76%降至5.45%,并计划近期开源,同时坦承在前沿数学等任务上与顶尖闭源模型仍有差距。DeepSeek在乌镇峰会表示开源可能放大部分安全风险,正研究模型分级,但坚持开源以加速AGI;同日中国信通院联合多家企业发布智能体发展自律公约。字节跳动开源Agent基础模型,提供35B与122B两档,训练代码与约1.8万条数据一并公开。此外还有ChatGPT家庭订阅配置曝光、印度周活用户反超美国、Oracle取消对腾讯芯片租赁协议等消息。
腾讯混元正式版发布、DeepSeek在乌镇峰会谈模型分级、字节跳动开源Agent基础模型——这一天的AI圈,开源与安全两条主线同时被推到了台前。
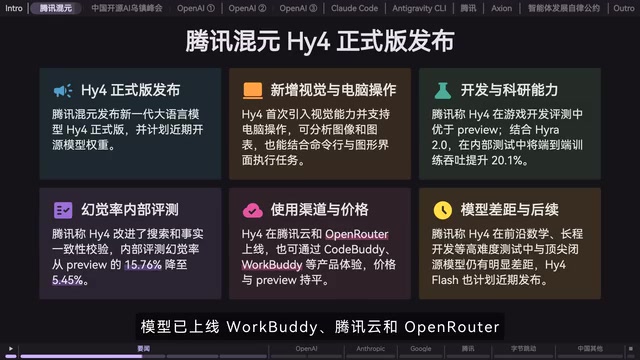
腾讯混元4:视觉与电脑操作能力首次上车
腾讯发布了大语言模型混元4正式版,这是该系列首次加入视觉理解与电脑操作能力。按照官方描述,混元4可以分析复杂图表、调用工具,并结合命令行与图形界面处理专业软件任务,覆盖开发、金融、办公和科研等场景。
最值得关注的指标是幻觉率。腾讯内部评测显示,混元4的幻觉率从预览版的15.76%降至5.45%,这个降幅在开源模型里相当可观。腾讯同时称,混元4在真实金融任务重测中位居开源模型第一。
不过腾讯自己也没有回避短板:在前沿数学、长程开发等高难度测试中,混元4与顶尖闭源模型仍有明显差距。这种表态反而比单纯堆榜单项更有参考价值——它划出了开源模型当前的能力边界。
落地节奏上,混元4已上线WorkBuddy广告、腾讯云广告和OpenRouter,并计划近期开源。主打更高性价比和更快推理速度的混元4 Flash也计划近期发布。
幻觉率是大语言模型评测中的关键指标,指模型生成看似合理但与事实不符、或缺乏依据内容的频率。常见的评测方式包括让模型回答事实性问题、总结长文档或执行多步推理,再人工或借助更强模型判定输出是否包含捏造信息。幻觉率越低,模型在金融、医疗、法律等容错率低的场景中越可靠。不过不同厂商的评测集与判定标准差异较大,跨厂商的幻觉率数字往往不可直接比较,更合理的做法是关注同一厂商内部不同版本之间的相对变化。
DeepSeek乌镇发声:开源会放大安全风险,但坚持开源
在世界互联网大会乌镇峰会上,DeepSeek研究工程师给出了一个颇为坦诚的判断:开源可能放大部分AI安全风险,团队正在研究模型分级等应对方案。
另一边,DeepSeek明确表示坚持开源是为了加快AGI到来。这两句话放在一起并不矛盾,它反映的是开源模型厂商当下共同面对的结构性难题——能力越开放,滥用面越大;但封闭又会拖慢整体进展。模型分级本质上是在两者之间找一个可操作的折中:不同能力层级对应不同的开放程度与管控要求。
这一思路与同日发布的行业自律文件形成呼应。中国信通院联合腾讯、蚂蚁、阿里、抖音等多家企业,在世界互联网大会乌镇峰会上发布了智能体发展自律公约,提出8条自律措施,覆盖智能体信任体系、互联互操作、安全防护和用户权益等方面,各发起单位将带头落实并接受社会监督。
模型分级通常指按模型能力、用途风险或开放程度对模型进行分层管理。常见做法是对能力最强或涉及敏感领域的模型设置更严格的发布审核、访问权限与使用约束,而能力较弱或通用性强的模型则相对宽松。这一思路与欧盟AI法案的风险分级框架、以及部分厂商的"渐进式发布"策略有相通之处。难点在于分级标准如何量化、由谁认定,以及开源权重一旦放出后难以回收,分级更多只能作用于发布前的准入环节。
OpenAI的双线动作:家庭订阅曝光与印度用户反超
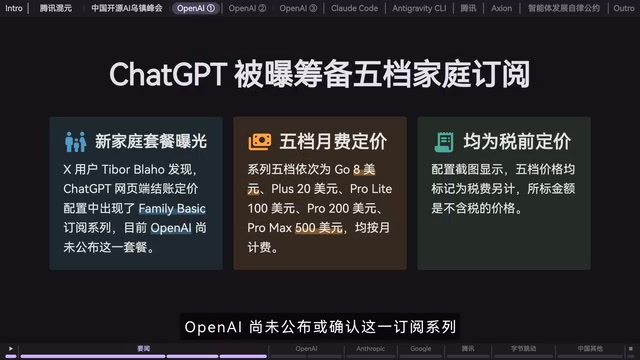
有X用户发现,ChatGPT网页端结账定价配置中出现了Family Basic系列的五档家庭订阅方案,月费从8美元到500美元不等,均为税前价。OpenAI尚未公布或确认这一订阅系列,因此这仍属于配置层面的线索而非正式发布。
另一则与订阅相关的消息是:多名用户发现,通过Google Play订阅ChatGPT Pro的用户现在可以领取API额度,入口在账单页面,有用户称需多刷新几次才显示。
用户规模方面,OpenAI印度区董事总经理表示,印度ChatGPT周活跃用户数已超过美国,甚至位居全球首位,用户数量自1月以来翻了一番。
字节跳动开源Agent基础模型,训练数据一并公开
字节跳动发布开源Agent基础模型(素材中记为Axian 1.0),提供35B和122B两个规模。团队称其训练流程只用两段监督微调加一段强化学习完成,多项基准成绩与领先的商业模型相当,训练代码和约1.8万条数据一并公开。
把训练代码与数据同时放出,比只开源权重更能推动社区复现。对Agent方向而言,数据配比和强化学习环节往往才是真正的门槛。
Agent基础模型指针对智能体任务专门优化的模型,核心能力包括多步规划、工具调用、环境交互与错误恢复,与通用对话模型的训练重点不同。其训练通常采用"监督微调+强化学习"的范式:先用专家轨迹数据教会模型基本行为模式,再通过强化学习在可验证的任务环境中优化决策策略。开源这类模型时,训练数据的质量与配比往往比参数量更能决定复现效果,因此同时公开数据与代码对社区的价值远高于仅发布权重。
工具链与产业侧:Anthropic放宽、AntiGravity升级、Oracle协议取消
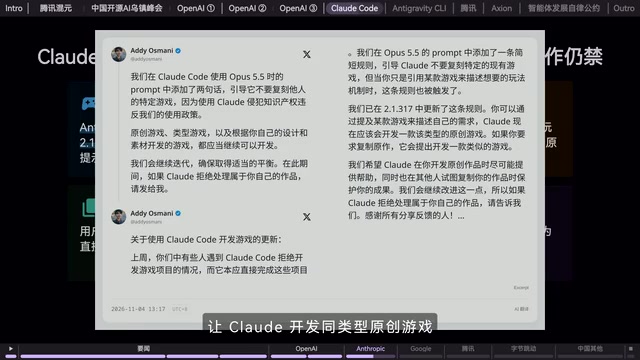
Anthropic在Claude 2.1.3(素材中记为CodeCode2.1.3)中调整了游戏开发限制:用户可以描述现有游戏的玩法,让Claude开发同类型原创游戏,不再因此被拒;若要求复制原作仍会拒绝,官方只建议开发体验类似的游戏。
AntiGravity CLI发布1.5.0版本,把MCP内置进命令行编辑器,可以直接把它当作自己的agent使用,侧边问答BTW也支持在对话中途读取文件和调用工具。
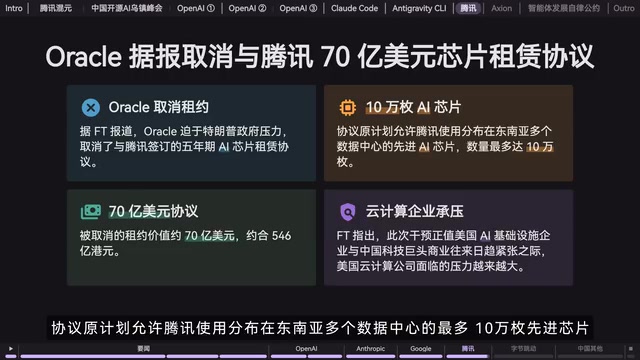
产业侧还有一则重磅传闻:据报道,Oracle迫于特朗普政府压力,取消了与腾讯签订的一份AI芯片租赁协议,价值约70亿美元。协议原计划允许腾讯使用分布在东南亚多个数据中心的最多10万枚先进芯片。
开源竞速与安全治理正在同步加速
把这几条消息放在一起看,会发现一个清晰的节奏:混元4用幻觉率的大幅下降证明开源模型的产品化能力在提升,字节跳动用训练代码加数据的全公开降低Agent复现门槛,DeepSeek则在乌镇承认开源的安全代价并推进模型分级。开源阵营在能力上加速追赶的同时,治理框架也在从企业自律层面逐步补齐。对开发者和企业来说,接下来真正需要评估的不只是榜单排名,还有模型分级落地后带来的可用性与合规成本变化。
相关推荐

Claude Sonnet 6疑泄露,Anthropic内部模型加速惊人
Anthropic疑似泄露Sonnet 6,Meter报告称其AI研发加速1.9倍;OpenAI发布GPT-6 Cyber,GPT-6.2 Astra或将至;Google Gemini Omni 1.2 Flash登顶视频生成榜;Meta stealth模型与实时头像亮相;市场波动下Google仍投170亿美元建数据中心。

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。