腾讯开源世界模型Hy-Nomas:试玩、原理与部署指南
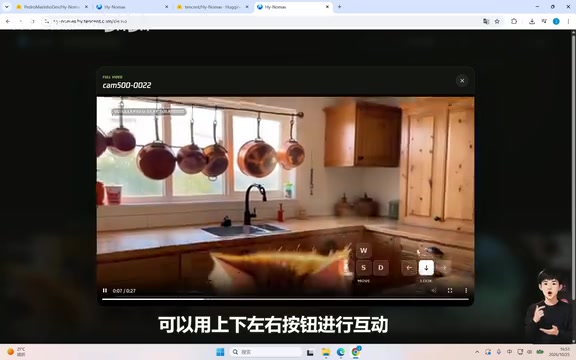
腾讯混元开源世界模型Hy-Nomas实测:分段自回归实现无缝长视频生成,单卡4090可部署。
本文基于B站UP主“我不吃番茄”的实测视频,梳理腾讯混元开源世界模型Hy-Nomas的表现、原理与部署要点。实测显示,模型在场景切换与多段提示词续接时衔接自然,生成质量与官方Demo接近,并支持文本提示词与相机控制两种交互方式。技术上,Hy-Nomas通过分段自回归生成与KV Cache维持时间连贯性,由Qwen2.5-VL-7B语言模型、DiT视频扩散Transformer和Pixel UMM解码器三部分组成。部署方面,官方标准方案需八卡并行,但借助INT8量化DiT、FP8解码器与CPU offload可在单张RTX 4090上运行,不过编译依赖问题较多,建议使用社区镜像降低门槛。
腾讯混元团队近期开源了一款名为Hy-Nomas的世界模型,在AI社区引发了不少关注。B站UP主“我不吃番茄”在实测后给出了相当高的评价,称其为自己了解到的“最强世界模型”。本文基于该UP主的实测视频,梳理Hy-Nomas的实际表现、技术原理以及本地部署的关键信息。
实测表现:无缝衔接的交互式生成
UP主在官方Demo平台进行了多轮测试。从官方示例来看,场景切换时画面衔接没有明显的卡顿或“跳帧”感,海底、室内等不同场景的过渡相当自然。UP主特别提到,自己实测生成的效果与官方Demo“相差无几”,没有太多质量落差。
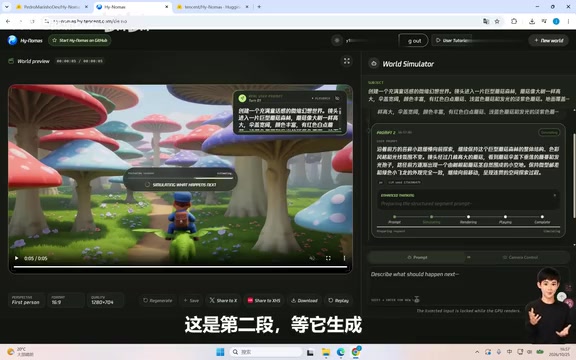
实际测试中,UP主用GPT辅助编写提示词,输入环境描述和对象描述后点击生成。首段视频约5秒,生成耗时在30秒左右(基于高性能GPU推理)。随后继续输入第二段提示词让场景“往前探索”,生成约8秒内容,与前一秒画面实现了无缝衔接,周边场景的过渡也很自然。
除了文本提示词生成,Hy-Nomas还支持相机控制模式。用户可以通过上下左右按钮控制视角方向,系统会录制操作轨迹后据此生成对应视角的视频。UP主尝试向右移动并向上抬视角,生成结果基本还原了操作意图。
核心原理:分段自回归与KV Cache
Hy-Nomas实现连续长视频生成的关键在于“分段自回归生成”策略。模型将一段较长的视频拆分为多段依次生成,后一段的生成以前一段的内容作为上下文条件,从而实现时间上的连贯性。
其中用到的重要技术是KV Cache(注意力机制中的键值缓存)。可以将其理解为模型对“视频上下文”的记忆机制——生成后半段时,模型会基于前半段已生成的内容进行条件约束,避免场景突变。
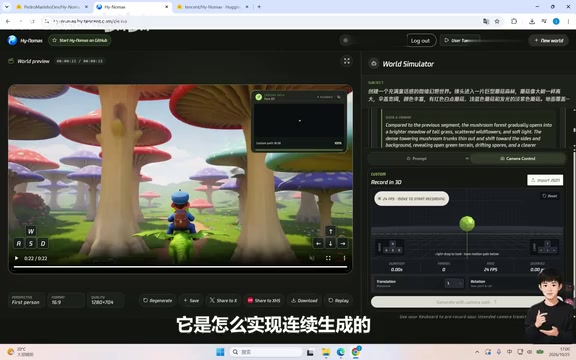
架构上,Hy-Nomas由三个主要部分组成:语言模型负责理解输入的文本提示,采用的是Qwen2.5-VL-7B;DiT(视频扩散Transformer)负责视频帧的生成;解码器则使用Pixel UMM,对视频潜空间进行压缩解码,以降低高分辨率生成对显存的压力。
此外,官方Demo中还包含一个PE(提示词优化)环节,将用户输入的自然语言提示转化为模型更易理解的结构化描述。该模块也可以自行部署到本地使用。
自回归生成是序列生成模型的一种基本范式:模型每次只预测序列中的下一个元素,然后将该预测结果作为输入的一部分,继续预测后续元素,如此循环。GPT等语言模型正是以逐token自回归的方式生成文本。将其迁移到视频生成时,基本单位从token变为视频片段(若干帧),模型在生成第N段时,会把前N-1段的内容作为条件上下文,从而在时间维度上延续场景、物体与运动状态。这种做法避免了一次性生成整段长视频所带来的显存爆炸与一致性难题,但也会带来误差累积的风险——前段生成的偏差可能被后段继承放大,因此上下文编码与缓存管理成为关键。
DiT(Diffusion Transformer) 是将扩散模型与Transformer架构结合的视频/图像生成主干。传统扩散模型多采用U-Net作为去噪网络,而DiT用Transformer替换U-Net,把带噪的潜空间特征切分成patch序列,通过自注意力建模全局依赖。Transformer的Scaling特性使其在参数量和数据量提升时表现更优,也更便于与文本编码器做跨模态条件融合,因此成为Sora之后视频生成模型的主流选择。文中提到的INT8量化DiT,即把DiT权重从FP16压缩到8位整数,以显著降低显存占用和推理开销,代价是可能带来轻微的质量损失。
部署要点:显存优化与实操建议
显存是许多开发者关心的门槛。官方标准推理方案需要八卡并行,但也提供了单卡优化版本。据UP主介绍,官方给出的参考显卡为RTX 4090,优化手段包括使用INT8量化的DiT模型、FP8版本的视频解码器,以及CPU offload策略,使得在单张4090上运行成为可能。
UP主坦言本地部署过程“相对麻烦”,遇到了flash-attention编译失败、头文件缺失等问题,建议直接使用现成的镜像部署。UP主已将模型部署到某算力平台,并在应用中心提供了镜像(搜索“我不吃番茄”相关后缀),同时整理了飞书文档说明具体使用方式。
需要留意的是,UP主本地测试时未启用提示词优化模块,分辨率也略低于官方Demo(约720p),因此生成质量可能略有折扣。使用官方Demo平台时,用户较多时需要排队等待。
CPU offload 是一种显存优化策略:在推理过程中,将部分暂时不参与计算的模型权重或中间张量从GPU显存转移到主机内存(CPU侧),待需要时再调回GPU。由于CPU与GPU之间的数据传输带宽远低于显存带宽,offload通常会拉长单步推理时间,但能大幅降低峰值显存占用,使大模型在消费级显卡上运行成为可能。配合INT8量化的DiT与FP8解码器,三者共同构成了文中“单张4090可跑”的显存优化组合。FP8指8位浮点格式,相比INT8保留了浮点动态范围,常用于对数值精度更敏感的解码环节。
应用前景与观察
世界模型的价值在于对物理环境和空间关系的建模能力。从UP主的分析来看,Hy-Nomas的潜在应用方向包括VR内容制作、游戏开发中的3D场景构建、建筑仿真以及无人机/无线场景模拟等。
从图像模型、视频模型到世界模型,开源社区可玩的模型类型正在快速扩展。腾讯混元团队在3D和视频生成领域已有积累(此前的混元3D、混元视频1.1等),Hy-Nomas可以视为其在空间智能方向的一次延伸。UP主也在视频中透露,腾讯方面还有更多世界模型相关发布在筹备中。
对于想要尝鲜的开发者,建议先从官方Demo体验效果,再根据自身硬件条件决定是否本地部署。单卡4090方案虽然可行,但编译和依赖问题需要一定耐心,使用社区镜像能显著降低上手成本。
相关推荐
MCP 是什么?让 AI 接入所有工具的开放标准
MCP(Model Context Protocol)是让 AI 应用统一接入各类工具的开放标准。本文解析 MCP 的 Host、Server、Client 三角色,Tools、Resources、Prompts 三构建块,一次工具调用的完整链路,以及在 n8n 中的双向用法与安全风险。
MCP图解:AI Agent如何连接你的应用
MCP图解:AI Agent如何连接你的应用
从电商客服机器人场景出发,图解MCP(Model Context Protocol)如何解决AI应用与外部工具的M×N集成困境,对比REST API直连的缺陷,解析Tools/Resources/Prompts三大原语、Host-Client-Server三层架构、stdio与streamable HTTP传输,以及认证授权、凭证管理与prompt injection防护要点。
CodeMode:让AI代理写代码代替调用工具,token成本直降90%
探索CodeMode如何让AI代理通过编写代码在沙箱中执行,替代传统逐个调用工具的方式,从而减少token消耗高达90%,并分析其实现要点与适用场景。