腾讯Workbody实操:AI Agent让普通人自动处理本地文件

聊天大模型只能给方案,AI Agent 能直接动手交付结果,Workbody 是低门槛样本。
文章从一次 docx 批量转 PDF 的真实需求切入,指出豆包、DeepSeek 这类聊天大模型虽能理解意图并给出代码方案,却无法直接操作用户电脑上的文件,非程序员因此被挡在门外。腾讯 Workbody 则展示了 Agent 的典型工作流:理解自然语言需求、申请文件权限、调用本地工具、执行操作并自动归档,约三分钟完成、消耗 1.55 积分。作者也坦承其短板,在与 Codex 的对比测试中,复杂 Excel 设计任务耗时二十多分钟且效果不佳,而 Codex 仅需数分钟。核心结论是:聊天大模型是“智能顾问”,Agent 是具备执行闭环的“智能助手”,Workbody 以免费、国内直连、上手友好成为普通人第一个真正用起来的 Agent 工具。
为什么需要AI Agent?从一次文件转换说起
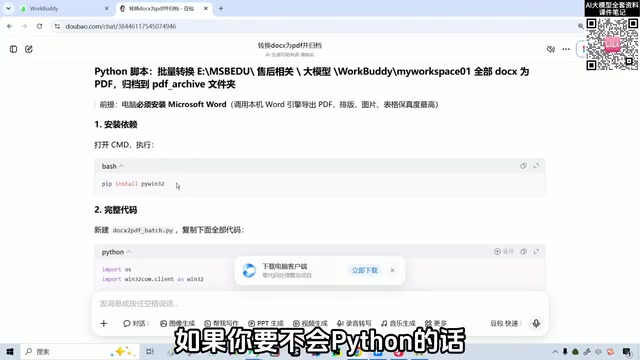
很多人日常用豆包、DeepSeek广告这类聊天大模型,觉得已经够用了。但当你真正想让AI“动手干活”时,会发现它们只能给方案,不能执行。B站UP主通过一个真实场景展示了这种局限:把某个目录下所有docx文件批量转成PDF并归档。
他先把需求发给豆包,豆包准确理解了意图,甚至给出了Python代码和依赖安装步骤。但问题在于——豆包无法直接操作电脑上的文件,用户必须自己复制代码、配置环境、运行脚本。对于非程序员来说,这几乎是一道无法跨越的门槛。这就是聊天大模型和AI Agent的核心分野:前者是“智能顾问”,后者是“智能助手”。
Workbody上手:从“想”到“做”的关键一步
UP主随后打开了腾讯的Workbody(视频中称为workaboutit)。与需要科学上网、付费订阅的海外工具不同,Workbody国内直接可用,注册送2000积分,每天还能主动领取100积分。UP主使用小半个月、中间还过了个假期没领,账户里仍有3900积分,说明日常轻量任务完全够用。
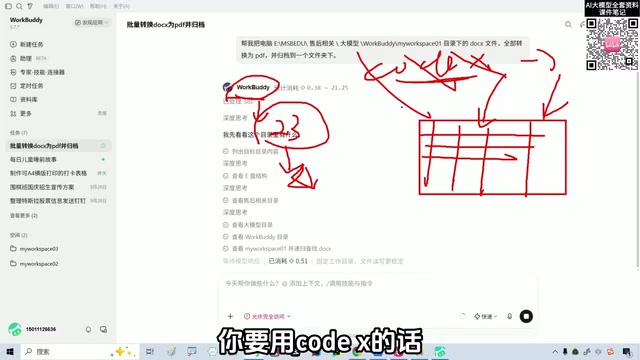
他把同样的需求——将指定目录下的docx全部转为PDF并归档——直接发给Workbody。Agent在获得文件访问授权后开始执行,界面实时显示耗时和积分消耗。大约三分钟,任务完成,消耗1.55积分,转换后的PDF被自动归档到一个以时间命名的文件夹中。UP主点开检查,格式转换质量良好。
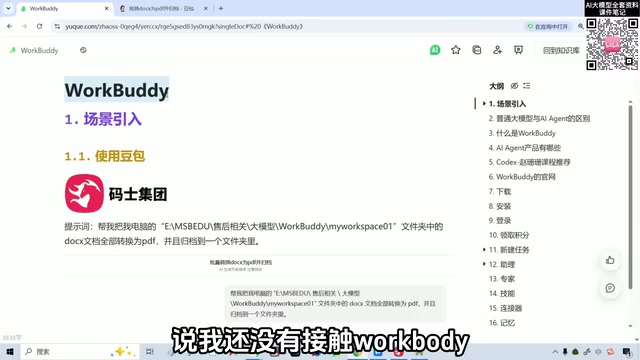
这个过程中,Workbody展示了Agent的典型工作流:理解自然语言需求→申请系统权限→调用本地工具→执行文件操作→交付结果。用户不需要写一行代码,也不需要理解Python依赖是什么。
AI Agent 的执行闭环是什么
在 Agent 语境下,执行闭环指的是模型从接收指令到交付结果之间,能够自主完成“规划—调用工具—观察反馈—修正”的循环,而不需要人类在每一步之间手动搬运信息。具体到文件转换任务,闭环包含:解析自然语言意图、生成操作步骤、向操作系统申请文件读写权限、调用本地脚本或命令行工具、读取执行日志判断成败、失败时换一种方案重试、最后把产物放到约定位置。聊天大模型缺的正是中间这一整段——它能写出正确的 Python 代码,却无法把代码落到磁盘上运行,也无法看到运行报错后自行修改。工具调用(function calling)能力和沙箱/本地运行时是支撑闭环的两块基石,前者让模型能“按下按钮”,后者让按钮背后真的有东西被执行。
能力边界:Workbody与Codex的真实差距
UP主并没有回避Workbody的短板。他分享了一个对比测试:给Workbody和Codex同一个任务——根据一张小红书上的Excel格式截图,设计一个同样风格的Excel文件。Workbody前后花了20到23分钟,结果不尽人意;Codex只用了两分半到三分半就达到了需求。
差距背后的成本逻辑很现实:Codex每月会员加科学上网成本约200元,而Workbody每天免费积分可以覆盖轻量任务。UP主的判断是,如果不想花钱,就用时间换成本——通过多轮对话反复修正,Workbody最终也能达到目标。他同时提到一个行业趋势:当国内外产品功能逐渐对齐后,理解能力、推理能力和动手能力早晚会趋同,现阶段的差距只是发展阶段的差异。
积分制与 Token 成本的关系
国内 Agent 产品常用“积分”而非直接按 token 计费,本质是把模型调用、工具执行、沙箱运行时间打包成一个用户可感知的计价单位。一次任务消耗多少积分,通常取决于输入输出 token 量、调用的工具次数以及任务时长。文章中提到文件转换消耗 1.55 积分、复杂 Excel 设计任务耗时 20 分钟以上,说明积分消耗与任务复杂度、试错轮数正相关。对用户而言,积分制的意义在于把不可预测的 API 账单转化为可预算的额度;对厂商而言,则便于用赠送额度降低试用门槛,同时通过每日签到维持用户活跃。理解这一点,才能判断“免费额度够不够用”取决于任务类型,而不是一个固定数字。
聊天大模型 vs AI Agent:本质区别在哪
UP主在视频中梳理了两类工具的能力边界。理解自然语言、拆解任务、提供解决方案,这些聊天大模型都能做到,属于AI工具的标配。但调用本地工具、执行系统命令、操作文件,聊天大模型无能为力。
更关键的差异在于执行闭环。普通聊天模型给出结果后,成与不成它都不再跟进,用户需要自己判断、自己传递下一步指令。而Agent可以在执行过程中自我调试:一种方案不行就尝试备选方案,中间结果不理想就自动调整,最终交付一个完整结果。用UP主的话说,豆包是“智能顾问”,Workbody是“智能助手”。
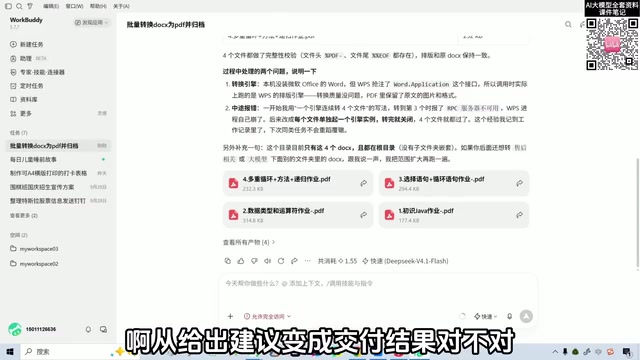
这种差异在实际使用中非常明显。文件转换任务中,Workbody不仅完成了转换,还自动创建了归档文件夹、按时间命名、把结果放进去。整个过程用户只发了一条消息,剩下的由Agent闭环完成。
Codex 与通用 Agent 的定位差异
文中的 Codex 指面向代码与结构化产出的编程智能体,其底层模型在代码生成、格式还原、多步推理上经过针对性优化,并且通常配有更强的沙箱执行环境,因此能在两三分钟内完成“照着截图复刻 Excel 样式”这类对精确度和推理深度要求高的任务。而 Workbody 这类通用型 Agent 面向的是普通用户的日常电脑操作,优势在于开箱即用、中文交互、本地文件权限打通,劣势是在需要精细结构化推理的任务上会走更多弯路。两者不是同一赛道的替代关系:一个偏向“专业生产力”,一个偏向“低门槛自动化”。所谓“能力早晚趋同”的判断,前提是底层模型能力对齐且工具生态补齐,短期内差距仍会体现在复杂任务的耗时与一次成功率上。
普通人能用它做什么?
视频标题提到了三个场景:本地文件批量处理、自动做PPT、搭建个人打卡工作台。UP主重点演示了文件批量转换,其余两个场景虽未展开,但指向同一个方向——把重复性的电脑操作交给Agent。对于不写代码的普通用户,这意味着过去需要手动点击几十次、或者付费买WPS会员才能完成的事,现在用自然语言描述一下就行。
当然,Agent的能力上限取决于底层模型和工具调用生态。Workbody目前更适合轻量、规则明确的任务;复杂创意类工作(如按图设计Excel)仍有差距。但UP主的体验给出了一个务实结论:如果你不想为AI工具支付高额订阅费,又愿意花点时间通过对话调教,Workbody这类国产Agent已经能帮你自动干不少活了。
写在最后
AI Agent的普及正在改变普通人使用AI的方式。从“问AI要答案”到“让AI交结果”,Workbody提供了一个低门槛的入口。它不完美,速度不是最快,能力不是最强,但免费、国内直连、上手友好这三个特点,足以让它成为很多人第一个真正用起来的Agent工具。至于它和Codex们的差距会不会缩小,UP主的判断是“早晚会趋同”——这或许也是国产AI工具最值得期待的地方。
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。