TensorFold:Zig 编写的跨平台 LLM 推理引擎
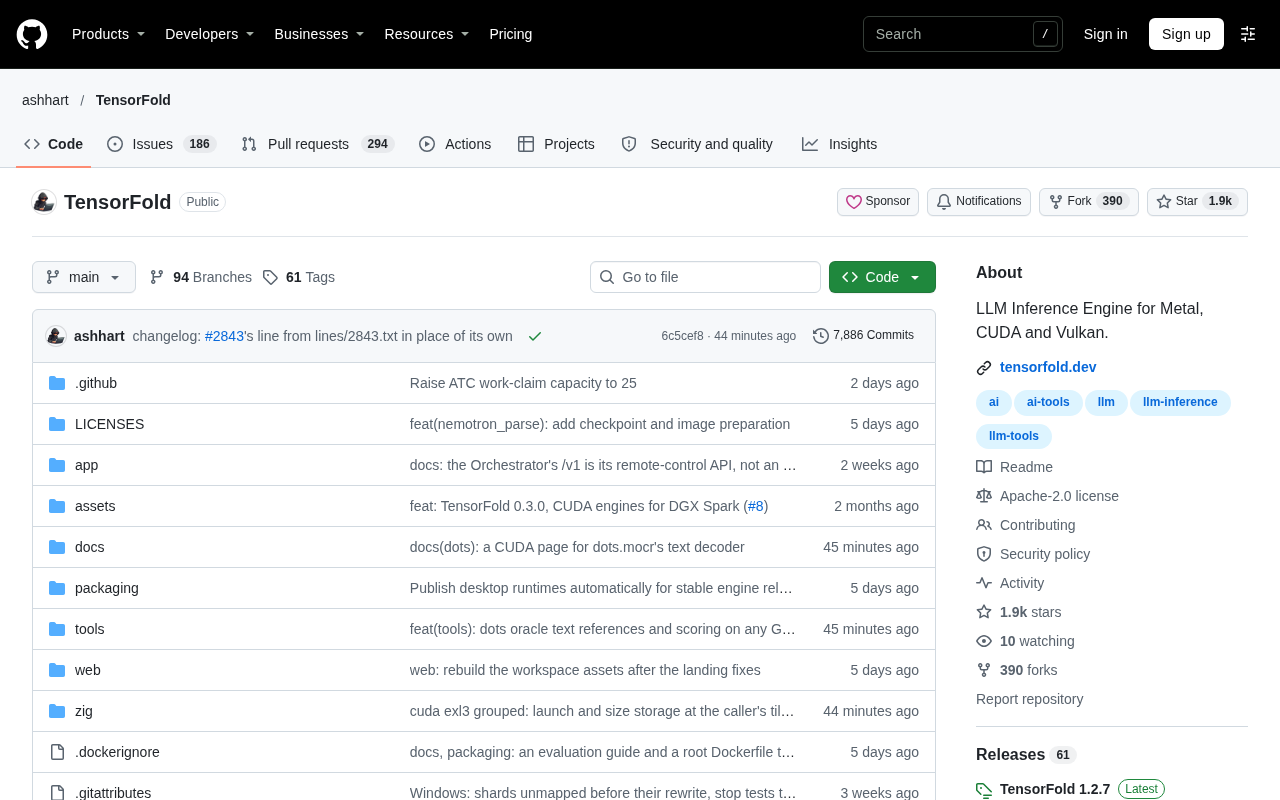
Zig 编写的 TensorFold 统一 Metal、CUDA、Vulkan 三后端,破解本地 LLM 推理硬件碎片化。
TensorFold 是一个用 Zig 语言编写的开源 LLM 推理引擎,同时支持 Metal、CUDA 和 Vulkan 三种后端,旨在解决本地大模型推理的硬件碎片化问题。Zig 的无垃圾回收、显式内存管理和编译期特化能力,使其非常适合需要低开销和跨平台编译的推理场景。项目通过分离后端抽象与算子实现,让上层调度逻辑保持统一,底层按平台替换内核,从而降低异构硬件上的部署成本。目前该项目已获得 1818 个 Star 和 385 个 Fork,社区关注度持续上升,但多后端维护的复杂度也意味着其成熟仍需时间检验。
跨平台推理的新选择:TensorFold 是什么?
在本地运行大语言模型,过去往往意味着要在 CUDA 生态里做选择——NVIDIA 显卡之外的硬件很难获得同等体验。GitHub 上的开源项目 TensorFold 试图改变这一点:它定位为一个面向 Metal、CUDA 和 Vulkan 的 LLM 推理引擎,用 Zig 语言编写,目前已获得 1818 个 Star、385 个 Fork,单日新增 58 个 Star,说明社区关注度正在上升。
从技术栈选择看,TensorFold 的野心并不隐晦。CUDA 覆盖 NVIDIA 数据中心与消费级 GPU,Metal 对应 Apple Silicon 的统一内存架构,Vulkan 则把触角伸向 AMD、Intel 以及部分移动 GPU。三者叠加,几乎覆盖了当前主流的本地推理硬件。把这三条后端统一在一个引擎里,意味着开发者不必为不同平台维护多套推理代码,模型部署的碎片化问题有望被收敛。
Metal 是 Apple 为自家 GPU(包括 Apple Silicon 芯片中的集成 GPU)提供的底层图形与计算 API,相比 OpenCL 等通用方案,它能让开发者更直接地控制硬件,因而成为 macOS/iOS 上高性能计算的首选。CUDA 是 NVIDIA 的并行计算平台与编程模型,凭借成熟的工具链和广泛的框架支持,长期占据 GPU 推理的主导地位。Vulkan 则是一个跨平台的图形与计算 API,由 Khronos Group 维护,支持 Windows、Linux、Android 等系统,并能覆盖 AMD、Intel、Qualcomm 等多种 GPU。三者分别对应不同的硬件生态,TensorFold 同时支持它们,意味着它试图用一套引擎打通原本割裂的本地推理硬件版图。
为什么用 Zig 写推理引擎?
Zig 在这个项目里不是噱头,而是与目标高度匹配的工程决策。推理引擎对内存布局、显存分配和内核调度极其敏感,任何一层运行时的隐式开销都会放大到每次 token 生成中。Zig 没有垃圾回收,提供显式的内存管理和与 C ABI 的良好互操作,便于直接调用各平台的驱动接口和计算库。
同时,Zig 的编译期能力让同一份源码可以针对不同后端做条件编译,配合 comptime 做算子特化,减少运行时分发成本。对于一个需要同时对接 Metal、CUDA、Vulkan 三套差异巨大的 API 的项目来说,这种"一份代码、多目标编译"的能力,比再引入一层抽象运行时更干净。
Zig 是一门系统级编程语言,设计上强调简单性、显式控制和与 C 生态的无缝互操作。它没有垃圾回收器,所有内存分配都需要开发者显式管理,这避免了运行时隐式开销,对性能敏感的推理引擎至关重要。Zig 的 comptime 机制允许在编译期执行代码,从而实现泛型编程和算子特化——例如针对不同后端生成专用的矩阵乘法内核,减少运行时的分支判断。此外,Zig 可以直接包含 C 头文件并调用 C 库,使得对接 CUDA、Metal、Vulkan 的官方驱动接口变得非常自然。这些特性共同构成了 TensorFold 选择 Zig 的技术合理性。
三后端架构的意义
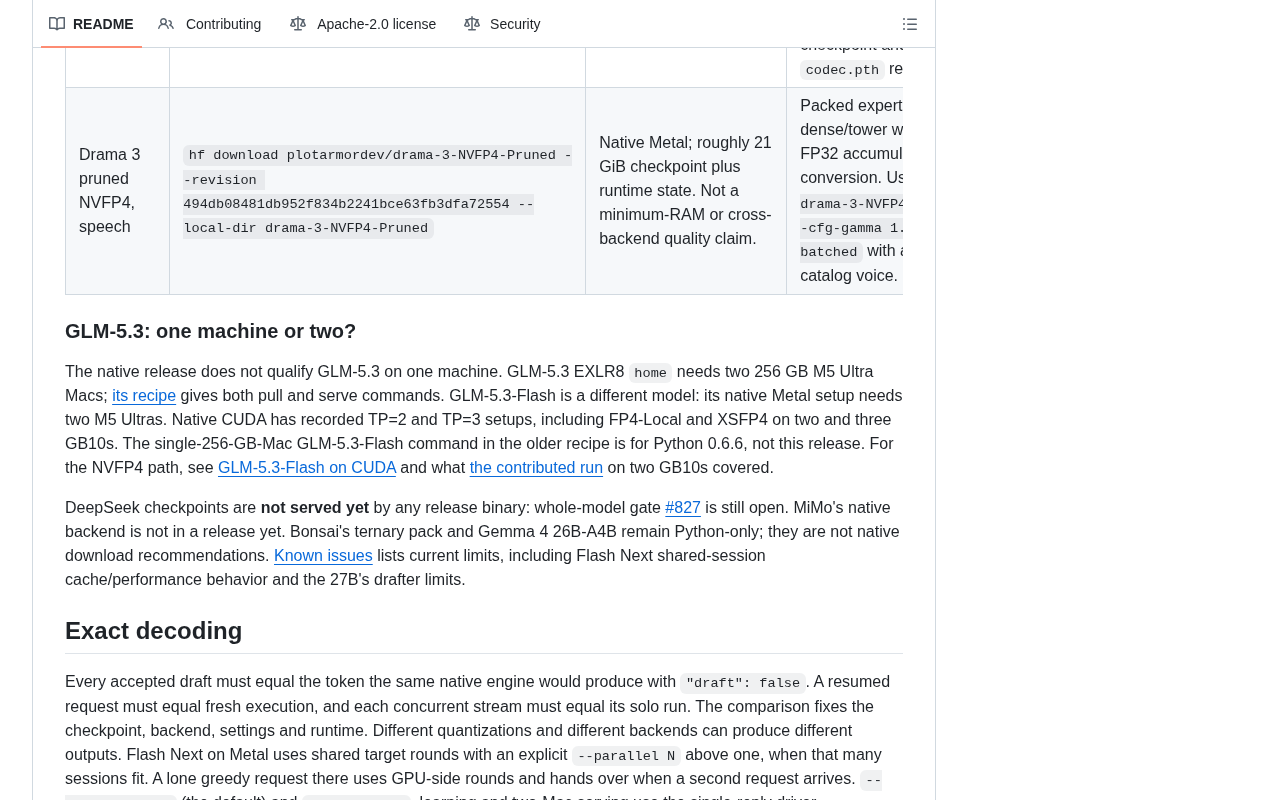
LLM 推理的跨平台难点不在模型加载,而在算子实现。矩阵乘法、注意力机制、归一化这些核心算子,在不同后端上的高效写法差异很大。TensorFold 把后端抽象与算子实现分离,理论上可以让上层推理调度逻辑保持统一,底层按平台替换内核。
这种设计对几类用户尤其有吸引力。Mac 用户长期受限于推理框架对 Metal 的支持深度,Vulkan 后端则让 Windows 和 Linux 上的非 NVIDIA 显卡有了参与本地推理的可能。对于需要把模型部署到异构边缘设备的团队,统一引擎能显著降低适配成本。不过,多后端也意味着维护负担成倍增加——每个后端的算子覆盖度、精度一致性和性能调优都需要独立跟进,这是这类项目最常见的长期挑战。
在 LLM 推理中,算子指的是构成模型计算图的基本运算单元,如矩阵乘(GEMM)、Softmax、LayerNorm、注意力机制中的 QKV 投影等。不同硬件后端对同一算子的高效实现方式差异巨大:CUDA 上可能使用 cuBLAS 或自定义内核,Metal 上需要利用 Metal Performance Shaders 或手写 Metal 着色器,Vulkan 上则要借助计算管线与 SPIR-V 着色器。因此,一个跨平台推理引擎必须为每个后端分别实现和优化这些算子,同时保持上层调度逻辑的统一。TensorFold 将后端抽象与算子实现分离,正是为了应对这种复杂性,但这也意味着每个后端的算子覆盖度、数值精度和性能调优都需要独立维护,成为项目长期发展的关键挑战。
项目现状与适用场景
从社区数据看,TensorFold 已经越过"个人实验"阶段,进入了有实际关注度的开源项目区间。1818 个 Star 和 385 个 Fork 说明已有开发者在尝试使用或二次开发。但需要明确的是,这类早期推理引擎通常在后端成熟度上并不均衡:CUDA 生态工具链最完善,Metal 和 Vulkan 的实现深度往往取决于维护者投入。
适合关注 TensorFold 的人群包括:希望在新硬件上跑通模型的研究者、需要跨平台推理方案的应用开发者,以及想研究推理引擎内部实现的学习者。如果你追求开箱即用的生产部署,成熟商业框架仍是更稳妥的选择;但如果你在意平台自由度、愿意参与早期项目共建,TensorFold 提供了一个值得跟踪的方向。
小结
TensorFold 的价值不在"又一个推理引擎",而在于它用 Zig 把 Metal、CUDA、Vulkan 三个后端放进同一个工程框架,回应了本地 LLM 推理长期存在的硬件碎片化问题。项目当前的社区热度说明这个方向有真实需求,而多后端维护的复杂度也决定了它的成熟需要时间检验。对于关注跨平台 AI 基础设施的开发者,这是一个值得加入观察列表的开源项目。
相关推荐
一个WordPress插件打通27个AI客户端
一款WordPress插件支持Claude、ChatGPT、Cursor、VS Code、Windsurf、Gemini等27个AI客户端,免费提供236项能力,Pro版额外解锁1200多项,并兼容现有页面构建器和区块。
Tricentis vs Cursor:隐私优先团队该选谁?
Tricentis 与 Cursor 该如何选?基于约六个月实测的对比分析:Tricentis 擅长企业级软件测试与质量工程,Cursor 专注 AI 辅助编码。隐私敏感团队需重点核查数据保留政策、访问控制与部署合规性,本文给出选型决策清单。
情绪如何塑造学习?神经科学家揭开意义构建的真相
神经科学家Mary Helen Immordino-Yang在Huberman Lab节目中揭示情绪如何驱动学习与意义构建,批评西方教育体系将情绪引向成绩而非观念,呼吁以人的发展取代学习结果作为教育目标。