Tetriz Harness:把团队经验变成Agent配置

开源工具 Tetriz Harness 试图把个人 Agent 调优经验变成可诊断、可分发的团队资产。
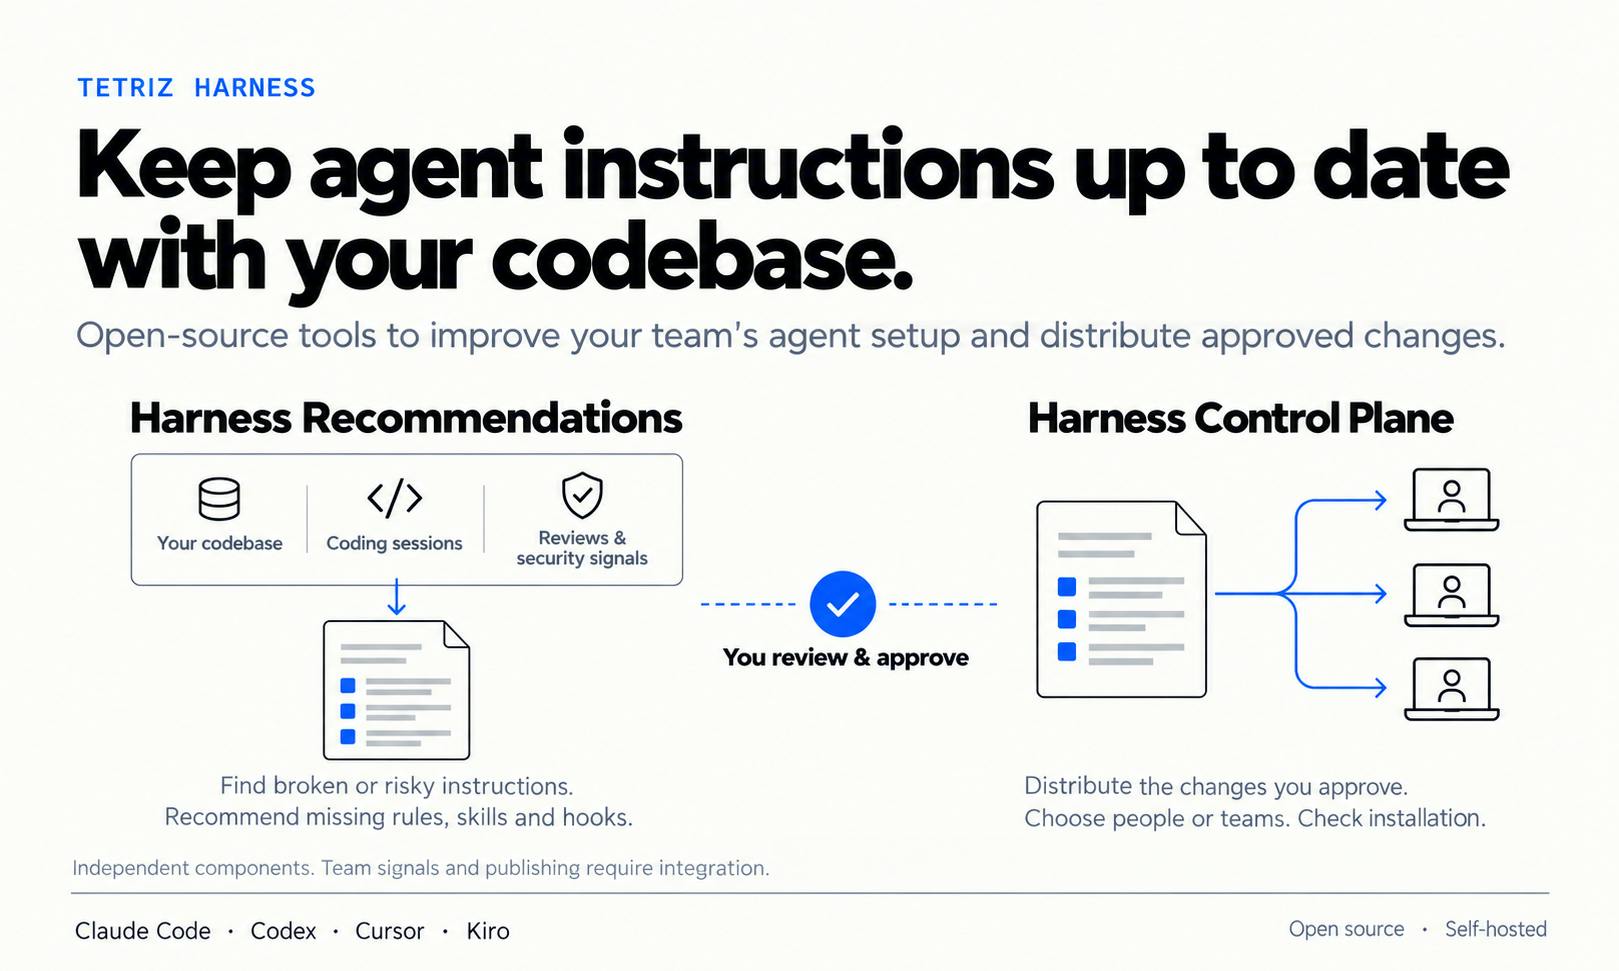
Tetriz Harness 是 Product Hunt 上线的开源项目,面向团队使用 AI 编程工具时 Agent 配置各自为政的问题。它由两个模块组成:Harness Recommendations 从 rules、skills、hooks、permissions 四个维度诊断配置缺陷,并结合团队真实会话记录判断哪些地方出了问题;Control Plane 则把修复方案同步到全体成员,解决"知道该改但没人改"的执行断层。项目支持 Claude Code、Codex、Cursor、Kiro 四个主流工具,押注 Agent 配置需要类似 CI/CD 的工程化管理。当前 54 票、#17 日排名说明它引发了部分共鸣,但讨论热度仍然有限,产品可能处于早期阶段。
团队AI编程的痛点:每个人的Agent都不一样
当团队同时使用 Claude Code、Codex、Cursor 和 Kiro 等工具时,一个隐蔽的问题会逐渐浮现:每个成员的 Agent 配置都在各自演化。有人调好了权限规则,有人写了一组高效的 hooks,有人在 skills 里沉淀了项目特有的知识——但这些经验停留在个人机器上,无法自动流向队友。
新成员加入时,要么从零摸索,要么手动抄一份不知道是否过时的配置。团队整体的 Agent 能力,反而被最不熟悉工具的那个人拉低。
Product Hunt 上线的开源项目 Tetriz Harness 正是针对这一问题。它的标语很直接:"Turn what your team learns into everyone's agent setup"——把团队学到的东西,变成每个人的 Agent 配置。
两个核心模块:诊断与分发
Tetriz Harness 由两个互补的工具组成,形成从"发现问题"到"团队修复"的闭环。
Harness Recommendations:找出Agent配置的漏洞
第一个模块负责诊断。它会分析你的 agents 在 rules、skills、hooks 和 permissions 四个维度上的现状,结合团队的实际会话记录(sessions),判断哪些地方出了问题、哪些能力还缺失。
这个思路区别于通用的 lint 工具。它不只看配置文件本身是否"规范",而是从团队真实使用行为反推配置是否合理。比如某个权限规则频繁导致 Agent 卡住,或者某类任务反复失败却始终没有对应的 skill 来兜底——这些信号只有结合实际会话才能捕捉到。
Control Plane:把修复方案推送给全团队
第二个模块负责分发。当 Recommendations 识别出问题并给出改进方案后,Control Plane 负责把这些修复同步到团队所有成员。
这一步解决的是"知道该改但没人改"的执行断层。传统做法是发一条 Slack 消息说"大家记得更新一下权限配置",实际执行率往往很低。Control Plane 把配置变更变成团队级操作,减少了依赖个人自觉的环节。
配置分发为何需要独立的控制面
在分布式开发团队中,配置漂移是常见现象:即便初始配置一致,随着各成员不断本地调整,版本会迅速发散。Control Plane 的价值在于把配置视为需要集中治理的对象,类似于配置中心(如 Apollo、Consul)在微服务架构中扮演的角色。它不只是"分发文件",更承担版本控制、变更审计与回滚的职责。对于 AI 编程工具而言,这一层此前基本缺席,多数团队只能靠口头约定或文档同步。Control Plane 若能在权限收敛、变更审批与灰度发布上提供机制,就有可能成为团队 Agent 管理的事实标准层。
为什么这个方向值得关注
AI 编程工具的团队化落地正在经历一个微妙阶段:工具本身的能力已经足够强,但团队层面的配置管理几乎是空白。
每个开发者都在用自己的方式"调教"Agent,却缺少共享和改进的机制。这类似于早期开发团队没有统一的代码规范、没有 CI/CD 流水线,每个人都靠个人习惯在写代码。
Tetriz Harness 押注的是:Agent 配置也需要类似工程化的管理方式。它选择开源,并且明确支持 Claude Code、Codex、Cursor、Kiro 四个主流工具,覆盖面在同类项目中算比较宽的。
从 Product Hunt 的数据看,54 个投票和 #17 的日排名说明它引起了部分开发者共鸣,但 1 条评论也反映出讨论热度有限,产品可能还处于早期阶段。
Agent 配置的四个维度分别是什么
在 Claude Code 等工具中,rules、skills、hooks、permissions 构成了 Agent 行为的四层控制面。rules 是指导模型行为方式的指令集合,类似系统提示词的团队版;skills 是可复用的任务能力模块,把项目特有的知识或流程沉淀成可调用的封装;hooks 是在特定事件前后触发的自动化脚本,例如在提交代码前自动运行检查;permissions 则规定 Agent 可以执行哪些操作、访问哪些资源。四者分别对应"怎么说、会什么、何时自动做、被允许做什么",任何一层不统一,都会导致同一团队内 Agent 表现出现明显差异。
会话数据在配置诊断中的作用
Recommendations 强调结合 sessions(会话记录)来判断配置好坏,这与传统静态检查的关键区别在于:配置文件只能反映"写下来的意图",而会话记录反映"实际发生了什么"。通过分析 Agent 与开发者的真实交互轨迹,可以识别出静态配置看不到的问题,例如某条权限规则是否频繁打断正常流程、某类任务是否反复失败、哪些 skill 实际上从未被触发。这种"行为驱动"的诊断方式更贴近工程实践,但也自然会引出数据隐私与传输边界的考量,尤其在企业环境中。
值得思考的问题
这个方向面临几个现实挑战:不同 AI 编程工具的配置格式和扩展机制差异很大,要同时支持四个工具意味着不小的维护成本。团队会话数据的隐私边界也需要明确——Recommendations 分析会话时,数据在哪里处理、是否上传,这些细节对企业的采用决策至关重要。
另一个问题是"团队共识"的形成机制。自动推荐的配置改进如果没有经过团队讨论就直接推送,可能引入新的不一致。如何平衡自动化与人工审核,是 Control Plane 需要回答的问题。
对于正在把 AI 编程工具引入团队工作流的工程负责人来说,Tetriz Harness 提供了一个值得观察的样本:它试图把个人的 Agent 调优经验,转化为可诊断、可分发、可积累的团队资产。这个思路本身,可能比工具当前的功能完整度更值得留意。
相关推荐

房产经纪人用AI提效的5个实操方法(2026版)
房产经纪人如何用AI提效?结合YouTube实操演示,拆解ChatGPT写房源描述、Canva做营销物料、表单管理开放日线索、Zapier自动跟进、卖家面谈准备5个方法,并提示公平住房法规、照片真实性与定价核实等风险边界。

Grok Bot vs ChatGPT Agent:两大AI代理谁更强?
Grok Bot 与 ChatGPT Agent 有何区别?本文对比两者的工作方式:Grok Bot 拥有云端计算机、可常驻工具内自动执行多步任务;ChatGPT Agent 在浏览器中操作网页,通用任务更成熟。附选型建议。

Walmart Agent Gateway:AI帮你自动购物,亚马逊为何反其道而行?
沃尔玛推出Agent Gateway,允许ChatGPT、Gemini等AI助手直接接入商品库替用户搜索比价加购,并设消费限额与逐笔审批三道安全阀。亚马逊则封堵外部AI代理,两大零售巨头走向相反路线。功能目前仅限美国,印度市场或随后跟进。