Tev:用稠密进度奖励破解长周期智能体训练难题

Tev 通过潜在世界优先构建稠密奖励训练环境与 PPRS 方法,让开源长周期智能体实现跨域泛化。
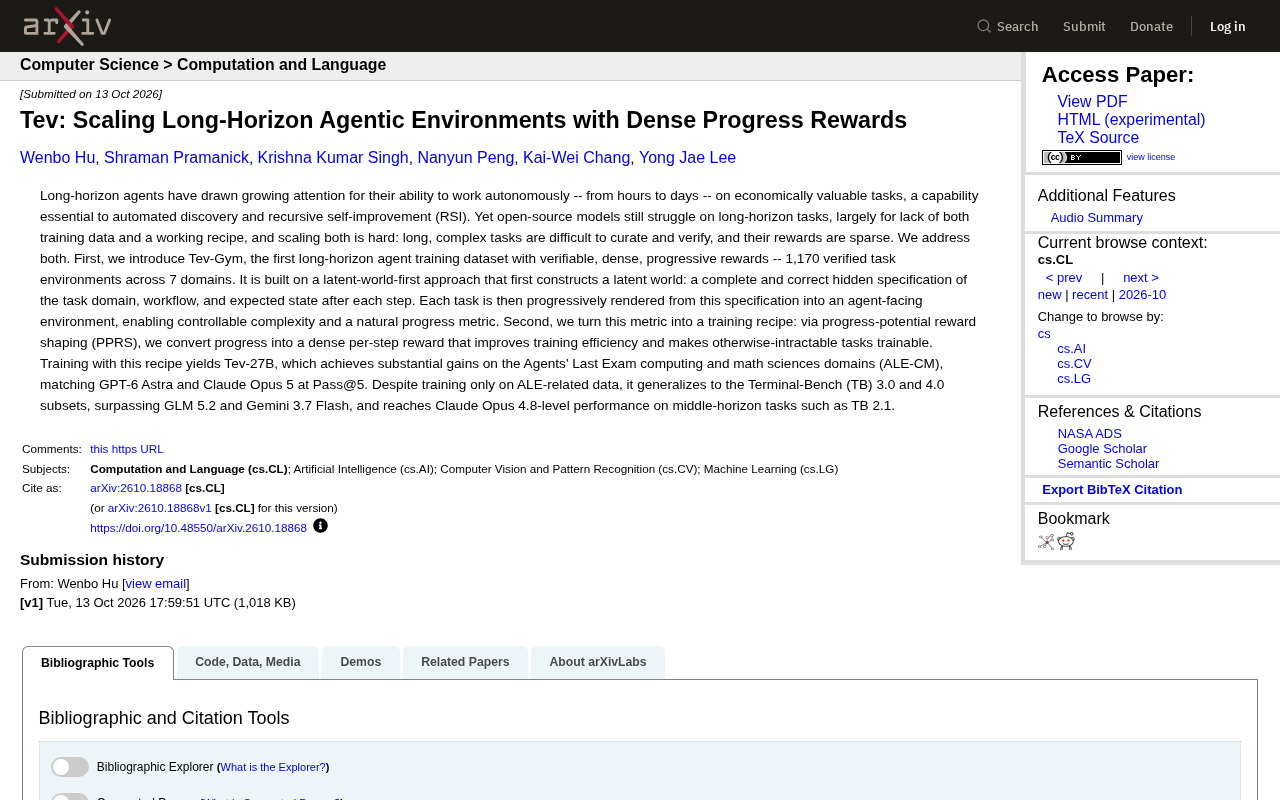
文章介绍了针对长周期智能体训练数据匮乏与方法缺失问题的 Tev 方案。其核心包括三部分:一是 Tev-Gym 数据集,采用「潜在世界优先」思路,先为每个任务构建隐藏规范再渲染为智能体环境,从而覆盖 7 个领域共 1170 个可验证任务并自动产生进度度量;二是 PPRS(进度势能奖励塑形),将潜在世界中的进度指标转化为稠密逐步奖励,使原本因奖励稀疏而无法训练的任务变得可训练;三是基于该方法训练的 Tev-27B 模型,在 ALE-CM 上 Pass@5 追平 GPT-6 Astra 与 Claude Opus 5,并跨域泛化至 Terminal-Bench 3.0/4.0,超越 GLM 5.2 与 Gemini 3.7 Flash。文章认为这一完整闭环暗示模型学到了领域无关的长周期任务执行能力,可能实质性缓解开源模型在这一方向上的数据瓶颈。
长周期智能体(Long-horizon Agent)正在成为AI领域最受关注的方向之一。这类智能体能够在数小时甚至数天内自主完成具有经济价值的任务,是自动化科学发现与递归自我改进(RSI)的关键能力。
然而开源模型在这一方向上始终表现不佳。核心瓶颈有两个:训练数据匮乏和训练方法缺失。长周期任务往往复杂、难以策划和验证,奖励信号又极度稀疏——模型跑完一整个流程可能只得到一个成功或失败的信号,学习效率极低。
Tev 正是针对这两个问题提出的解决方案。
核心思路:先构建潜在世界,再渲染为训练环境
Tev 的第一个贡献是 Tev-Gym,据称是首个具有可验证、稠密、渐进式奖励的长周期智能体训练数据集,覆盖 7 个领域、共 1170 个经过验证的任务环境。
它的构建方式采用了一种「潜在世界优先」(latent-world-first)的思路。具体而言,Tev 首先为每个任务构建一个潜在世界——即对任务领域、工作流程以及每一步之后的预期状态给出完整且正确的隐藏规范。然后,再从这个规范逐步渲染出面向智能体的实际环境。
这种设计带来两个直接好处。一是复杂度可控:因为任务是从规范生成的,可以按需调节难度。二是产生了天然的进度度量:潜在世界中的每一步状态转换都对应一个可量化的进展指标,不再只有最终的成功/失败信号。
这解决了一个长期困扰长周期训练的根本问题——任务难以策划、难以验证。通过先定义「正确答案应该是什么样」,再让环境围绕它生成,验证变得自动化且可扩展。
潜在世界(Latent World) 一词借鉴自世界模型(World Model)研究,指的是对任务环境内部状态与状态转移规则的完整抽象表示。在传统强化学习中,环境通常以代码或物理模拟器直接编写,智能体观测到的就是全部信息;而在 Tev 的设定中,潜在世界是「上帝视角」的隐藏规范——它完整描述了任务领域、正确工作流程以及每一步执行后应当达到的状态,但智能体在交互过程中并不能直接看到它。
这种「先有规范、再渲染观测」的两层结构,让验证变得廉价:只要将智能体的实际状态与潜在世界中的预期状态做比对,就能自动判断它是否走在正确路径上。这也是 Tev-Gym 能够为 1170 个任务提供稠密奖励的前提——奖励不必依赖人工标注的成功/失败标签,而是从规范中自动导出。
PPRS:把进度转化为每步奖励
有了进度度量,接下来的问题是如何把它变成可训练的信号。Tev 提出了 进度势能奖励塑形(Progress-Potential Reward Shaping,PPRS),将进度指标转换为稠密的逐步奖励。
这一方法的实际效果是显著提升训练效率,并让原本因奖励过于稀疏而「不可训练」的任务变得可训练。奖励塑形并非新概念,但 PPRS 的特殊之处在于它的势能源于结构化的潜在世界规范,而非启发式的中间奖励设计——这让奖励信号既稠密又与任务本质目标保持一致。
用这套方法训练出的模型是 Tev-27B。
奖励塑形(Reward Shaping) 是强化学习中的经典技术:当环境只给出稀疏的最终奖励时,训练信号太弱,智能体很难通过随机探索找到正确路径。奖励塑形通过引入中间奖励引导学习,但传统方法依赖人工设计的启发式(如「离目标更近就加分」),容易引入偏差,导致智能体优化中间奖励而非真正目标。
势能奖励塑形(Potential-based Reward Shaping) 是 Ng 等人在 1999 年提出的一种理论保证框架:如果中间奖励定义为势能函数的差分 F(s,s') = γΦ(s') - Φ(s),那么最优策略不会因塑形而改变,即塑形「不改变任务本质」。PPRS 的创新在于把势能 Φ 直接定义为潜在世界规范中的进度度量——每一步状态转换沿着规范路径前进多少,就产生相应奖励。这既保留了势能塑形的理论无损性,又让势能有明确语义来源,避免了启发式设计的任意性。
训练结果:跨域泛化能力突出
Tev-27B 的表现值得关注的地方不只是绝对分数,还有它的泛化特性。
在 Agents' Last Exam 的计算与数学科学领域(ALE-CM) 上,Tev-27B 取得了显著提升,在 Pass@5 指标上追平了 GPT-6 Astra 和 Claude Opus 5。
更具说服力的是跨域迁移。Tev-27B 的训练数据仅与 ALE 相关,但它在 Terminal-Bench(TB)3.0 和 4.0 子集上同样超越了 GLM 5.2 和 Gemini 3.7 Flash;在中周期任务如 TB 2.1 上,则达到了 Claude Opus 4.8 级别的表现。
这种「只在 ALE 相关数据上训练却能泛化到 Terminal-Bench」的现象,暗示了一个重要信号:通过潜在世界规范构建的任务环境,可能学到了某种领域无关的长周期任务执行能力,而非仅仅记住了特定任务的解法。这对于降低长周期智能体的数据获取成本具有实际意义——不需要为每个目标场景都从头构建训练数据。
Pass@5 是评测智能体或代码生成模型时的常用指标:对同一道题生成 5 个独立解答,只要其中任意一个通过验证就算成功。相比 Pass@1,它更能反映模型的能力上限,也常用于缓解单次采样随机性带来的噪声。在长周期任务评测中,由于任务本身耗时长、失败率高,Pass@5 常被用来衡量模型「有潜力解决」而非「稳定解决」的边界能力。
Terminal-Bench 是一套面向命令行智能体的基准测试,任务要求模型在真实终端环境中完成多步操作(如配置系统、调试脚本、处理文件),评测其长周期工具使用与环境交互能力。它与 ALE(Agents' Last Exam)同属高难度智能体评测,但侧重不同的技能面:ALE 偏重计算与数学科学推理,Terminal-Bench 更强调工程操作。Tev-27B 仅在 ALE 相关数据上训练却在 Terminal-Bench 上表现优异,正是这一跨技能面迁移现象构成了「领域无关能力」的论据。
为什么这件事重要
长周期智能体的训练长期处于一种尴尬境地:能力上限被寄予厚望,但工程上缺乏可扩展的配方。Tev 的价值在于它同时给出了数据基础设施(Tev-Gym)、训练方法(PPRS)和验证结果(Tev-27B),形成了一个完整闭环。
潜在世界优先的思路尤其值得关注。它把「任务策划」从一个依赖人工设计的瓶颈,转变为一个可以结构化生成的过程。如果这一范式能被更广泛地采用,长周期智能体的训练数据稀缺问题可能会得到实质性缓解——而稠密进度奖励则让这些数据真正能被用起来。
开源模型在长周期任务上的差距,可能正是因为缺少这样的基础设施和配方,而非仅仅是模型规模的问题。
相关推荐

WorkBuddy全流程教程:从零搭建AI办公自动化智能体
WorkBuddy 全流程教程精讲:从下载安装、三种工作模式到多模态绘本视频实战,再到专家团搭建智能体与工作流配置,帮你用低成本 AI Agent 实现办公自动化。

WorkBuddy智能体全攻略:7天从入门到自动化实战
基于B站256集WorkBuddy全套精讲课程,系统拆解腾讯AI办公工作台的核心能力:Agent原理、Skill封装、连接器跨平台、定时自动化、知识库与零代码开发,附学习路径建议。

8个AI账号翻车7个:我用AI干活的真实复盘
B站8个AI运营账号仅1个跑通。本文拆解"演AI"与"用AI干活"的本质区别,分析5条视频217万播放背后的产能控制、评论区运营和交付节奏策略。