three.dev: 让AI Agent的失败在上线前暴露

three.dev 从实时流量自动发现 AI 智能体的静默失败并让编码智能体直接修复。
three.dev 针对 AI 智能体在生产环境中的“静默失败”问题提出解决方案:这类失败不会抛出异常或触发告警,而是生成看似合理却错误的内容,如编造退款政策或虚构订单状态,团队往往只能从用户投诉中得知。three.dev 自动分析实时流量,识别智能体的行为偏差,并按严重程度排序,让高风险问题优先浮现,减少人工审查负担。集成方式被简化为一条提示,Claude Code、Cursor、Codex 等编码智能体可直接据此生成修复代码,打通从发现到修复的闭环。该产品在 Product Hunt 获得 125 票、16 条评论,排名第 9,反映出开发者对 AI 可观测性的关注正在上升,但其实际效果仍需更多真实场景验证。
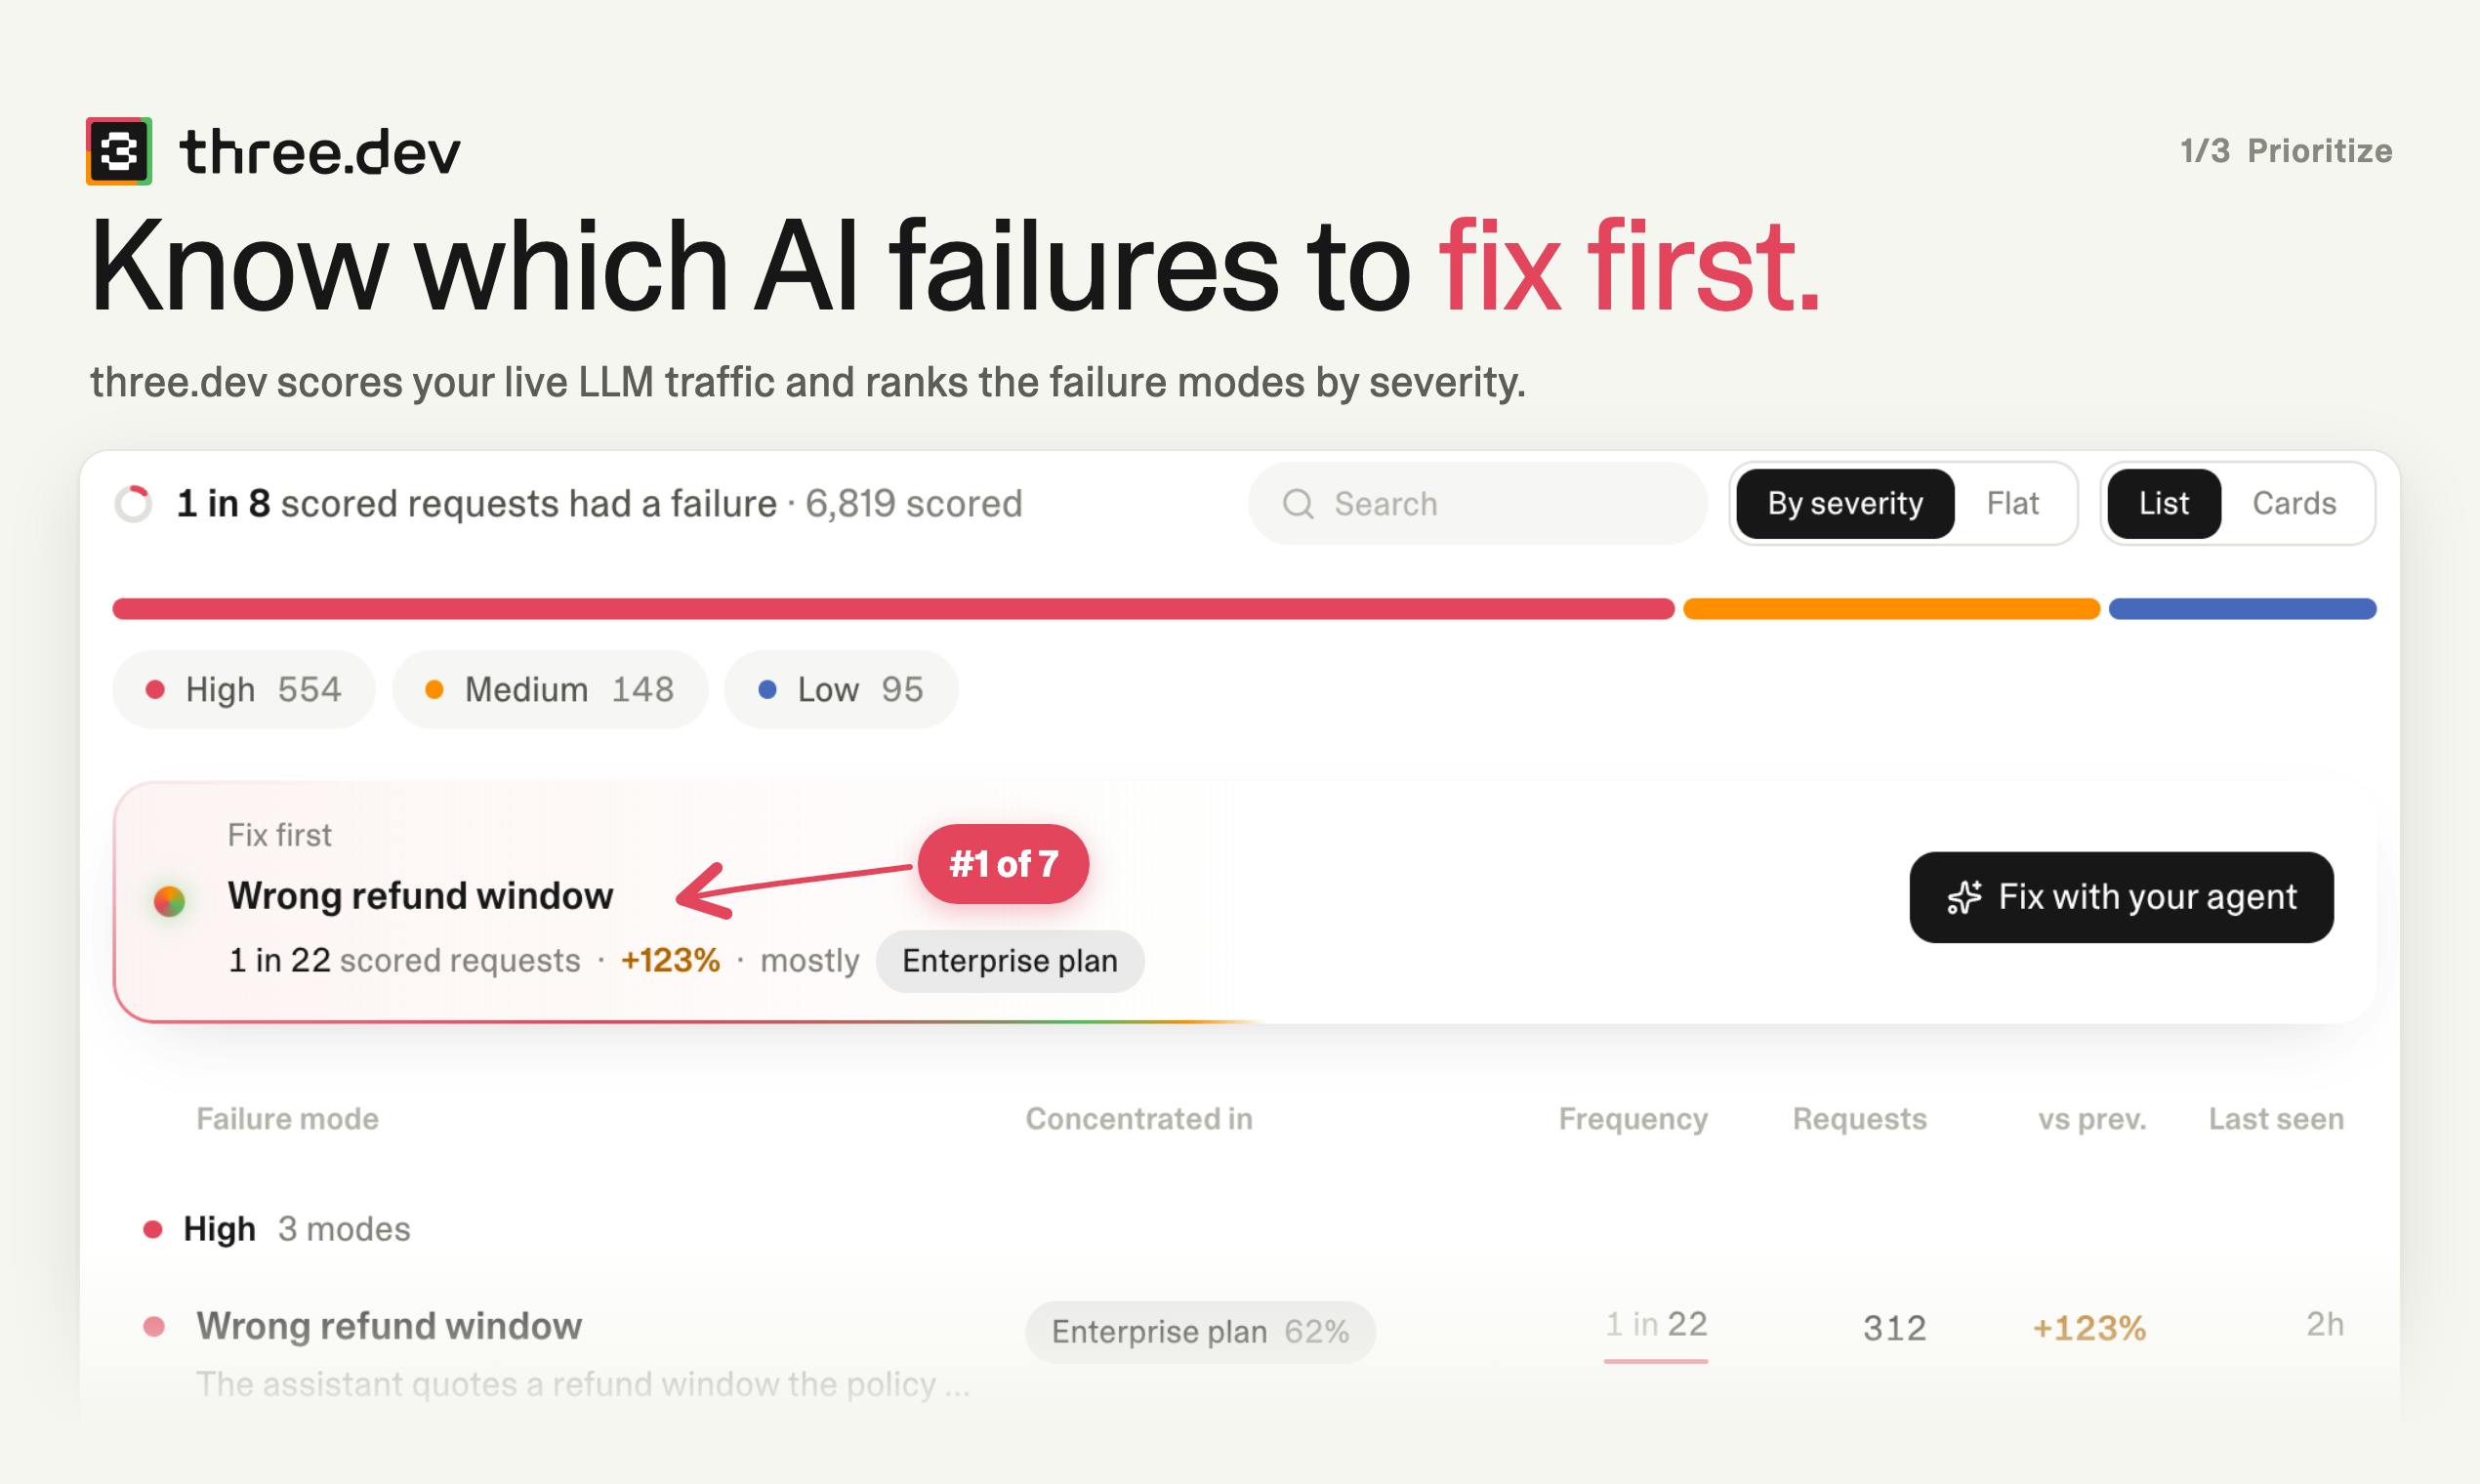
AI 智能体(AI Agent)正快速进入生产环境,但许多团队对它们在真实用户面前的表现缺乏了解。失败往往是静默的:一个错误的退款政策、一个编造的订单状态——系统没有崩溃,问题却已发生,最后只能从用户投诉中得知。three.dev 试图改变这一局面:它自动从实时流量中找出这些失败,按严重程度排序,并让编码智能体直接生成修复方案。
静默失败:AI Agent 生产落地的隐形陷阱
传统软件监控依赖异常日志和错误码,但 AI Agent 的失败模式截然不同。它们很少抛出异常,而是生成看似合理却错误的内容——比如给用户一个不存在的退款政策,或虚构订单状态。这类问题不会触发任何告警,团队往往要等到用户反馈才意识到。three.dev 的定位正是填补这一空白:在用户发现问题之前,主动从真实流量中识别智能体的行为偏差。
什么是“静默失败”(Silent Failure)
静默失败指系统在运行过程中没有抛出异常、没有错误码、日志看起来一切正常,但输出结果对用户而言是错误或有害的情形。在传统软件中,这类问题相对少见,因为逻辑错误通常会被单元测试或异常捕获拦截;而基于大语言模型的 AI 智能体输出具有开放性和概率性,同一输入可能产生语义通顺却事实错误的回答,因此其失败天然倾向于“静默”。
这类失败常见的成因包括:模型对内部知识边界的误判(如凭空编造政策或订单状态)、上下文检索错误(RAG 召回了不相关文档)、工具调用参数错误,以及提示词与业务规则不一致。由于没有崩溃信号,传统以错误率和异常堆栈为核心的监控体系几乎无法覆盖,团队只能依赖用户投诉、人工抽检或离线评测,反馈链路长且样本稀疏。这也是“AI 可观测性”(AI Observability)近年成为独立议题的原因:它关注的不是服务是否存活,而是输出是否在业务语义上正确。
自动发现与严重性排序
three.dev 的核心能力是自动分析实时流量,找出 AI 智能体的失败案例,并按严重程度进行排序。这意味着团队无需手动编写测试用例或规则,系统会自行从用户交互中学习什么是“失败”。对于已经将 AI 投入生产的团队来说,这种自动化发现机制能显著降低人工审查负担,同时让高风险问题优先浮出水面。
自动化失败发现与严重性排序的技术背景
在没有预定义规则的前提下自动判定“什么是失败”,通常依赖两类信号:一是隐式反馈,例如用户追问、重试、转人工、会话中断或负面情绪表达;二是模型评审(LLM-as-a-Judge),即用另一个模型依据业务标准对交互轨迹打分。两者结合可以在海量真实流量中低成本地筛出可疑样本,再交由人工复核。
严重性排序则涉及风险分级:涉及资金、退款、账户安全或合规承诺的错误优先级最高,仅影响体验的措辞问题优先级较低。排序通常综合错误类型、影响用户数、出现频次与业务规则权重。相比传统手工编写测试用例,这种从真实流量中学习失败模式的方式更贴近长尾分布,但也带来评估标准漂移和误报的问题——评分模型本身的偏差会直接影响发现质量,因此仍需人工校准与反馈闭环。
一条提示完成集成,编码智能体直接修复
接入 three.dev 的过程被简化为一条提示:在 Claude Code、Cursor 或 Codex 中执行一个 prompt,编码智能体就能获得所需信息,进而编写修复代码。这种设计将发现与修复打通,减少了从问题定位到代码修改的上下文切换。对于使用 AI 编程工具的团队,这意味着可以更快地闭环处理智能体行为问题。
编码智能体与“发现—修复”闭环
编码智能体(Coding Agent)指能够读取代码库、理解上下文并自主编辑文件、运行测试的 AI 编程工具,Claude Code、Cursor、Codex 均属此类。它们与普通的代码补全不同,可以在多文件范围内执行任务,并依据反馈迭代修改。
two.dev 类产品把可观测性数据转化为编码智能体可消费的上下文,本质上是把“问题报告”结构化为一组可执行的修复指令,从而缩短从定位到提交代码的链路。这种模式的价值在于减少人工上下文切换,但也要求失败样本附带足够的复现信息(输入、上下文、期望行为),否则智能体容易生成表面正确、实际未覆盖根因的补丁。修复后如何验证、如何防止回归,仍需要配套的评测与回归测试机制。
市场定位与思考
three.dev 在 Product Hunt 上获得 125 票、16 条评论,排名第 9,分类为 Analytics、Developer Tools 和 Artificial Intelligence。这表明开发者对 AI 智能体可观测性的关注正在上升。随着越来越多团队将 AI 投入生产,如何确保其行为符合预期将成为关键挑战。three.dev 从实时流量中自动发现失败的方法,为 AI 质量保障提供了一种新思路。不过,其实际效果仍需在更多真实场景中验证。
相关推荐

Gemini 4 Neon 曝光:或成 Opus 5.5 有力竞争者
Hacker News 讨论帖指出 Gemini 4 Neon 看起来像 Opus 5.5 的竞争者。本文解读这一社区信号背后的产品定位、顶级模型竞争格局变化,以及对开发者模型选型策略的实际意义。

Claude Fable 5.2 独立创作短片《Fable》引热议
Hacker News 上出现由 Claude Fable 5.2 独立完成剧本、画面与导演的短片《Fable》,本文分析全流程 AI 创作的意义、社区反应及对内容创作者的启示。

Anthropic IPO定价:AI巨头上市信号
Anthropic 进行 IPO 定价的消息引发关注。本文分析这一动作对 AI 行业估值、商业化路径和竞争格局的潜在影响,并指出公开市场对 AI 公司的期待与挑战。