TITAN框架:破解低资源多语言翻译的稀疏电路机制

研究揭示多语言模型低资源翻译的内部稀疏电路机制,提出仅更新5%参数即显著提升翻译质量的方法。
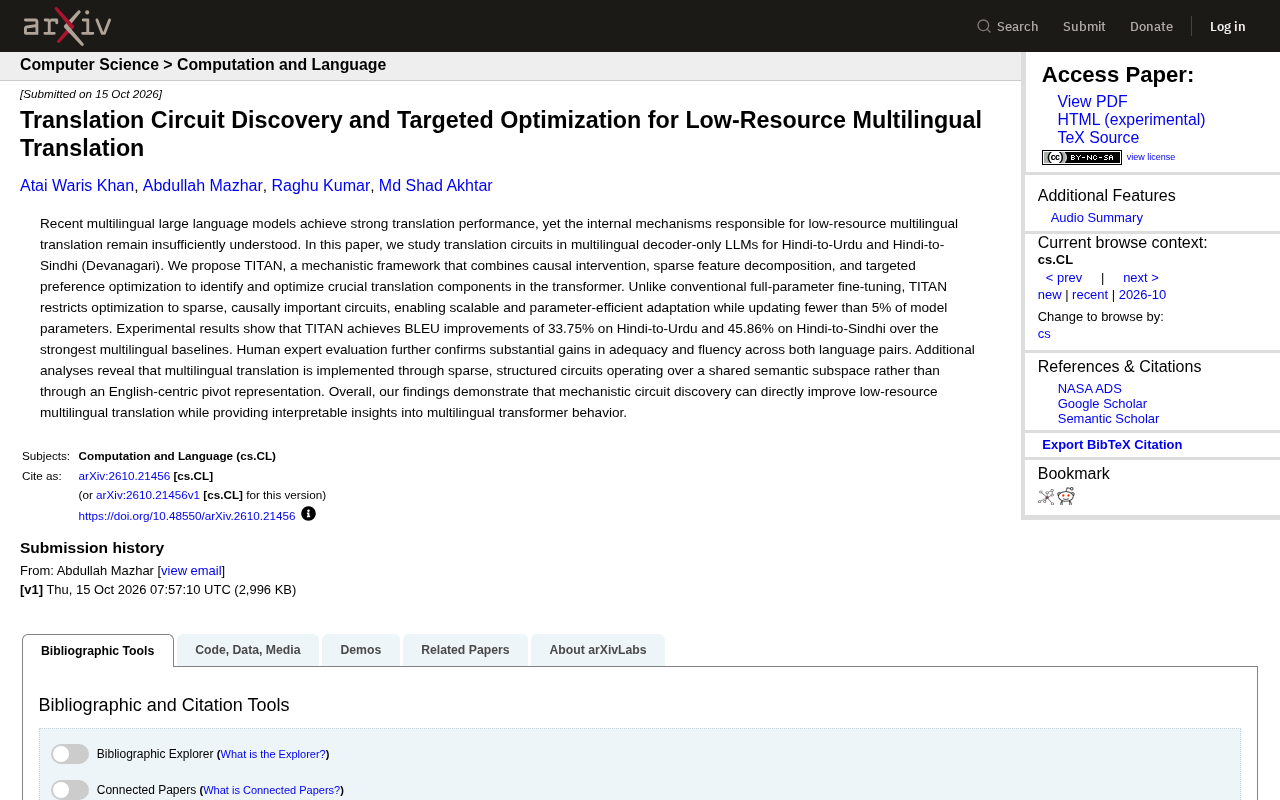
该研究针对印地语到乌尔都语、印地语到信德语等低资源语言对的翻译瓶颈,提出TITAN框架,将因果干预、稀疏特征分解与靶向偏好优化结合,通过定位模型中真正承载翻译能力的关键电路,实现仅更新不到5%参数的精准优化。实验结果显示,TITAN在印地语到乌尔都语方向取得33.75%的BLEU提升,在印地语到信德语方向达45.86%,人工评估也确认充分性与流畅性显著优于基线。更重要的是,机制分析表明翻译依赖稀疏结构化电路在共享语义子空间上运作,而非以英语为枢轴中转,挑战了多语言模型的传统假设,为低资源NLP提供了不依赖堆数据的新路径。
多语言大模型在翻译任务上表现亮眼,但一个根本问题始终悬而未决:当模型处理印地语到乌尔都语这类低资源语言对时,transformer内部究竟发生了什么?最近一项研究给出了机制层面的回答,并提出了一个只更新不到5%参数就能大幅提升翻译质量的新方法。
为什么低资源翻译的"黑箱"必须被打开
当前主流的多语言模型训练思路是扩大参数和语料覆盖,但低资源语言对之间的翻译质量提升往往陷入瓶颈。研究者意识到,问题的关键可能不在于模型"学得不够多",而在于我们对模型内部翻译机制的理解几乎为零。
这项研究聚焦于两个典型的低资源语言对:印地语到乌尔都语,以及印地语到信德语(天城文)。选择这两组语言并非偶然——它们共享部分文化语境和词汇渊源,但在现有模型中翻译表现差异显著,恰好为机制分析提供了天然的对照条件。
传统观点倾向于认为,多语言模型在处理非英语语言对时,会隐式地借助英语作为"中转站"来完成任务。但这项研究的发现直接挑战了这一假设。
TITAN框架:三管齐下的精准手术
研究团队提出的TITAN框架,核心思路是将翻译能力的优化从"全参数微调"转向"因果电路定位与靶向优化"。具体来说,它融合了三种技术路径:
因果干预用于识别哪些注意力头或前馈层对翻译输出有决定性影响。稀疏特征分解则帮助研究者从高维激活中提炼出真正承载翻译信息的结构化特征。靶向偏好优化将优化范围严格限制在已识别的关键电路上。
这种组合的效果相当直接:整个优化过程更新的参数量不到模型总量的5%。相比动辄需要重新训练全部权重的传统微调方案,TITAN在计算开销和部署灵活性上都有明显优势。
因果干预的核心工具是激活替换(activation patching)与因果追踪(causal tracing)。研究者先向模型输入一段源语言文本,记录各层注意力头和前馈网络的激活值;再在目标语言输入下逐层恢复这些激活,观察翻译输出是否恢复正确。若恢复某一位置后输出显著改善,该位置就被判定为翻译电路的关键节点。这一方法已在事实回忆、句法处理等任务中验证有效,此处被首次系统应用于低资源翻译的电路定位。
稀疏特征分解通常借助稀疏自编码器(Sparse Autoencoder, SAE)实现。Transformer内部的激活向量维度极高且高度纠缠,单个神经元往往同时响应多种语义。SAE通过重建误差与稀疏性惩罚的联合训练,将稠密激活拆解为数千个可解释的稀疏特征方向。研究者由此能分辨哪些特征真正编码跨语言语义映射,哪些只是噪声,从而避免在无关方向上浪费优化预算。
翻译质量的量化跃升
实验数据是这项研究最有说服力的部分。在印地语到乌尔都语方向上,TITAN相比最强的多语言基线模型取得了33.75%的BLEU提升;在印地语到信德语方向上,这一数字达到45.86%。
BLEU分数的绝对提升幅度在低资源翻译领域并不常见,超过三成甚至四成的改进意味着翻译输出在词汇匹配和短语结构上发生了质的变化。
人工专家评估进一步验证了自动指标的可信度。评估者在充分性和流畅性两个维度上都给出了显著优于基线的评分,说明提升并非过拟合于某个自动指标的假象。
BLEU(Bilingual Evaluation Understudy)通过统计模型输出与参考译文之间n-gram(通常为1至4元词组)的重合率来衡量翻译质量,并对过短输出施加长度惩罚。其取值区间为0到100,但并非线性刻度:30分左右的提升在中高资源任务中已属可观,而低资源语言对因参考语料稀缺、形态差异大,基线分数往往偏低,33%至46%的相对跃升意味着输出从"勉强可读"跨入"基本可用"的区间。
需要留意的是,BLEU对词形变化敏感,而印地语、乌尔都语和信德语都存在丰富的形态屈折,同一语义可有多种词形实现。因此研究者引入人工评估作为交叉验证:充分性(adequacy)考察译文是否完整传达源文信息,流畅性(fluency)考察译文是否符合目标语言的表达习惯。两个维度同时显著提升,说明改进并非仅来自词面匹配的偶然优化。
稀疏电路挑战"英语中转"假设
这项研究最具理论冲击力的发现,在于对多语言翻译内部表征的重新描述。分析显示,翻译过程实际上是通过稀疏的、结构化的电路在共享语义子空间上运作的,而非依赖以英语为中心的枢轴表示。
换句话说,模型并不需要先把印地语"翻译成英语"再转译成乌尔都语或信德语。它内部存在更直接的跨语言映射路径,只是这些路径分散在特定的稀疏电路中,过往的全参数微调方法很难精准地强化它们。
这一发现对多语言模型的可解释性研究也有推动作用。如果翻译能力可以被定位到具体的电路结构上,那么未来针对其他低资源语言对的优化就有了可复用的方法论框架。
英语枢轴假设(English pivot hypothesis)源于一个广泛观察:多语言模型在预训练中英语语料占比极高,因此非英语语言对的翻译可能隐式地经过英语中转。支撑这一假设的典型证据是"零样本翻译"现象——模型从未见过某语言对的平行语料,却能完成翻译,研究者推测英语充当了共享语义枢纽。
本研究用因果干预直接检验了这条路径:若英语中转成立,那么在翻译印地语到乌尔都语时,屏蔽或替换与英语相关的中间表征应导致输出崩溃。但实验显示,关键电路集中在与英语处理重叠度较低的稀疏子空间上,说明模型学到的跨语言映射比枢轴假说描述的更为直接。这一结论与近期关于多语言模型"语义中枢"(semantic hub)的研究形成对话——共享表征可能存在,但其载体未必是英语本身。
对低资源NLP的启示
TITAN的价值不仅在于两个语言对上的性能数字,更在于它展示了一条不同于"堆数据、堆参数"的技术路线。对于真正稀缺资源的语言,收集大规模平行语料的成本极高,而从模型内部挖掘已有能力、进行靶向增强,显然是一条更务实的路径。
当然,这项研究目前覆盖的语言对仍然有限,电路发现方法能否迁移到语法差异更大的语言组合上,还需要更多验证。但至少它指出了一个方向:理解模型内部机制,可以反过来成为提升模型能力的直接手段。
相关推荐

WorkBuddy全流程教程:从零搭建AI办公自动化智能体
WorkBuddy 全流程教程精讲:从下载安装、三种工作模式到多模态绘本视频实战,再到专家团搭建智能体与工作流配置,帮你用低成本 AI Agent 实现办公自动化。

WorkBuddy智能体全攻略:7天从入门到自动化实战
基于B站256集WorkBuddy全套精讲课程,系统拆解腾讯AI办公工作台的核心能力:Agent原理、Skill封装、连接器跨平台、定时自动化、知识库与零代码开发,附学习路径建议。

8个AI账号翻车7个:我用AI干活的真实复盘
B站8个AI运营账号仅1个跑通。本文拆解"演AI"与"用AI干活"的本质区别,分析5条视频217万播放背后的产能控制、评论区运营和交付节奏策略。