Token Merging:让多语种语音识别更快更省的实用方案
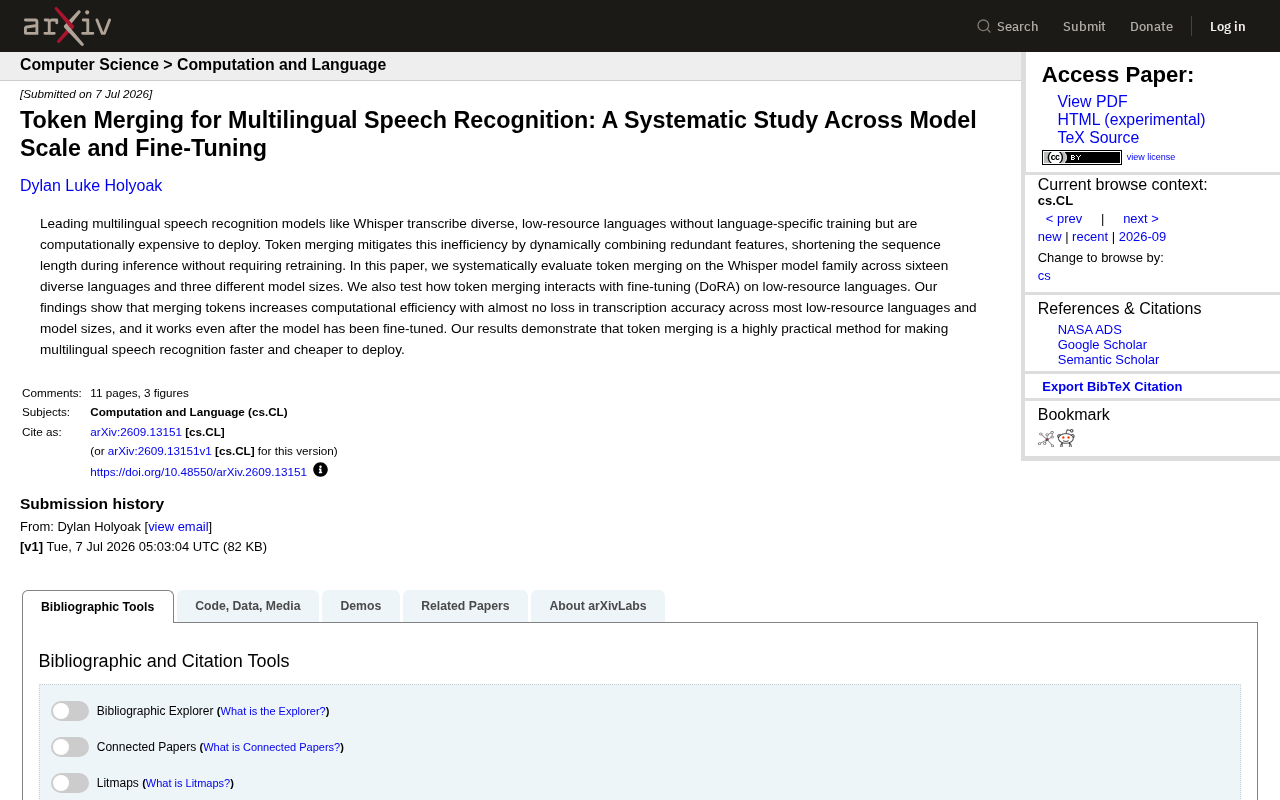
Token Merging技术可在不重训练的前提下,让Whisper多语种语音识别推理提速且几乎不损失准确率。
这篇来自arXiv的研究系统验证了将Token Merging(ToMe)技术应用于Whisper多语种语音识别模型的可行性。Token Merging通过在推理阶段动态合并冗余相似的token来缩短序列长度,无需重新训练模型权重,因此改造成本极低。研究覆盖16种语言(含多种低资源语言)和3种模型尺寸,并额外测试了与DoRA参数高效微调方法的兼容性。核心结论是:在绝大多数测试配置下,该方法在提升计算效率的同时几乎不牺牲转录准确率,且在模型经过针对性微调后依然生效。这为需要大规模、低成本部署Whisper类模型的工程团队提供了一个经过多维验证的实用优化选项。
多语种语音识别模型正在成为语音技术的主流方向。以 OpenAI 的 Whisper 为代表的模型能够转录各种语言,包括那些缺乏专门训练数据的低资源语言,而无需针对每种语言单独训练。但这种强大能力有个明显代价——部署时的计算开销相当高。一篇发表于 arXiv 的研究(arXiv:2609.13151v1)系统性地探讨了如何用 Token Merging(词元合并)技术缓解这一效率瓶颈。
Whisper 的效率困境
Whisper 这类模型的吸引力在于泛化能力:不需要为斯瓦希里语、泰米尔语或其他小语种准备专门的训练流程,模型就能给出可用的转录结果。这对低资源语言尤其重要,因为这些语言往往缺乏足够的标注数据来支撑独立训练。
问题在于,这种通用性建立在庞大的模型规模和高昂的推理成本之上。当需要在实际场景中大规模部署——比如实时字幕、语音助手或音频归档——每一秒音频的处理成本都会累积成可观的开支。对于预算有限的应用场景,这几乎是道拦路虎。
Whisper 由 OpenAI 于 2022 年发布,采用编码器-解码器 Transformer 架构:音频首先被转换为 80 维梅尔频谱图(Mel spectrogram),经卷积层下采样后送入编码器生成特征序列,再由解码器以自回归方式逐 token 输出文本。模型家族按参数量分为 Tiny(39M)、Base(74M)、Small(244M)、Medium(769M)和 Large(1.5B)多个尺寸,训练数据达 680,000 小时多语种弱监督音频。编码器的计算负担随输入音频长度线性增长,而推理时序列长度通常固定为 30 秒窗口对应的 1500 个 token,这正是 Token Merging 介入并压缩序列的关键位置。
Token Merging 如何提速
Token Merging 的核心思路是在推理过程中动态合并冗余特征。语音信号在被编码成一系列 token 后,相邻或相似的 token 之间往往存在大量重复信息。通过识别并合并这些冗余 token,模型处理的序列长度得以缩短,计算量随之下降。
这个方法最大的实用价值在于无需重新训练。它作用于推理阶段,直接对已有模型生效,不改变模型权重。这意味着开发者可以把它当作一个即插即用的优化手段,套用在现成的 Whisper 模型上,而不必投入额外的训练资源。
Token Merging(ToMe)最初由 Bolya 等人在 2022 年提出,用于加速视觉 Transformer(ViT)的图像分类推理。其核心机制借助 bipartite soft matching(二分软匹配)算法,在每个 Transformer 层中找出余弦相似度最高的 token 对,将它们合并为单个 token(通常取均值或加权平均)。这一过程发生在注意力计算之前,从而减少进入注意力机制的序列长度,计算复杂度随 token 数量的平方关系下降,加速效果随合并比例提升而显著增大。将该方法迁移到语音领域的关键挑战在于:音频特征沿时间轴排列,相邻帧之间本就高度相关,因此冗余 token 天然丰富,理论上比图像任务更适合合并——这也解释了为何该研究在语音转录上能维持较低的精度损失。
系统性实验:16 种语言、3 种模型规模
这项研究的价值在于其评测的全面性。研究者在 Whisper 模型家族上进行了系统评估,覆盖了:
- 16 种不同语言,包含多种低资源语言
- 3 种不同的模型尺寸,验证方法在不同规模下的表现
- 与微调的交互作用,特别测试了 Token Merging 与 DoRA 微调方法在低资源语言上的配合
这种多维度的实验设计避免了"只在某个特定配置下有效"的局限,让结论更具普适性。
核心发现:几乎无损的加速
实验结果给出了一个相当积极的结论:在大多数低资源语言和各种模型尺寸下,合并 token 提升了计算效率,同时转录准确率几乎没有损失。换句话说,用户得到的是接近"免费"的性能提升——省了算力,却基本没牺牲识别质量。
更关键的一点是,Token Merging 在模型经过微调之后依然有效。研究者测试了它与 DoRA(一种参数高效微调方法)的结合,证明即便针对低资源语言做了专门优化,词元合并的加速效果依然成立。这打消了一个潜在顾虑:优化技术之间是否会相互干扰。
DoRA(Weight-Decomposed Low-Rank Adaptation)是 2024 年提出的一种参数高效微调(PEFT)方法,在 LoRA 的基础上进一步将预训练权重分解为幅度(magnitude)和方向(direction)两个分量,分别进行更新。这种分解方式让模型在低秩适配过程中保留更多原始权重的结构信息,实验表明其在多项任务上优于标准 LoRA,同时可训练参数量相近。在低资源语音识别场景中,DoRA 的价值在于:仅需极少量目标语言数据,就能将通用 Whisper 模型的识别准确率显著提升,无需从头微调全部参数。该研究将 DoRA 与 Token Merging 组合测试,目的是验证效率优化手段在模型权重已被定制化修改后是否仍然适用。
对实际部署的意义
这项工作的落脚点非常清晰——让多语种语音识别更快、更便宜地部署。对于工程团队而言,这传递了几个明确信号:
第一,Token Merging 是一个低风险的优化选择。它不需要重新训练,改造成本极低,且经过多语言、多规模验证。
第二,它与微调流程兼容。团队可以先用 DoRA 之类的方法针对目标语言优化模型,再叠加 Token Merging 获取效率收益,两者不冲突。
第三,对低资源语言场景尤其友好。这些场景本身数据稀缺、预算有限,而 Token Merging 恰好在这类语言上保持了准确率,让更多小语种的语音应用变得经济可行。
小结
这项研究没有提出全新的算法,而是把 Token Merging 这一已有技术在多语种语音识别场景中做了扎实的系统验证。它回答了实践者最关心的问题:这个方法在不同语言、不同模型规模、以及微调之后是否都能稳定生效。答案基本是肯定的。对于任何需要规模化部署 Whisper 类模型的团队来说,这是一个值得纳入工具箱的实用优化手段。
相关推荐
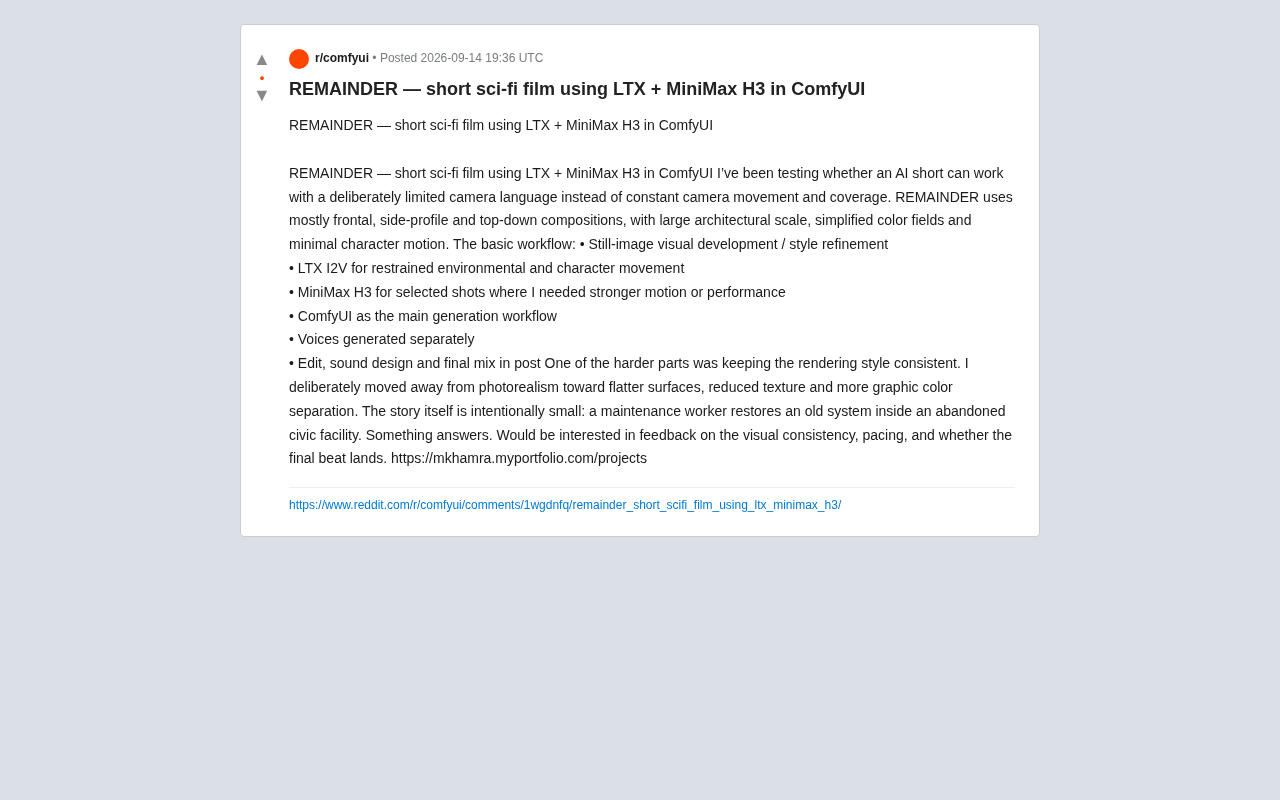
用LTX+MiniMax H3打造AI科幻短片:ComfyUI克制镜头语言实战
AI科幻短片《REMAINDER》用LTX、MiniMax H3与ComfyUI打造克制的镜头语言,通过扁平化美学解决视觉一致性难题。拆解其多模型协作工作流与创作方法论。
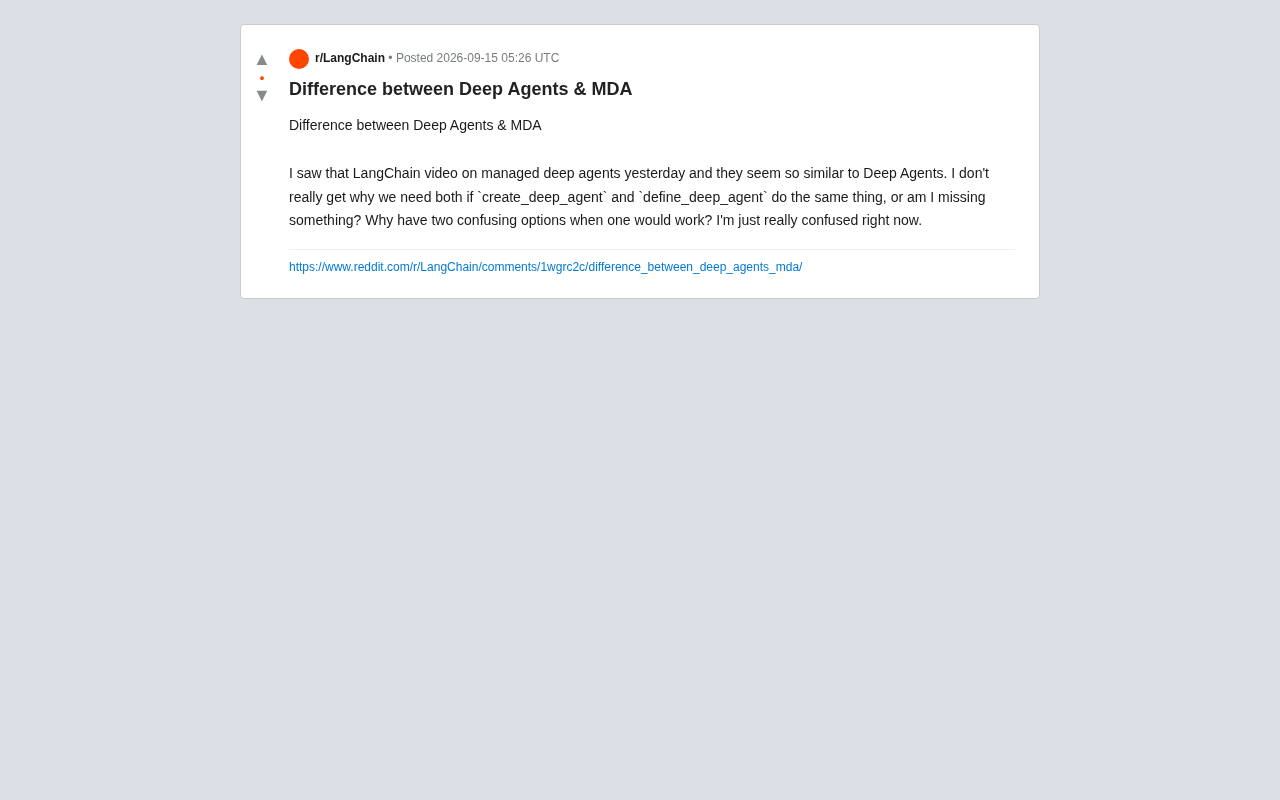
LangChain Deep Agents 与 MDA 有何区别?开发者困惑解析
LangChain 的 Deep Agents 与 MDA(托管深度智能体)到底有何区别?本文从 create_deep_agent 与 define_deep_agent 的差异出发,解析自托管与托管两种智能体部署模式的取舍,帮助开发者理清选择思路。
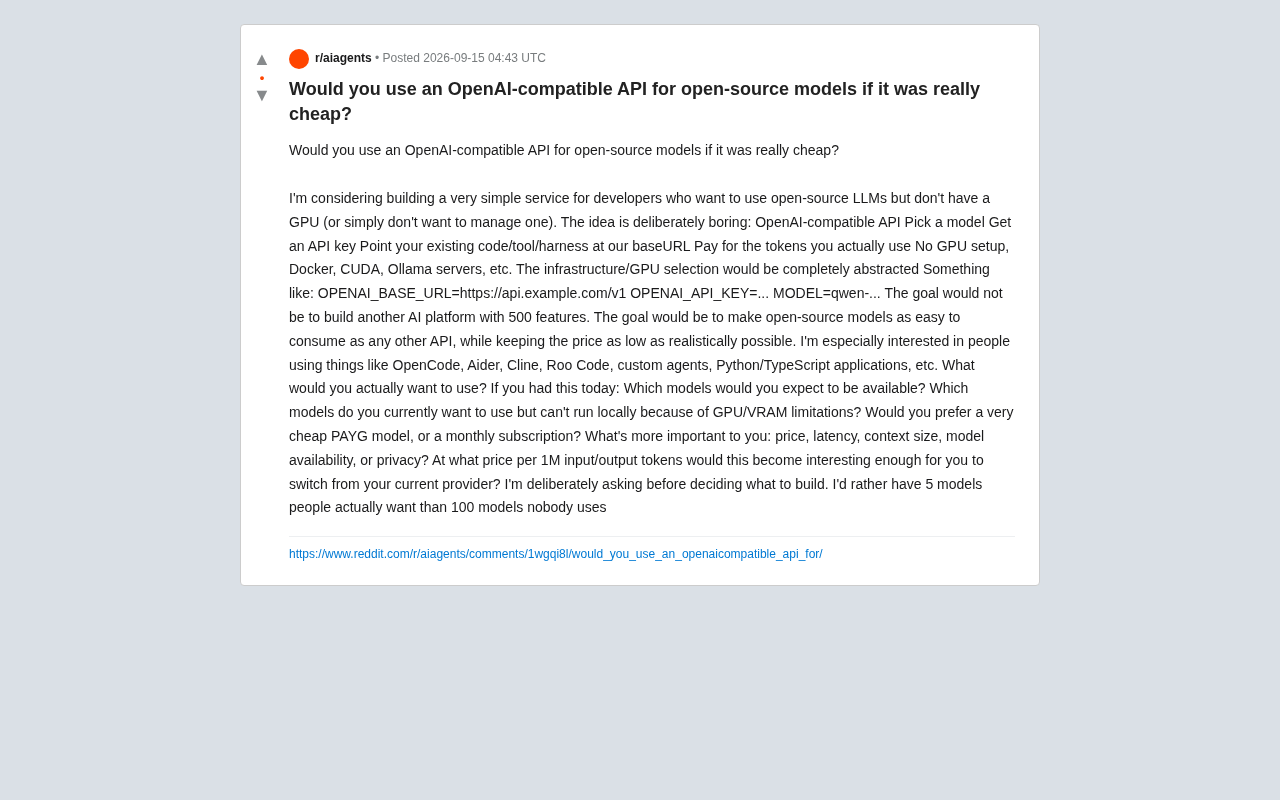
廉价的OpenAI兼容API:开源大模型云端调用的机会与痛点
一位开发者在Reddit探讨:是否需要一个廉价、兼容OpenAI接口的开源模型API服务,让开发者无需GPU即可调用Qwen、Llama等模型。本文分析该设想的痛点、计费模式取舍与市场挑战。