Token不够用?DeepSeek Harness免费额度插件实测

用插件聚合36家厂商635个模型的免费额度,让agent敢多试错。
文章围绕 DeepSeek Harness 这类 agent 工具的高昂账单展开,指出 agent 的成本主要来自多轮试错而非聊天本身——一个任务来回十几轮,每轮都在烧钱。作者介绍了一款插件,它把 36 家厂商、635 个模型的免费额度汇总成一个池子,限流时自动切换下一家,并覆盖文本、看图、生图、生视频四类额度,装完即用无需改代码。文章的核心观点是:比省钱更重要的是,免费额度池恢复了用户频繁迭代、敢于多改几版的意愿,因为真正昂贵的不是 AI 本身,而是额度见底时人被迫降低标准。最后给出安装方式与适用人群,并提醒此类方案依赖厂商政策,商业项目仍应保留付费通道。
DeepSeek Harness 这类 agent 工具用起来爽,但账单也让人肉疼。B站 UP 主 PaulusA梦 分享了一个思路:装一个插件,把 36 家厂商、635 个模型的免费额度汇总成一个池子,按需自动切换。这期内容就围绕这个插件,聊聊 agent 为什么这么费 token,以及免费额度池到底解决了什么问题。
Agent 为什么比聊天框费钱得多
DeepSeek广告 Harness 不是聊天框,是 agent。你给它一个任务,它会自己拆步骤、读文件、改代码、跑命令、看结果,再回头改。一个像样的任务来回十几轮很正常。UP 主举了个很典型的例子:让它修一个 bug,它顺手修了三个,结果又把第一个 bug 改回去了——这四轮每一轮都是成本。
所以 agent 的账单不是聊出来的,是试错试出来的。越想把活儿干好的人,试错次数越多,账单越大。这不是你不会用,恰恰是因为你太想把事情做好。
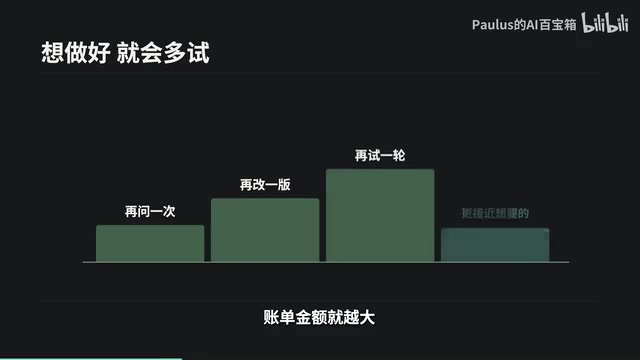
Agent 与普通聊天框的成本差异,根源在于token 消耗模式不同。聊天框是一次问答对应一次模型调用,输入输出量基本可控;而 agent 采用「规划—执行—观察—再规划」的循环,每一轮都要把系统提示词、工具定义、历史对话、文件内容和命令输出重新塞回上下文。上下文会随轮次不断累积,导致后续每一轮的输入 token 都包含前面所有轮次的记录,成本呈近似平方级增长。此外,agent 调用工具(读文件、跑命令)返回的结果同样计入 token,长文件或长日志会迅速撑大上下文。因此 agent 的账单本质上是「上下文膨胀 + 多轮循环」共同作用的结果,这也是为何同样的模型,用在 agent 场景下费用会远高于聊天场景。
插件做了什么:一个免费额度池
这个插件本身不是又一个 AI,而是给 DeepSeek Harness 增加一个能力:把 36 家厂商、635 个模型的免费额度登记在册,组成一个池子。装完后界面里会出现 API 信息,一行代码都不用改。
池子的运转逻辑很朴素:谁限流了就自动换下一家。每分钟多少请求、每天多少 token,插件自己记账;花了多少额度,它比用户还清楚;每天该去哪家签到领额度,它也能自动完成。UP 主用了一个很形象的比喻——就像小区里三十几户人家的 WiFi,密码你全都有,信号弱了自动换一家,区别只是连 WiFi 要偷偷摸摸,用额度不用。
理解这个池子需要先了解各厂商免费额度的两种常见限制方式:RPM(每分钟请求数) 和 TPM/日额度(每分钟或每日 token 上限)。前者限制调用频率,后者限制总量。插件所谓的「记账」,就是维护一个本地计数器,实时跟踪每家厂商已用掉的请求数和 token 数,当某家触及限额或返回 429(限流)状态码时,自动把请求路由到下一家仍有余额的厂商。这种机制在工程上通常称为多provider 故障转移(failover)与负载均衡。签到领额度则是对部分厂商「每日登录赠送额度」规则的自动化,通过定时任务完成。需要说明的是,这类池子的可用性完全依赖各厂商的公开政策和接口稳定性,并非官方支持的能力,属于社区侧的聚合方案。
四笔账:文本、看图、生图、生视频
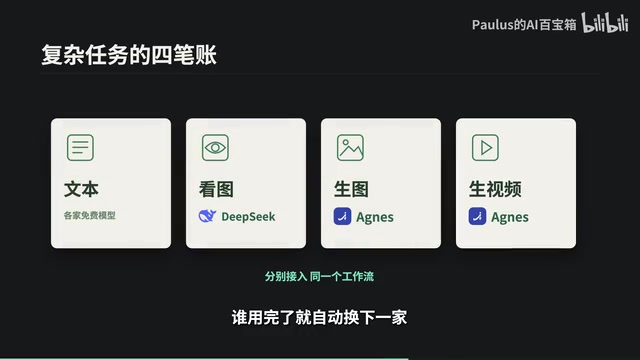
很多人一听免费额度,以为只是聊天额度。实际上一个复杂任务要消耗四类额度:写东西的文本额度、看图的额度、生图生视频的额度。插件把这四笔都接了——文本靠各家免费模型,看图靠 DeepSeek 自带的多模态模型,生图和生视频靠 Agnes,谁用完了就自动换下一家。
这里有一个值得注意的细节:文本、视觉理解、生成式内容三条链路被拆开配置,意味着不同能力可以由不同厂商的免费额度兜底。对做多模态任务的用户来说,这个覆盖面比单纯的文本额度池实用得多。
多模态任务中的「四类额度」对应的是不同模型能力:文本生成由大语言模型承担,负责推理、写代码和规划;视觉理解(VLM) 让模型能「看懂」截图、图表和 UI 界面,是 agent 操作图形界面或分析图片时必需的能力;图像生成和视频生成则属于生成式模型,输出的是像素内容而非文字。这四类能力通常由不同架构的模型提供,计费方式也各不相同——生成式内容往往按张数或秒数计费,成本显著高于文本。将三条链路拆开配置的意义在于:当某一类额度耗尽时,只影响对应能力,而不会让整个任务中断,用户可以为每一类能力单独指定备用厂商,从而实现细粒度的成本控制。
真正省下的不是钱,是试错的勇气
UP 主没有报具体价格,因为各家差价太大。但他提出了一个更重要的观点:比钱更贵的是另一件事——额度快见底时,人会本能地省着用。少问一句,少改一版,"差不多就这样吧"。改到第七版的时候跟自己说算了能用就行,这才是使用 agent 真正贵的地方:它不光学你的钱,还在逼你降低标准。
现在四笔额度都有人替你付,你就敢让它再改第八版、第九版。UP 主的判断是:在 DeepSeek Harness 上花的钱,大部分不是花在 AI 贵,而是花在你不敢多尝试。
安装与适用人群
配置大约需要 20 来分钟。装法很简单:在插件市场里直接搜,链接在视频简介里;如果给 DeepSeek Harness 足够权限,也可以直接让它自己去安装。
适合谁:高频使用 agent、经常因额度焦虑而缩减迭代次数的开发者。需要提醒的是,这类免费额度池依赖各厂商的限流与签到规则,稳定性和长期可用性会随厂商政策变化,敏感或商业项目仍建议保留付费 API 作为主通道。
相关推荐

Zed编辑器发布v1.29.2:一次常规版本迭代的观察
Zed编辑器发布v1.29.2补丁版本,由@JosephTLyons完成版本升级,提交经GitHub签名验证。本文梳理该版本的基本信息、补丁版本的含义以及对用户升级的实际建议。

Anthropic IPO遭质疑:Hacker News热议其上市时机
Hacker News出现「Just say no to Anthropic's IPO」帖子,引发对Anthropic上市时机与AI公司资本化的讨论,涉及估值泡沫与使命独立性等议题。

Genie 4世界模型上手:像木偶师一样实时导演世界
Google DeepMind 世界模型 Genie 4 深度解析:Special Guest X 实测展示如何用提示词实时导演场景、通过 Project Genie 构建自定义交互应用,以及提示词即种子的可复现设计。