TokenEconomizer:外部控制器如何削减Coding Agent成本

TokenEconomizer以黑盒外部控制器方式为Coding Agent削减跨任务重复Token消耗。
文章介绍了 TokenEconomizer 这一面向 Coding Agent 的外部成本控制器。它针对单任务评测无法捕捉的"环境依赖型重复 Token 消耗"问题——Agent 在跨仓库任务序列中反复重新发现测试命令、工具调用方式等环境知识。方案不改模型权重也不改 Agent Loop 代码,而是通过 Instruction Prefix、Loaded Tools 和 Live Event Stream 三个接入点以黑盒方式介入,落地为微技能注入、工具裁减和失败循环干预三类机制。实验覆盖 277 个 SWE Bench 任务、102 个 Web Bench 任务和 200 个安全审计任务,成本节省 18.4% 到 100%,且在不同仓库与 Agent Model 配置下保持一致。文章还对比了 Caveman 与 Ponytail 的接入点差异,并指出其效果受限于 Agent 暴露接口的丰富程度。
为什么Coding Agent需要"外部"成本控制器
Coding Agent在跨任务序列中会产生一种单任务评测无法捕捉的浪费:环境依赖型重复Token消耗。当Agent连续处理多个仓库任务时,它会反复重新发现已有的环境操作知识——比如某个仓库的测试命令怎么跑、某个工具该怎么调用——而无法跨任务复用这些经验。
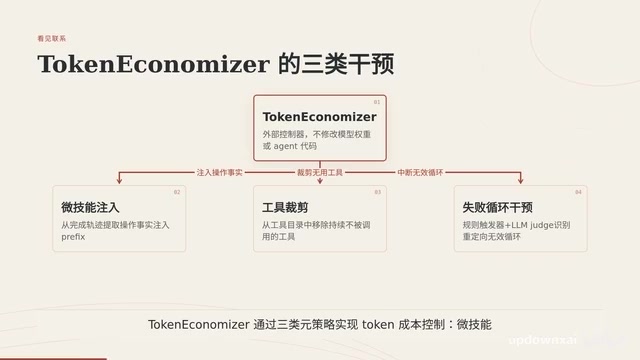
TokenEconomizer提出的解法很特别:不改模型权重,也不改Agent的loop代码,而是把Agent当作黑盒,通过一个外部控制器从Instruction Prefix、Loaded Tools和Live Event Stream三个接入点与Agent交互。据B站对该项目的介绍,它通过三类干预机制控制Token成本。
三类干预机制拆解
微技能注入:把操作事实变成可复用资产
微技能注入(Micro Skills)是这套方案里最有意思的一环。它从已完成轨迹的摘要中提取候选操作事实,再将这些事实激活为Micro Skills,供后续任务直接使用。换句话说,Agent在第一个仓库里摸索出的环境知识,会被沉淀下来,在下一个仓库任务里不必从零开始。
这针对的正是跨任务序列中重复消耗的根源:Agent不是能力不够,而是经验没有被结构化地保留。
Instruction Prefix 是指在对话或任务开始时注入给模型的系统提示或前置指令部分。在 Agent 架构中,它通常承载角色设定、行为约束和工具使用规范等静态信息,并且会随每一轮交互被重复送入模型上下文,因此是 Token 消耗的固定成本项。TokenEconomizer 选择在这一位置注入 Micro Skills,相当于把跨任务积累的环境操作知识写进每次任务的前置指令中,让 Agent 在推理前就获得"这个仓库的测试命令是什么"这类事实,而无需在交互过程中反复试错发现。这种做法的优势在于不改动 Agent 的推理循环,仅通过上下文组装阶段的内容调整就能生效,因而对 Agent 实现保持透明。
工具裁减:移除持续不被调用的工具
工具目录本身也是Token开销的来源。TokenEconomizer的工具裁减策略会从工具目录中移除持续不被调用的工具,减少不必要的工具加载。项目通过不同Agent的插件接口实现这一能力,因此仍不需要改动Agent本身的代码。
Loaded Tools 指 Agent 在运行时实际加载进上下文的工具定义集合。在支持插件化工具的 Agent 框架中,每个工具的 schema、描述和参数说明都会占用可观的 Token,工具目录越大,这部分固定开销越显著。更关键的是,工具定义通常每轮对话都要随上下文一起发送,其成本会随交互轮次线性累积。TokenEconomizer 通过 Agent 的插件接口动态调整这一集合,将长期未被调用的工具移出加载列表,从而在不影响 Agent 代码的前提下压缩每轮请求的体积。这一机制对工具数量多、调用分布集中的工作流收益尤其明显,但也要求 Agent 框架暴露可编程的工具加载接口,否则裁减策略无从落地。
失败循环干预:规则加LLM Judge双保险
Agent陷入失败循环时,Token会持续燃烧而进展有限。这一机制基于规则触发器和LLM Judge双重机制来判断何时介入。规则触发器负责快速、低成本的模式识别,LLM Judge则承担更复杂的判断,两者分工降低了误判和漏判的风险。
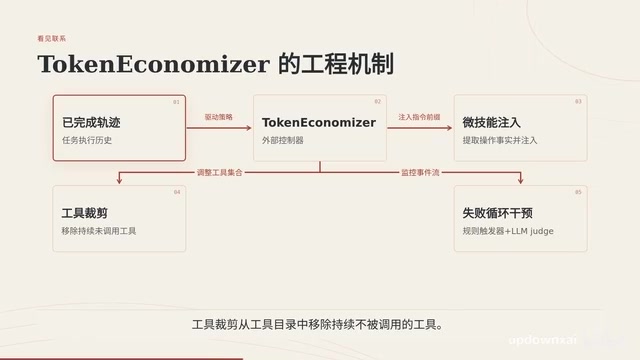
Live Event Stream 指 Agent 运行时产生的事件流,涵盖工具调用、返回结果、错误信息和状态变更等实时信号。外部控制器通过订阅这一事件流,可以在不侵入 Agent 内部逻辑的情况下观察其行为轨迹,进而判断是否出现失败循环、重复调用或进展停滞等异常模式。这是三类接入点中信息最丰富、也最依赖 Agent 可观测性的一项:如果 Agent 框架不对外暴露结构化事件,控制器就难以做出及时判断。规则触发器正是基于事件流中的模式匹配工作,而 LLM Judge 则在规则无法覆盖的模糊情形下补充语义判断,两者共同构成干预决策的输入基础。
接入点的差异决定了能力边界
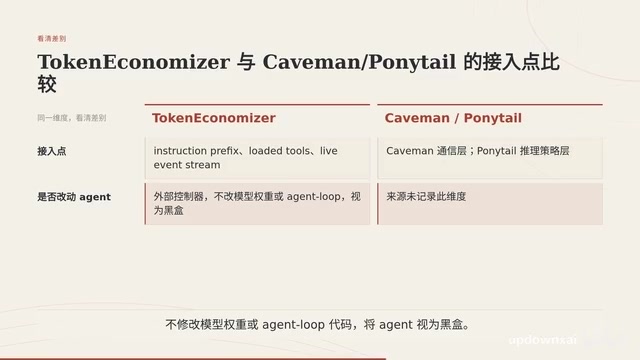
TokenEconomizer把自身定位为外部控制器,这一点与Caveman、Ponytail有本质区别。三者的接入点分别是:
- TokenEconomizer:Instruction Prefix、Loaded Tools、Live Event Stream(控制层)
- Caveman:通信层
- Ponytail:推理策略层
接入点的不同直接决定了机制和效果的不同。控制层接入的好处是通用性强——项目自述可通过不同Agent的插件市场安装,并用配置文件进行配置,不修改模型权重或Agent Loop代码。也正因如此,它能同时适用于多种Agent与Model配置。
实验数据说明了什么
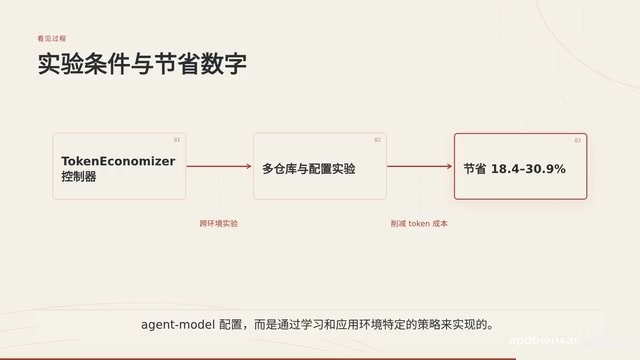
项目在多个Agent Model配置下、针对多个仓库和任务序列进行了实验,结果显示成本节省从**18.4%到100%**不等。更关键的是两点:
其一,节省效果不依赖于特定的仓库或Agent Model配置,在每个仓库和每种配置下都保持一致。其二,实验覆盖面较广,涵盖277个SWE Bench任务、102个Web Bench任务和200个安全审计任务。
这种一致性说明节省不是靠某个仓库的偶然特性实现的,而是通过学习和应用环境特定的策略达成的。
安装与适用场景
落地路径相对轻量:先从GitHub克隆代码库,再通过Claude Plugin Marketplace的添加命令把代码库加入插件市场,最后用安装命令完成插件安装。对于已经在用插件化Agent工作流的团队,这个门槛不高。
从适用性看,TokenEconomizer的价值在长序列、多仓库的Coding Agent场景中最明显——单任务评测看不出它的收益,因为重复消耗本身就是跨任务现象。如果你的Agent工作流经常在不同仓库之间切换,或者工具目录越挂越大、失败重试频繁发生,这三类机制对应的正是三类实际痛点。
值得留意的是,外部控制器的路线也意味着它的效果受限于Agent暴露的接口丰富程度。Instruction Prefix和Loaded Tools这类接入点是否在所有Agent上都同样可用,素材中没有展开,实际部署前需要按自己的Agent做验证。
相关推荐

Daybreak Red部署指南:监督式安全调查参考架构
Daybreak Red参考架构解析:介绍监督式安全调查的安全控制设计、部署配置流程与运行监控机制,为团队落地受控安全调查提供工程参考。

Gemini 4 Neon 登顶 Models Engineering Index 榜首
Gemini 4 Neon 在 Models Engineering Index 上成为新晋第一,Hacker News 社区热议其排名含金量与评测方法。本文梳理榜单变动、社区反应及对开发者选型的实际影响。

苹果自研AI智能体:能替你操作Mac的Agent要来了
苹果据报正在开发可操控Mac的AI智能体,对标Meta Muse、Claude、OpenAI Dots等产品。本文分析苹果在agent赛道的系统级优势、竞争格局与可能的落地路径。