同价不同账单:AI Agent计费陷阱与省钱路由策略

相同token单价下,Agent成本可差10倍,需靠努力档、压缩、缓存与路由控制。
文章指出,三家主流模型标价相同(每百万输入2美元、输出10美元),但在Agent循环中每任务成本可相差10倍以上。原因有三:推理努力档位作用于所有输出token,最大档会让思考token占账单绝大部分;上下文悬崖使跨过272K边界后整个请求被全量重定价;前缀缓存虽能将重复输入降至5%,但时间戳等开头变化会导致全量失效。由于没有单一模型赢下所有步骤——Argon擅长仓库规划、Sonnet擅长终端任务、Sol在常规轮次最便宜——作者提出按四类工作路由的方案,并在24轮修复任务示例中把成本从9.94美元降至1.18美元,节省约88%。
你的AI Agent完成一次任务,返回的代码只有3200个token,约3美分。但账单显示7.56美元。你用的模型每token价格与两大竞品相同,多出来的7.53美元花在哪了?
这是Mainframe频道在一场工作坊中拆解的问题。作者以三个主流模型——Sol、Gemini Fold的Argon、Claude Sonnet 5.5——为例,它们标价均为每百万输入token 2美元、每百万输出token 10美元。把这张表拿给财务团队看,结论会是:三家成本一样。对于一问一答,这个结论勉强成立;对于Agent,它完全错误。
为什么同样的单价,账单能差出10倍
问题出在Agent的循环结构上。Agent不像聊天机器人那样一次问答就结束,它会在一个循环里反复调用工具、读取结果、拼接到历史记录中。每一轮都把完整历史重新提交,每一轮都可能触发推理token、缓存失效、上下文重定价。
工作坊用一组取整的示例数字拆解了一张账单:842,000个未缓存输入token,按每百万2美元计,1.68美元;584,000个推理token(你看不见的“思考”),按输出费率计,5.84美元;加上3美分可见代码,合计7.56美元。你真正读到的输出不到总花费的1%。单价是真实的,但它不是你的账单。
推理token(reasoning tokens) 是模型在给出最终回答前内部生成的"思考"内容,在API响应中通常不可见或单独计费。OpenAI的o系列、Anthropic的扩展思考、Google的Gemini思考模式都属此类。它们按输出费率计费,且往往占Agent总输出的绝大部分——本文示例中推理token占账单的77%。关键在于:推理量由推理努力档位(effort/reasoning level)控制,而该档位作用于每一个输出token,不只是最终文本。因此把努力档调高会成倍放大思考开销,这是单价相同却账单悬殊的首要原因。
陷阱一:推理努力是价格旋钮,不是质量旋钮
三家提供商都提供控制模型“思考多少”的档位。Artificial Analysis用同一组任务跑所有模型,报告每任务成本:Sol为72美分,Argon约2美元,Sonnet 5.5在最大努力档为7.60美元。同样的标价,账单差10倍以上。
Sonnet的钱花在推理上:最大努力档每任务输出约193,000 token,大部分是思考。Anthropic自己的文档说,努力档位作用于每一个输出token——思考、文本和工具调用本身。对于Sonnet 5.5上的Agent编程,文档建议从中等起步,难任务升到高,只在自有评测证明有收益时才用最大档。
把努力档位当作每一步设定的价格旋钮,而不是质量旋钮。一直放在最高档,代价就是10倍账单。
陷阱二:上下文悬崖,跨过一token全量重定价
Agent循环中,每个工具结果都追加到历史,提示词每一轮都在增长。在Sol上,272,000输入token处有一条边界:低于它,正常费率;多一个token,整个请求被重新定价——不是只有溢出部分,是上下文中的每一个token。请求按两倍输入费率、1.5倍输出费率计费。
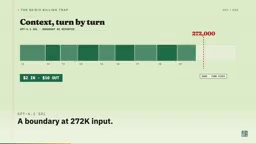
一次在错误时刻读取的大日志文件,就能让你后续每一轮的价格翻倍。工作坊给出的对策是压缩守卫:在250,000 token处触发,保留最近四轮原样,更早的内容完整写入磁盘检查点,提示词中用短摘要替代。压缩会改变提示词,需要重建一次缓存,但这远比跨过悬崖后每轮付双倍便宜。
上下文悬崖(context cliff) 指提示词长度跨过某个阈值后,计费规则从"按实际token线性计费"切换为"整段上下文按更高费率重算"。它与常见的"超出上下文窗口被截断"不同:后者是容量问题,前者是定价问题。典型机制是提供商为长上下文设置分层费率(如超过128K或256K后输入翻倍),但计费基数是整个请求而非仅溢出部分。对Agent而言,历史记录每轮累加,一次大文件读取就可能永久把后续所有轮次推过阈值,造成持续双倍支出。对策是主动压缩:在阈值前用摘要替换旧轮次,并接受一次缓存重建成本。
陷阱三:缓存是最大的隐性折扣,也最容易失效
每一轮循环都在重复提交相同的系统提示、编码规范和工具定义。Sonnet 5.5读取缓存输入每百万10美分,是正常费率的5%;写入缓存2.50美元,缓存条目存活5分钟,每次使用刷新。Sol在提示词至少1,024 token时自动缓存,同样10美分。Argon没有显式缓存,隐式缓存也是10美分,但只在你提示词开头保持不变时有效——改第一行,折扣消失。
Argon的2美元/10美元是介绍价,从12月1日起将变为4.20美元。
另一个常见bug:把当前时间放在系统提示开头。缓存从第一个token开始匹配,时钟一跳,之后每个token都未命中。修复很简单——静态内容在前,变化内容放在断点之后。

前缀缓存(prefix caching) 依赖对提示词从头开始的逐token匹配:只有与上次请求完全一致的前缀部分才能命中缓存并按折扣价计费,一旦某个位置不匹配,该位置之后的所有token都按未缓存价重算。这解释了为什么把时间戳、随机ID或用户输入放在系统提示开头会灾难性地摧毁命中率。工程上的标准做法是"静态在前、动态在后":系统提示、工具定义、编码规范等稳定内容置于最前,可变内容(当前任务、时间戳、检索结果)放在缓存断点之后。缓存条目通常有存活时间(如5分钟),每次命中会刷新计时,因此高频循环的Agent天然受益,而长时间空闲后的首次调用则需重新写入。
没有单一模型赢下每一步:按步骤路由
既然Sol每任务最便宜,为什么不全部用Sol?因为不同步骤有不同赢家。
大型多文件重构:DeepSWE测试模块能否读取整个仓库、追踪跨模块依赖并写出正确的多文件改动。Argon得分77.9%,领先Opus 5.5的74.2%,而Opus每token价格是两倍。需注意,Google用自己的测试框架跑了Argon的分数,竞品分数来自排行榜和系统卡。Argon在金融文档上也领先,Val's finance agent得分65.4%,Claude Fable 5.1为58.9%。
终端任务:Terminal bench把Agent放进真实shell,运行命令、读栈追踪、修包、让测试通过。Anthropic报告Sonnet 5.5为70.6%,独立运行更低——Artificial Analysis测得64,仍领先Argon的57。Val's排行榜上Opus第一、Sonnet第二。厂商数字应读作上限,不是你的平均值。终端场景,Claude领先。
但成本呢?Val's数据显示终端测试每次成本:Sonnet 16.51美元,Argon 17.64美元,Sol仅1.72美元。而常规轮次——传工具JSON、检查状态、选下一个工具——才是循环的大头,正是Sol低每任务成本与廉价缓存输入发挥优势的地方。
安全工作的额外警告:Anthropic的正式模型带有保守的网络安全防护,会拦截较多安全工作。经过审核的防御方可申请网络安全验证计划以获得更少限制。如果你的Agent做合法安全测试,提前规划,别让步骤在运行中途失败。

搭建你的路由器:四类工作,四条路由
工作坊给出了一个可直接放入自有编排器的路由方案。核心思路是把每一步打上四类标签之一:仓库规划、终端循环、状态分诊、命令行安全。
- 规划步骤全部走Argon单次调用:读一次代码库,写出完整计划即交接,不循环。注意Argon的1百万是上下文窗口(输入),输出上限为65,536 token。
- 安全步骤走闸门:若组织未验证,停下并说明原因,转人工,优于中途失败。
- 终端循环走Sonnet 5.5:自适应思考,努力档固定为高,永不用最大档。整个循环内努力档固定,因为Anthropic文档说请求间改变顶层努力会重启缓存。
- 默认步骤(状态检查、工具选择、JSON分诊)走Sol中等努力:自动缓存,缓存键可让你按路由查看命中率。
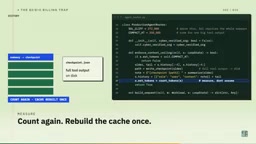
遥测记录要记四个桶而非两个:缓存输入、未缓存输入、可见输出、推理输出。账单飙升时,两个桶无法告诉你究竟是缓存坏了还是Agent开始过度思考,四个可以。
审计检查还应该断言:从第2轮起,在Sonnet或Sol上,断点之前零缓存token意味着有东西变了。这能在上线前抓住最常见的bug。
模型路由(model routing) 指编排器根据任务类型把每一步分派给不同模型,而非全程使用单一模型。其经济性来自两个事实:不同模型在不同能力维度上各有优势,且价格与能力并非线性对应。有效的路由需要三个前提——对步骤做稳定分类(规划、终端执行、状态分诊、安全审查等)、为每类步骤测得质量与token消耗、以及在路由层统一处理缓存与压缩,避免跨模型切换时重复付出缓存重建成本。路由的收益应按"每任务总成本"而非"每百万token单价"衡量,因为便宜模型在长循环中省下的往往是数量级而非百分比。
路由省了多少:一个24轮修复任务的对比
同一个24轮bug修复,两种跑法。单模型最大努力加时间戳破坏缓存:1.92百万未缓存输入token、610,000推理token,9.94美元。路由后:第1轮Argon映射仓库,第2至18轮Sonnet高档缓存运行修复,第19至24轮Sol格式化PR并更新工单——185,000未缓存token、1.73百万缓存token、64,000推理token,1.18美元。示例中省了约88%。
这里的启示不是每百万token的价格,而是每个完成任务烧掉的token数。记录四个桶、封顶努力档、在悬崖前压缩、在预发环境断言缓存命中、让每一步用最少token路由——这才是Agent成本控制的正确单位。
相关推荐
WebMCP安全指南:三个注解让AI代理更安全
Chrome团队演示WebMCP工具的三种安全注解:readOnlyHint消除无效确认弹窗,consequentialHint强制高危操作人工确认,untrustedContentHint抵御间接提示注入,一两行代码即可提升AI代理安全性。

湍流为何是流体力学最难问题?AI或成破局关键
湍流为何是流体力学最难问题?本文基于Lex Fridman播客对话,解析湍流的多尺度本质、经典物理热力学的对比,以及AI通过发现坐标变换来简化湍流描述的可能性,探讨涡旋形成与数学物理的交汇。

R.L. Stine谷歌访谈:恐怖大师如何点燃儿童阅读热情
R.L. Stine在谷歌访谈中分享从喜剧转向恐怖的偶然经历、儿童恐怖创作原则、手机对叙事的冲击,以及如何用Goosebumps激发儿童阅读动机。