同一AI两个开发者,网站速度差距在哪?
互换AI模型后网站速度排序不变,说明性能差距源于工程配置而非模型本身。
文章讲述了一个对照实验:两位开发者分别用 Cloud 和 Codex 模型搭建网站,Cloud 一方的网站明显更快。为排除模型因素,两人互换模型重新构建,结果速度排序并未反转,原开发者的网站依然更快。这说明网站性能的瓶颈不在 AI 模型层,而在于缓存策略、构建产物优化、服务器配置、静态资源处理等工程环节。作者据此提出一份可复用的检查清单:启用服务器端缓存、运行 Lighthouse 审计、按报告逐项修复。核心结论是,把性能检查固化进开发流程,比反复切换模型更能带来实际的速度提升。
两个开发者用同一个AI写代码,一个用Cloud模型,一个用Codex模型。测试后,Cloud一方的网站明显更快。但他们互换模型后,结果依然是原来那位开发者的网站更快。差异不在模型,而在几个工程细节。
模型互换后,速度差距依旧存在
视频里做了一组对照实验:开发者A用Cloud模型,开发者B用Codex模型,各自搭建网站。第一轮测试中,A的网站加载速度明显优于B。
为了排除模型本身的影响,两人互换了模型——A改用Codex,B改用Cloud,重新构建。按理说,如果速度差异来自模型,结果应该反转。
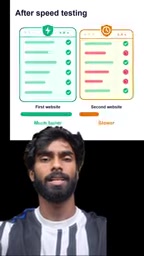
但测试结果显示,A的网站依然更快。也就是说,换模型并没有改变性能排序。
真正的差距不在AI,而在工程配置
这个结果指向一个容易被忽略的事实:AI模型生成的代码质量固然有差异,但网站性能的瓶颈往往不在模型层,而在部署和优化环节。
两位开发者用的模型相同、任务相同,但交付的网站在速度上拉开了差距。这说明决定性能的是代码之外的东西——缓存策略、构建产物的优化程度、服务器配置、静态资源处理方式等。AI可以写出功能正确的代码,但不会自动帮你做性能调优。
一个常见的误解是“换个更强的模型就能写出更快的网站”。这个实验恰好证伪了这一点:同一个模型交给不同的人,产出的性能可以差出一截。
服务器端缓存是提升响应速度最直接的手段之一。其基本思路是:首次请求时由服务端完成渲染或数据查询,将生成的 HTML 或接口结果存入内存(如 Redis)或磁盘,后续相同请求直接命中缓存返回,跳过完整的渲染流程。常见的策略包括设置合理的 TTL(过期时间)、基于 URL 或查询参数生成缓存键、以及在内容更新时主动失效缓存。对于静态站点,还可以结合 CDN 做边缘缓存,让请求在离用户更近的节点就被响应。缓存配置不当的风险是返回过期内容,因此需要区分哪些页面可以长期缓存、哪些必须实时生成。
一份可复用的性能检查清单
视频作者在结论部分给出了一份checklist,用于排查和提升网站性能:
- 启用服务器端缓存:让重复请求不必每次都走完整渲染流程,减少响应时间。
- 运行Lighthouse广告审计:用Lighthouse对页面做系统性检查,定位性能、可访问性等方面的问题,再按报告逐项修复。
- 按审计结果跟进修复:拿到Lighthouse的评分和建议后,针对性地处理高优先级项,而不是凭感觉优化。
这三步不依赖特定AI模型,属于通用的工程实践。无论用Cloud还是Codex,做完这些配置的网站都会更快。
Lighthouse 是 Google 开源的自动化网页质量审计工具,集成在 Chrome DevTools 中,也可通过命令行或 CI 环境运行。它针对单个页面从性能、可访问性、最佳实践、SEO 等维度打分,其中性能分数由 First Contentful Paint、Largest Contentful Paint、Total Blocking Time、Cumulative Layout Shift 等 Core Web Vitals 指标加权计算得出。报告会列出具体可优化的项,例如未压缩的图片、阻塞渲染的脚本、未使用的 CSS 等。需要注意的是,Lighthouse 在本地模拟环境下的分数与真实用户数据存在差异,因此更适合作为定位问题的起点,而非唯一的性能标准。
对AI辅助开发的启示
这个实验的价值在于把“AI写代码”和“网站性能”两件事拆开了。模型负责生成逻辑,性能取决于工程决策。开发者如果只关注提示词和模型选择,很可能在功能完成之后才发现页面加载慢,而问题根源往往是一开始就没配置缓存、没跑过审计。
把性能检查纳入开发流程——比如在部署前固定跑一次Lighthouse、默认开启服务端缓存——比反复切换模型更能带来实际的速度提升。视频作者也在描述区提供了完整提示词,感兴趣的读者可以自行取用。
构建产物优化是前端性能的另一条主线。现代框架在构建时会生成大量 JS/CSS 文件,若不处理,首屏需要下载和解析的资源会显著拖慢加载。常见做法包括:代码分割(按路由或组件拆分,首屏只加载必要代码)、Tree Shaking(移除未被引用的导出)、压缩与混淆(减小文件体积)、资源指纹与长期缓存头配合使用。此外,图片应转为 WebP/AVIF 等现代格式并按需设置尺寸,字体可做子集化或用 font-display 控制加载行为。这些步骤大多可以在构建工具链中一次性配置好,属于“做一次、长期受益”的工程投入。
相关推荐
 科技前沿
Memorias:用AI传记作家把你的故事变成书
Memorias 是一款 AI 传记作家工具,通过对话式访谈将你的口述故事整理成回忆录,自动映射人物、地点与年份,支持照片与 EPUB/PDF/DOCX 导出,按次付费。
 科技前沿
mamitsu:让社交视频自动转成JSON的API与MCP
mamitsu是一款在Product Hunt上发布的API和MCP服务器,能将社交视频中的画面、音频和配文解析为JSON结构化数据,适用于食谱提取、产品信息抓取等开发者场景。
 科技前沿
GitHub日报·11月08日:Agent 基础设施全面开花
Deep dive into 7 new GitHub trending projects today