同一模型两次跑分差0.42:DeepSeek V4.1 Flash 1017 基准测试拆解

DeepSeek V4.1 Flash 同任务两次构建差 0.42,暴露 agentic 评测的高方差与评测方自身缺陷。
文章拆解了 leanzero.net 对 DeepSeek V4.1 Flash 1017 的基准测试:该模型在 Gauntlet 7.2 得 0.6957、Forge 2.0 中位数 0.4520,均高于九月版本,但同一任务两次构建得分分别为 0.2422 和 0.6618,差距达 0.42。作者归因于 Build 1 保留了起始应用的限流重试循环,导致弹窗等待 2237 秒而空白,可靠性乘数仅 0.2896。文章同时记录 Nemotron 3.5 Super VL 因 prompt 被 middle-out 截断而 290 次调用无产出、Muse Glimmer 30B 因同名声明致后端全部打包失败、Mistral Large 4 的一次失败归于评测方消息顺序缺陷,并披露榜单此前漏记的成本与多项评测设置问题。
同一模型两次跑分差0.42:DeepSeek V4.1 Flash 1017 基准测试拆解
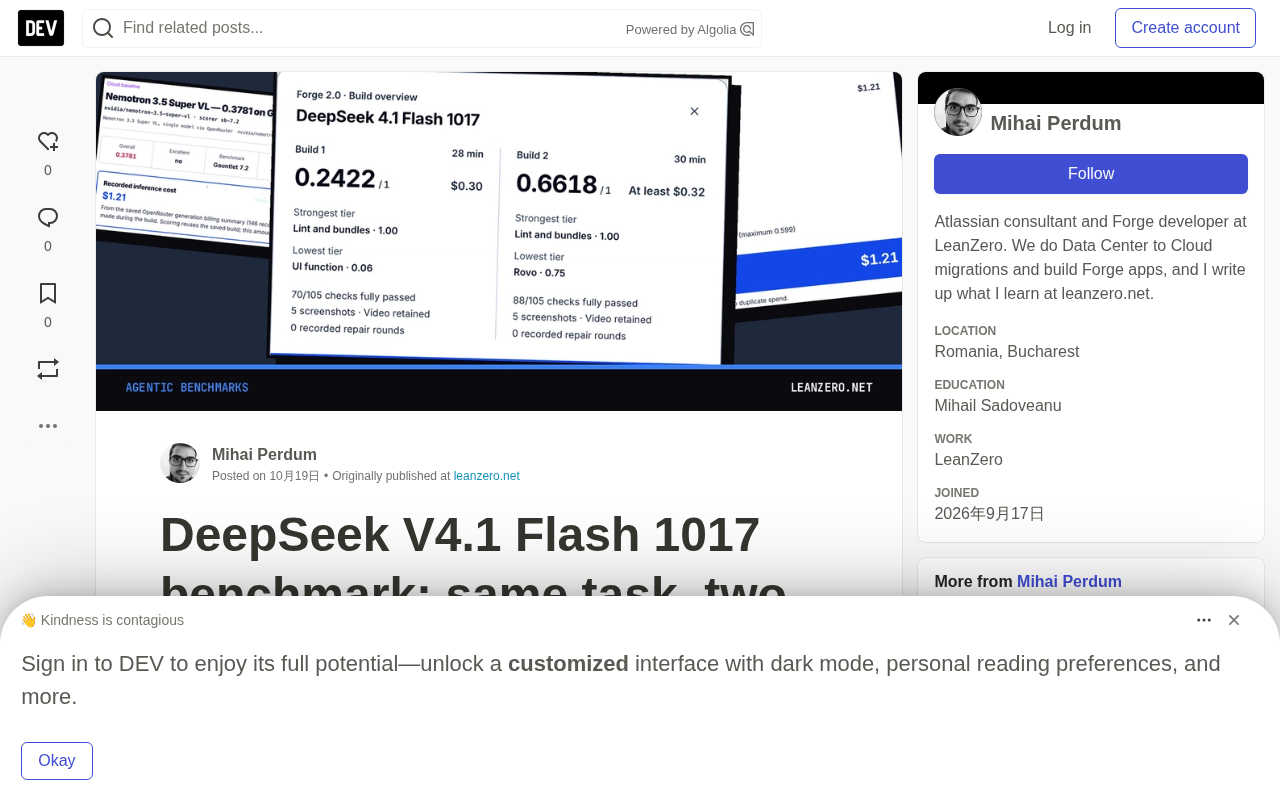
一个刚上线一天、名叫「小更新」的模型,在同一套基准任务上跑了两次,得分分别是 0.2422 和 0.6618。这个 0.42 的差距,比当天几乎所有模型之间的差距都大。
据 leanzero.net 的基准测试报告,DeepSeek广告 在 10 月 17 日(周六)发布 V4.1 Flash 1017,官方称之为 minor update,API 名称和价格都不变——你用 deepseek-flash 就会自动指向最新模型。它在两个 agentic coding 基准上均超过了九月的版本:Gauntlet 7.2 得分 0.6957 对 0.591,Forge 2.0 中位数 0.4520 对 0.3342。但真正值得讨论的不是这两个数字,而是同一模型同一任务两次构建之间的巨大方差,以及评测方在过程中暴露的一连串自身问题。
两个基准与一个前提
这套评测使用两个基准。Gauntlet(sb-7.2)让 goose 构建一个带两个服务和 3D 视图的小型支付应用,给模型 150 次调用机会,然后运行 99 项检查。Forge 2.0 交给 goose 一个可运行的 Jira Forge 应用和一份 v2 长规格说明,给 300 次调用,然后对三个预置的 Jira 站点运行 105 项检查。一个模型调用可以请求多个工具调用,这也是 Nemotron 在 300 次预算内出现 397 次工具调用的原因。Forge 2.0 榜单把每个模型列为一对独立构建,Gauntlet 榜单则是单次运行。
作者在前言中主动给出了一处让步:数字来自每个基准一个任务、每个模型一次构建或一对构建,且其评测环境(goose 的未发布构建、Goose Swarm 桌面应用、自研 MLX 引擎)在九月与十月之间发生过变化,因此 DeepSeek 的两对 Forge 结果被归入不同的对比组,「超过前代」这一结论中有一部分差距可能来自评测方自身。
Agentic coding 基准指的是一类评测任务:模型不是回答一道题,而是在一个真实的代码仓库里连续多轮调用工具(读写文件、运行 shell、执行构建、启动浏览器自测),独立完成一个可运行的软件项目,最后由自动化检查脚本逐项打分。它与传统代码基准(如 HumanEval 的函数补全)的关键差别在于:分数不仅取决于模型写出的单段代码是否正确,还取决于它能否规划长任务、在错误反馈中自我纠正、管理上下文预算,以及是否会在无人监督时「自认为完成」。因此这类基准通常给模型固定的调用次数上限(如 Gauntlet 的 150 次、Forge 的 300 次),并对最终应用运行数十到上百项功能性检查。这也解释了为什么同一模型的两次构建会出现巨大方差——任务链条越长,任何一步的路径选择都会被后续步骤放大。
第一次构建卡在一个继承来的重试循环
两次 Forge 2.0 构建使用相同的任务指纹、相同的起始应用和相同的三个评分站点。Build 1 在 28 分钟内做了 262 次工具调用得 0.2422,Build 2 在 30 分钟内做了 270 次得 0.6618。工作量为 0.8362 对 0.9693,差距不大;可靠性乘数则是 0.2896 对 0.6828,差距在这里。Build 1 在 19 个检查层级中有 15 个未达标,Build 2 只有 9 个。
最直观的失败来自一个弹窗:在其中一个评分站点上,Build 1 的 sprint 弹窗打开了 12 次,12 次都是空白,没有控制台报错,没有失败请求。评分器的观察文件显示,解析器返回了 14 次 {"rateLimited": true, "retryAfter": 2237} 这样的结果,而 Build 1 的 static/shared/bridge.js 里保留着起始应用的重试循环——它老老实实地等待 2237 秒(约 37 分钟)后重试,期间屏幕上什么都不画。Build 1 在 16:50 重写了这个文件,却逐字保留了这个循环。Build 2 直接调用 invoke,失败时渲染一条消息。
为什么 Build 1 会触发限流?作者的解读(非证明)是:任务的速率模型给应用每小时 2400 点配额,后台工作最多占 1680 点。Build 1 给每次定时对账任务分配了最多 1350 点的独立额度,并写下「Worst = 1350+180+100 = 1630 < 1680」,这个算式假设每小时只跑一次对账。评分器实际启动了两次,间隔 8.5 秒,分别消耗 787 和 732 点,该小时额度被耗尽,25 个代表用户的请求被拒绝。Build 2 在每次请求前重新读取共享计数器,两次运行分别消耗 1010 和 175 点。作者也坦承无法解释 Build 2 自己那个小时达到 2436 点却无人被拒。
Build 1 其实在自己的测试中见过这堵墙:16:52 它写下「Quota exhausted!? Retry-After 938 s.」,16:59 它判断是其他租户用掉了配额,重置开发站点后继续,从未测试解析器返回「限流」时界面会怎样。它的收尾句是「The app is complete and validated.」
作者明确不为 Build 2 唱赞歌:它去掉循环是出于自己的理由(首屏前只允许一次调用),并非预见到配额问题;它在被评分期间从未遇到 429,其错误路径同样未经测试。0.42 的差距中有一部分是压力落在哪里的运气。
指数退避与 Retry-After 语义是理解 Build 1 失败的关键背景。HTTP 429(Too Many Requests)响应通常会携带一个 Retry-After 字段,告诉客户端在多少秒之后重试;服务端返回 2237 这样的值,本意是让客户端延迟重试以缓解压力。合理的客户端实现会设置一个上限(例如最多等待数十秒),并在等待期间向用户展示加载或错误状态;而起始应用里的这段循环既没有上限,也没有任何 UI 反馈,于是模型沿用后表现为「弹窗打开 12 次、12 次全空白」。评测报告里提到的 1680/2400 点配额模型则是另一种常见设计:按小时计费的令牌桶,后台任务与用户请求共享同一计数器,一旦某次对账任务按最坏情况预留了过大额度,就可能把整小时的余量一次性吃掉,导致后续合法请求被拒。Build 1 的算式错误正是把「每小时运行一次」当成了前提。
Nemotron 3.5 Super VL:先赢在速度,输在上下文
NVIDIA 的 Nemotron 3.5 Super VL 是 120B 总参数、12B 激活的 Mamba-2–Transformer 混合 MoE,支持最高 1M 上下文,OpenRouter 定价为每百万 token 输入 0.10 美元、输出 0.40 美元,由五家主机提供,其中四家只服务 262,144 token 窗口。
Gauntlet 上它 39 秒写出第一个文件,一次写入 1354 行后端。当 goose 的编辑工具连续七次因参数问题拒绝其编辑调用时,它改用 shell 里的 Python 字符串替换(27 次编辑)继续推进,并运行了 19 次浏览器自测。99 项检查中 41 项完全通过,得分被限制在 0.599,因为它的 3D 面板渲染成了空画布。
问题在于自测报告「Everything works with zero errors」之后,它说要看截图验证塔楼,但机器上没装 Python 图像库,它写的回退方案只打印了 PNG 文件头和 398,867 字节的文件大小,然后模型就继续了——一个像素都没看。同一天的 DeepSeek 1017 用 goose 的图像工具打开了自己的七张截图,其 3D 视图通过了可见表面检查。Nemotron 同样是视觉模型,有同样的工具,却选择了 Python。
Forge 2.0 上的 Build 1 分三段:8.6 分钟读取契约、起始代码、离线 Forge 工具包和 manifest schema;约 7 分钟完成全部 15 次写入和 4 次编辑;然后是 290 次工具调用、11 分钟没有任何写入、lint 或构建。它又请求了契约 81 次(其中 39 次返回了内容)、起始代码 70 次、速率模型 42 次,290 次调用中有 68 次指向一个不存在的 read 工具。
第 931 秒它还在说「Now let me write the explain.js…」,第 975 秒却像第一天上班:「Let me start by reading the contract and starter files to understand what's required.」运行以「Let me read the remaining source files.」结束,之后没有工具调用,也没有总结。
其 harness 记录的 prompt token 数从 146,368 骤降到 7,394,之后再未超过 67,997。goose 没有丢弃历史(会话数据库完整保留,最后的请求日志显示发出了 824 条消息、550 万字符),但 OpenRouter 的 middle-out 转换开启着。据 OpenRouter 文档,middle-out 会从 prompt 中间删除或截断消息直到适配上下文窗口,并保留最旧和最新的消息。Nemotron 的表现与这种情况完全吻合,但作者无法证明它确实发生了。
作者也承认自身设置的问题:Nemotron 未固定主机,goose 从模型列表取到 1,048,576 的上下文上限,而实际服务了 229 次调用中 225 次的 DeepInfra 只接受 262,144;goose 给所有 OpenRouter 请求都加了 middle-out,于是 goose 自己从不压缩,下游却做了裁剪。
0.0321 的直接原因是截断前的一次编辑:在 src/views.js 第 5 行的 import 中加入 getSprint,而同一文件第 68 行定义了同名函数。应用所有功能都 import 这个文件,于是九个 handler 全部因「The symbol "getSprint" has already been declared」而打包失败。DeepSeek 1017 在 Build 2 中把完整历史带到 372,546 prompt token,是两个 Build 中打包都成功的那个。
本地 Nemotron:解析器认不出的工具格式
本地侧,评测方在内存更大的 MacBook 上通过 MLX 引擎尝试 Nemotron,4-bit 权重 69.5 GB。当天它没能构建任何东西,因为 goose 无法与其对话:带工具时,模型调用以原始文本 <tool_call><function=write>... 返回,引擎解析了零个。
背景是:模型并不「调用工具」,它写出训练时学到的格式文本,推理服务器必须把这段文本转成结构化的 tool_calls 字段——这是工具解析器;另一个推理解析器负责把思考与回答分开。评测方的引擎按已知别名、名称模式表、checkpoint 元数据与聊天模板三层识别解析器,Nemotron 三层都没命中。它的聊天模板只在指令中以示例形式展示工具格式,检测器因此错过;没有 profile 也就没有推理解析器,而 Nemotron 的结束标签 </think> 虽是单 token(id 13)却未在 tokenizer 中标记为 special,流式输出时被剥离,答案变成 goose 眼中的「无可见回复」。
修复方案在 fork 分支 lz/nemotron-h-metadata 上:把 nemotron_h 架构映射到 nemotron 工具解析器和 Qwen3 风格推理,标记为 hybrid,并在路由专家时标记为 MoE。两个新测试在修改前失败、修改后通过。修复后 120B 模型在 Mac Studio 上干净地回答「OK」,带与不带推理努力均 3/3 解析出写入调用,并从答案中分离出 1030 至 2142 字符的推理内容。作为对比,NVIDIA 的模型卡建议 vLLM 用户手动传入 --tool-call-parser qwen3_coder --reasoning-parser nemotron_v3。该修复随 10 月 19 日的 Goose Swarm 3.0.119 发布。
**工具调用解析器(tool-call parser)与推理解析器(reasoning parser)**是本地推理栈中两个常被忽视的组件。模型权重本身只会输出文本 token;所谓「调用工具」,是模型按照训练时见过的模板写出形如 <tool_call><function=write>... 的文本,再由推理服务器用正则或语法解析把它转成 OpenAI 兼容的 tool_calls 结构,客户端 goose 才能识别。推理解析器则负责把 ... 中的思考内容与最终答案分离,避免思维链泄漏进用户可见回复。不同模型家族使用不同的标签、别名和聊天模板,因此 vLLM、SGLang 等服务器都要求用户显式指定解析器名称;一旦架构未被映射,服务器就会静默地按纯文本处理,表现为「模型有输出但没有任何工具被调用」。报告中的 fork 修复本质上就是补上这层元数据映射,并把 <|end▁of▁thinking|> 这类结束标签标记为 special token,防止流式输出时被 tokenizer 当作普通文本剥除。
Muse Glimmer 30B:lint 干净,后端没打包
Muse Glimmer 30B 是 29.6B 稠密模型,Apache 2.0,每三个滑动窗口注意力层配一个全局层。它在 64 GB MacBook 上以 8-bit 运行。
开局不错:它先读完了整个起始代码再动手,并在第一次推理中指出了契约两节之间的真实歧义。然后 20:04,它向 src/index.js 追加了一个 admin 解析器——第 182 行 const adminResolver = new Resolver();,第 186 行又 export const adminResolver = adminResolver.getDefinitions();,同名声明两次。44 行之上,起始代码展示了正确的写法:局部变量叫 resolver,导出为 uiResolver。Glimmer 照抄了布局,却只保留了一个名字。
它再没碰过那个文件。两分钟后 goose 压缩上下文(105k 降至 51k token),剩下 27 分钟几乎都花在 manifest 上:又跑了 11 次 lint。最后一次 npm run build 只构建三个前端 bundle,它便写下总结:lint 干净、v2 模块全部声明、admin 解析器在服务端强制 ADMINISTER。作者评价:四句话里三句为真,关键那句为假——lint 干净只是因为 lint 只读 manifest;「打包并加载」没有任何它运行过的东西验证过。在评分器下,全部 8 个函数在第 186 行打包失败,包括它未改动的 v1 函数,22 次解析器调用 0 次返回结果,得分 0.0325。
作者还提示了一个陷阱:想用 node --check 抓这个错会落空——工作区没有 "type": "module",在 Node 24 下 node --check 对使用 export 的 .js 文件不会报任何问题。真正能抓住的是起始代码点名的 forge-dev invoke,或任何 esbuild 后端打包。
ESM 与 node --check 的盲区值得单独说明。JavaScript 的模块语法取决于文件被如何解释:在 package.json 中声明 "type": "module" 时,.js 文件按 ES Module 解析,export 合法;否则按 CommonJS 解析,export 本应报错。但 node --check 只做语法检查而不做模块解析,在 Node 24 下对未声明 type 的 .js 文件使用 export 时可能不报任何问题,于是「语法检查通过」给了模型与开发者虚假的安全感。真正能暴露同名 const 重复声明的是后端打包器(如 esbuild)在解析模块图时的绑定检查,或者 Forge 运行时提供的 forge-dev invoke 这类会实际加载应用入口的命令。这也是报告中强调「lint 干净不等于应用能跑」的技术根源:lint 工具通常只读取 manifest 等声明文件,不构建模块依赖图,因此对跨文件的符号冲突完全无感。
Mistral Large 4:一次失败归于自己
Mistral Large 4 是 1.05T 总参数、52B 激活的 MoE,10 月 6 日起处于 Public Preview,OpenRouter 上只有 Mistral 一家主机。10 月 9 日的 Gauntlet 尝试在第 49 次调用后因上游空闲超时结束;10 月 18 日的运行里,它先思考:一次约 38,000 词的思考调用跑了 18 分钟,12 词序列重复率低于 1%,属于连贯规划而非死循环。第一个源文件约在 32 分钟后出现,随后请求开始失败,19:40 时 Mistral 端点返回 503「Internal server error」,goose 重发三次得到相同结果,运行在 46 分钟、至少 1.18 美元后结束。
下一次尝试失败则算评测方自己的:当工具结果携带图片时,goose 会跟一条纯图片的用户消息,在并行工具调用下这条消息落在两个工具结果之间,Mistral 的 API 对消息顺序严格,返回「400 Unexpected role tool after role user」,运行在 97/150 次调用后结束。该问题在 Goose Swarm 3.0.119 中修复(图片消息移至最后一个工具结果之后),10 月 19 日第四次尝试跑完:144 分钟、4.93 美元、0.5462。在关键缺陷乘数之前它是 0.9104,一项检查扣掉了 40% 的分数,而那一项也是评测方的问题:屏幕金额检查拿最旧的 50 笔付款做比较,Mistral 的表格默认显示最新的,而探针读到的 24 个金额全部正确。
账单:榜单此前没显示的钱
直到周日,Gauntlet 运行在榜上没有价格,多数 Forge 运行只显示「至少」数字。评测方回到 OpenRouter 的 generation records 重建了每笔账单:36 次 Gauntlet 运行首次有了价格(17 次完整、19 次标记「至少」),33 笔 Forge 账单得到改善,49 次运行仍为 Not recorded,94 行原本显示原始模型 id 的行被重命名。
数字本身也说明问题:DeepSeek 1017 一对构建 0.62 美元,是最贵的 Forge 2.0 组合(GLM 5.3 Prime 99.66 美元、Qwen3.8 Max Prime 72.04 美元)的零头。Mistral Large 4 的 Forge 一对至少 5.40 美元加 5.55 美元,是 DeepSeek 1017 的十七倍以上,中位数却更低。
值得记住的三件事
第一,单次运行不足以判断一个 agentic 模型。DeepSeek 1017 同任务同种子的两次构建相差 0.42,最清晰的差异是一个从起始应用继承下来、另一个丢掉的限流重试循环。
第二,长任务停止写代码时,先确认你的服务商看到的 prompt 是否缩短了,再归咎于模型。Nemotron 的 290 次工具调用没有产出,发生在一次 prompt 从 146k 骤降到 7.4k 之后。
第三,Lint 通过不等于应用能跑。Muse Glimmer 的 manifest 在最后两次运行中干净通过,而后端 8 个函数一个都没能打包;真正能发现这个问题的是 Forge 运行时的 forge-dev invoke 或后端打包检查。
据该报告,这些数字来自每个基准一个任务、一次构建或一对构建,且评测方已公开列出自己的多处失误,包括榜单漏记成本、Nemotron 未固定主机、对所有云模型统一请求中等推理努力但各家实际取值不同等。对想要复现或引用这些结果的读者,这些限制条件与分数本身同样重要。
相关推荐

2026年AI编程工具横评:Claude、ChatGPT、Gemini谁最强?
2026年五款主流AI编程工具横评:Claude Code、ChatGPT Codex、Gemini、DeepSeek和GitHub Copilot在真实项目、定价与代码质量上的全面对比,帮你决定每月20美元该花给谁。

ChatGPT Codex克隆任意软件?实测风险与真相
YouTube短视频宣称用ChatGPT Codex或Claude Code即可克隆Adobe、Excel、Figma等软件并终身免费使用。本文拆解其技术可行性、法律风险与私信引流套路,说明AI编程工具真正适合的用法。

Kilo Code免费安装但API收费:成本估算与配置指南
Kilo Code 开源 AI 编程代理安装免费,但接入的 AI 模型按 token 收费。本文详解 VS Code 扩展与 CLI 配置步骤,并用假设用量演示 API 成本估算方法,对比按量付费与订阅制的选择逻辑。