同一模型跑分差22分:Agent Harness才是关键变量

同一模型换 harness 得分差 22 分,但 harness 并非一切。
文章围绕 agent 开发中常被低估的 harness(运行层)展开。Terminal-Bench 2.0 官方数据显示,Opus 4.6 和 GPT-5.5 在不同 harness 下得分差距均超过 20 分,LangChain 也通过重构 harness 将 Deep Agents 成绩提升 13.7 个百分点。但作者同时呈现反方证据:SWE-Bench Pro V2 论文中 scaffold 仅解释约 0.29% 的结果方差。结论是 harness 的杠杆效应在长链路、多工具任务上被放大,而非决定一切。文章还梳理了五层架构、八种主流方案对比、最小 Python 循环以及成本追踪、权限、沙箱三项被低估的工程细节。
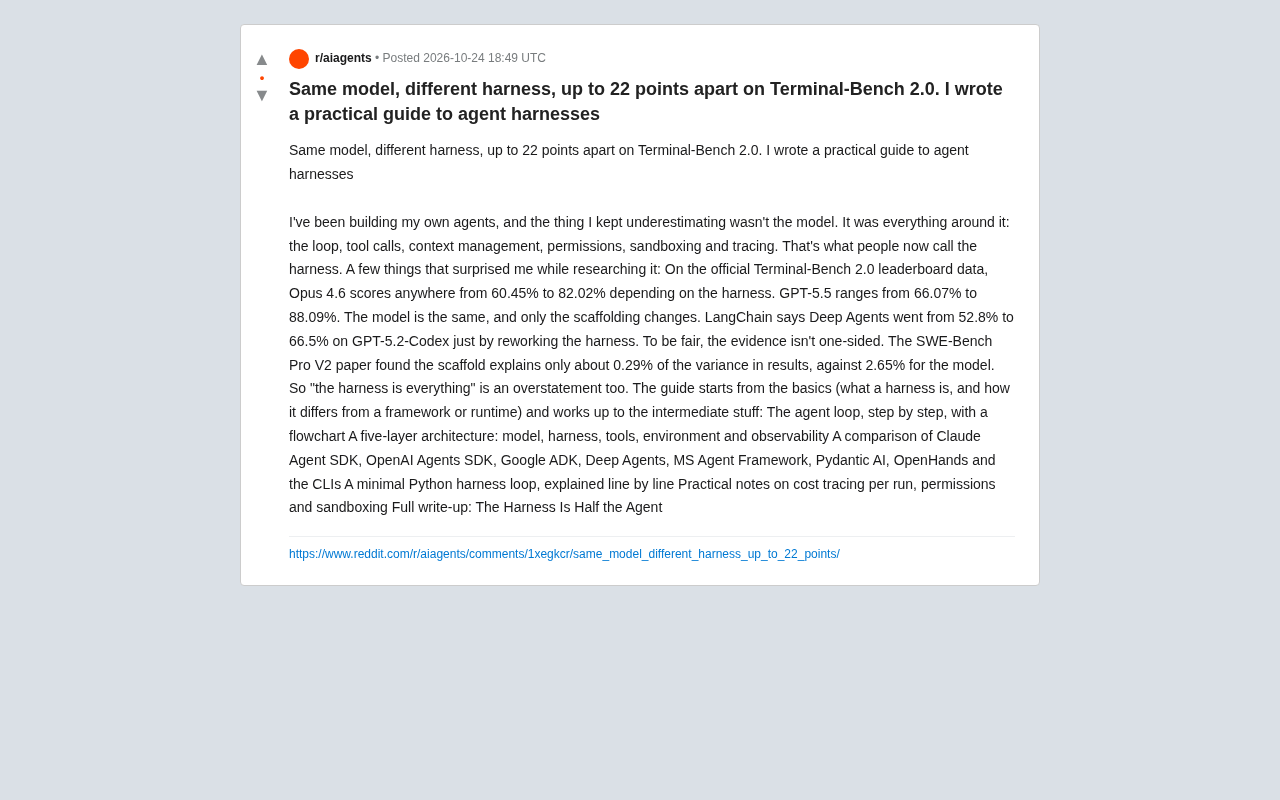
一个模型,同一套权重,仅仅换掉外围的脚手架,Terminal-Bench 2.0 上的得分就能拉开 22 个百分点。这是近期在 agent 开发者社区中引发讨论的一组数据——Opus 4.6 在不同 harness 下成绩从 60.45% 波动到 82.02%,GPT-5.5 则从 66.07% 跨到 88.09%。
一位长期自建 agent 的开发者把研究整理成了一份实践指南,核心观点很直接:大多数人低估的不是模型,而是模型周围那一整套东西——循环、工具调用、上下文管理、权限、沙箱与追踪。这套东西现在有了一个统称:harness。
Harness 到底是什么
按照这份指南的界定,harness 是包裹在模型之外、负责驱动 agent 完成任务的运行层。它和框架(framework)、运行时(runtime)不是一回事:框架提供抽象与组件,运行时负责执行环境,而 harness 关心的是"这一轮怎么推进、下一步调什么工具、上下文怎么裁剪、出错怎么重试"。
作者给出的分层架构有五层:模型、harness、工具、环境、可观测性。模型负责推理,工具负责动作,环境提供沙箱与文件系统,可观测性记录每一步的输入输出与成本。harness 处在中间,是把这些串成闭环的那一层。
Terminal-Bench 2.0 是一个评测 AI agent 在真实终端环境中完成多步任务的基准。它模拟开发者日常的 shell 操作场景,要求 agent 通过命令行工具、文件编辑、进程管理等手段达成目标,而非单轮问答。与侧重代码补全或静态推理的基准不同,Terminal-Bench 2.0 天然强调长链路的循环推进、工具调用准确率和上下文窗口管理——这正是 harness 质量被显著放大的原因。SWE-Bench Pro V2 则聚焦软件工程修复任务,评测粒度与统计口径不同,模型能力在其中占主导。两个基准的结论差异,本质上反映了任务类型对 harness 敏感度的分化。
同一模型,为何分数能差 22 分
官方 Terminal-Bench 2.0 榜单数据最能说明问题。Opus 4.6 的得分区间是 60.45% 到 82.02%,GPT-5.5 是 66.07% 到 88.09%——上下限之间的差距都在 20 分以上,而模型本身没有变化。
LangChain 也提供了类似的案例:Deep Agents 在 GPT-5.2-Codex 上仅通过重构 harness,就把成绩从 52.8% 提升到 66.5%。
这些数字指向一个判断:在复杂任务型基准上,工程实现的质量可能和模型选择同样重要,甚至更重要。
但别急着说"harness 就是一切"
作者在指南中坦率呈现了反方证据。SWE-Bench Pro V2 论文的方差分析显示,scaffold 只能解释约 0.29% 的结果方差,而模型解释了 2.65%。
这两个结论看起来矛盾,实则各自成立:Terminal-Bench 2.0 强调的是终端环境下的多步任务完成,对循环设计、工具调用准确度、上下文窗口管理极为敏感;而 SWE-Bench Pro V2 测量的任务类型与统计口径不同,模型能力仍是主导项。把 harness 说成"一切"是夸大,说成"无所谓"同样是误判。更合理的表述是:在长链路、多工具、强交互的任务上,harness 的杠杆效应被显著放大。
指南覆盖了什么:从概念到可运行代码
这份实践指南的结构从基础概念起步,逐层推进到中级实操:
- agent 循环的分步拆解,配流程图,把"观察—思考—行动—再观察"的每一环讲清楚
- 五层架构的划分:模型、harness、工具、环境、可观测性
- 主流方案横向对比:Claude Agent SDK、OpenAI Agents SDK、Google ADK、Deep Agents、MS Agent Framework、Pydantic AI、OpenHands 以及各家 CLI
- 一个最小可运行的 Python harness 循环,逐行注释说明
- 工程细节:单次运行的成本追踪、权限模型、沙箱策略
其中最小 Python harness 循环这部分值得单独提。很多开发者上手时直接套用现成框架,结果对循环内部的 token 消耗、工具返回值的处理、失败重试的边界缺乏感知。手写一遍最小循环,是把这些隐性成本显性化的最快方式。
对比清单里藏着什么信号
八种方案的并列对比本身就是一个信息量很大的选择。Claude Agent SDK 与 OpenAI Agents SDK 代表两家模型厂商的原生路线;Google ADK 面向自家生态;Deep Agents 走的是可组合的中间层思路;MS Agent Framework 与 Pydantic AI 分别在类型安全和工程规范上做文章;OpenHands 和各类 CLI 则更贴近开发者日常的终端工作流。
这个名单说明 harness 领域还没有收敛到单一标准,各家在抽象层级、权限模型、可观测性接口上的取舍差异明显。选型时真正需要问的不是"哪个最流行",而是"我的任务链路有多长、需要多细的追踪粒度、沙箱隔离要做到什么程度"。
Claude Agent SDK 是 Anthropic 官方提供的 agent 构建工具包,内置工具调用、上下文管理和子 agent 编排等能力;OpenAI Agents SDK 则是 OpenAI 的对应方案,强调轻量编排与 handoff(任务交接)机制;Google ADK(Agent Development Kit)面向 Gemini 生态,提供多 agent 协作与部署支持。Deep Agents 来自 LangChain,定位为可组合的中间层,在模型与工具之间提供规划、子任务拆解等能力。MS Agent Framework 与 Pydantic AI 分别从企业集成和类型安全角度切入。这些方案在抽象层级上的差异,直接决定了开发者对循环内部细节的控制粒度——越是高层封装,越省事但也越难精细调优。
成本、权限与沙箱:被低估的三件事
指南把成本追踪、权限控制、沙箱隔离放在实操部分的收尾位置,这三项恰恰是 demo 到生产之间最容易翻车的地方。
单次运行的成本追踪不只是算钱——它同时是排查循环异常的诊断工具,token 消耗的突然抬升往往意味着上下文管理出了问题。权限模型决定了 agent 能触碰哪些资源,在终端类任务中这一步直接关联安全边界。沙箱则是在出错时限制影响范围的最后一道闸。
这三项都不属于模型能力的范畴,却决定了一个 agent 能否从实验脚本变成可交付的产品。回到那 22 分的差距,答案或许就在这里:分数差异的背后,是这些工程细节的累积。
完整指南原文为《The Harness Is Half the Agent》。
相关推荐
一人量产90集AI漫剧:10小时10块钱的完整制作流程
没有编剧经验也能做AI漫剧:10小时10块钱成本,红果平台单部收益4200元。本文拆解从AI生成剧本、分镜脚本到成片的六步完整流程,附万能提问公式和新手避坑指南。
豆包Agent自制报价测算器:接单报价告别凭感觉
B站UP主用豆包Agent零代码自制报价测算器,输入项目类型、数量、周期即可自动生成报价明细,支持加急与版权买断费率,一键复制发客户,手机端也能随时报价。
WorkBuddy实战教程:10个Agent项目从入门到简历级
WorkBuddy 实战教程解析:用中文交代任务的 AI 工作助手,配置环境比 Codex、Claude Code 更简单。10 个 Agent 实战项目覆盖文件整理、表格汇整、网页生成,新手三步上手,学完可写进简历。