ToolTurns:多轮对话工具使用基准,最强模型成功率仅39.8%

微软ToolTurns基准揭示智能体多轮工具调用短板:单请求成功率近七成,完整对话不足四成。
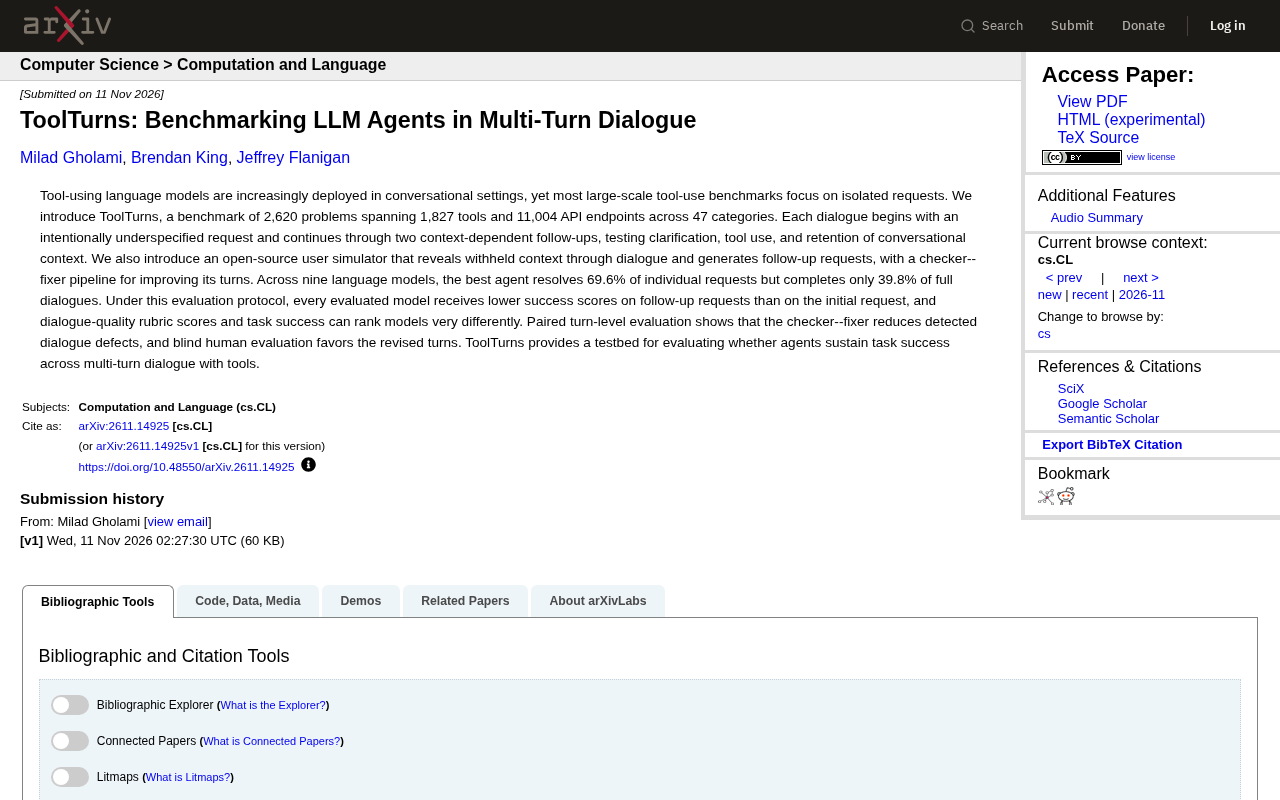
微软研究院等机构发布多轮工具使用基准 ToolTurns,包含 2,620 个问题、1,827 个工具和 11,004 个 API 端点,覆盖 47 个类别。每段对话从刻意信息不完整的初始请求开始,随后进行两次依赖上下文的追问,迫使智能体主动澄清并保持上下文一致。评估九个模型发现,最佳智能体单请求解决率达 69.6%,但完整对话完成率仅 39.8%,且所有模型在后续追问上的成功率都低于初始请求。研究还发现对话质量评分与任务成功率可能给出不同排名。配套开源用户模拟器通过检查-修复流程减少对话缺陷,盲测人类评估更偏好修正后的轮次。
多轮对话中调用工具,一直是智能体(Agent)落地的关键瓶颈。现有的大规模工具使用基准大多聚焦于孤立的单次请求,而真实场景中,用户的需求往往模糊、需要逐步澄清,对话上下文必须被准确继承。微软研究院等机构近日发布的 ToolTurns 基准,正是为了填补这一空白。
ToolTurns 是什么?
ToolTurns 是一个包含 2,620 个问题、覆盖 1,827 个工具和 11,004 个 API 端点、横跨 47 个类别的多轮对话工具使用基准。它的核心设计是:每段对话从一个刻意信息不完整的初始请求开始,随后进行两次依赖上下文的后续追问。这种结构迫使智能体不仅要学会调用工具,还要主动澄清模糊需求,并在多轮交互中保持对话上下文的一致性。
与单轮基准不同,ToolTurns 模拟的是真实用户与助手之间的渐进式交互。初始请求可能缺少关键参数(例如时间范围、地点、对象),智能体需要要么向用户提问澄清,要么基于对话中逐步暴露的信息做出合理推断。
工具使用基准(Tool-use benchmark) 是评估语言模型调用外部工具(如搜索、日历、数据库 API)能力的标准化测试集。单轮基准通常给定一个完整明确的请求,考察模型能否选对工具并填对参数;而多轮基准则要求模型在对话中处理信息缺失、需求演变和上下文继承。ToolTurns 属于后者,其“刻意信息不完整”的设计借鉴了真实用户渐进式澄清需求的交互模式。
API 端点(API endpoint) 指一个具体可调用的服务接口,例如“查询某城市某日天气”对应一个端点,而“天气服务”则是一个工具。ToolTurns 覆盖 1,827 个工具和 11,004 个端点,意味着同一工具下可能有多个功能不同的接口,智能体需要精确选择端点并正确传参,这比仅选择工具更具挑战性。
核心发现:单轮强,多轮弱
论文对九个语言模型进行了评估,结果揭示了一个普遍现象:最好的智能体在单个请求上的解决率达到 69.6%,但完整对话的完成率骤降至 39.8%。这意味着,即便模型能处理好孤立的工具调用,在多轮上下文中维持任务成功仍然非常困难。
更值得关注的是,在这种评估协议下,所有被评估模型在后续追问上的成功率都低于初始请求。这说明模型在对话中丢失上下文或无法有效利用先前信息的问题具有普遍性,而非个别模型的缺陷。
对话质量与任务成功可能脱节
研究还发现,对话质量评分(dialogue-quality rubric scores)与任务成功率可能对模型给出截然不同的排名。一个模型可能生成流畅、自然的对话,却在工具调用任务上表现不佳;反之亦然。这提示我们,评估智能体不能只看最终任务是否完成,对话过程的质量同样需要独立衡量。
解决率(solve rate) 通常指智能体在单次请求中成功完成任务的比例,而完整对话完成率(conversation completion rate) 要求一段多轮对话中的所有轮次(初始请求加后续追问)全部成功。两者差距巨大(69.6% vs 39.8%)说明:模型在孤立请求上表现尚可,但一旦需要跨轮次保持状态、继承先前信息并处理追问,失败率显著上升。这种评估协议分离了“单点能力”与“持续协作能力”,更贴近真实部署场景。
开源用户模拟器与检查-修复流程
为了可扩展地生成多轮对话,ToolTurns 配套了一个开源用户模拟器。该模拟器通过对话逐步揭示隐藏的上下文,并生成后续追问。为了提升模拟对话的质量,作者引入了检查-修复(checker-fixer)流程:先检测模拟器生成的对话轮次中的缺陷,再进行修正。
成对轮次评估显示,checker-fixer 能减少检测到的对话缺陷,盲测人类评估也更偏好修正后的轮次。这为后续多轮工具使用研究提供了一个可靠的对话生成基础设施。
用户模拟器(user simulator) 是由语言模型扮演用户、根据预设的隐藏上下文逐步生成对话轮次的组件,用于低成本、可扩展地合成多轮交互数据。它需要模拟真实用户的模糊表达、追问和澄清行为,而非直接给出完整需求。
检查-修复(checker-fixer)流程 是一种两阶段质量保障机制:checker 负责检测模拟对话中的缺陷(如信息泄露、逻辑矛盾、重复提问),fixer 则针对缺陷进行修正。这种“生成-检测-修正”的流水线常用于提升合成数据质量,盲测人类评估偏好修正后的轮次,表明该流程能有效减少噪声,为基准测试提供更可靠的对话样本。
对智能体开发的启示
ToolTurns 的结果指向一个明确的方向:工具调用能力不能只靠单轮基准来验证。真实部署中,用户请求往往不完整、需求会在对话中演变,智能体需要具备主动澄清、上下文继承和跨轮次规划的能力。
对于开发者而言,这意味着在训练和评估智能体时,应当引入更多依赖上下文的追问场景,而不仅仅是静态的 API 调用测试。同时,对话质量与任务成功的解耦也提醒我们,需要多维度的评估体系来指导模型迭代。
ToolTurns 已开源,其基准和用户模拟器为研究社区提供了一个可复现的测试平台,用于衡量智能体是否能在多轮工具对话中持续保持任务成功。
总结
ToolTurns 揭示了当前 LLM 智能体在多轮工具对话中的显著短板:单请求成功率近七成,完整对话成功率却不足四成。所有模型在后续追问上表现下降,说明上下文保持是共性难题。配套的开源用户模拟器与检查-修复流程,则为高质量多轮对话数据的生成提供了工具。对于关注 AI 智能体落地的团队,这个基准值得纳入评估体系。
相关推荐

Gemini 4 Neon 曝光:或成 Opus 5.5 有力竞争者
Hacker News 讨论帖指出 Gemini 4 Neon 看起来像 Opus 5.5 的竞争者。本文解读这一社区信号背后的产品定位、顶级模型竞争格局变化,以及对开发者模型选型策略的实际意义。

Claude Fable 5.2 独立创作短片《Fable》引热议
Hacker News 上出现由 Claude Fable 5.2 独立完成剧本、画面与导演的短片《Fable》,本文分析全流程 AI 创作的意义、社区反应及对内容创作者的启示。

Anthropic IPO定价:AI巨头上市信号
Anthropic 进行 IPO 定价的消息引发关注。本文分析这一动作对 AI 行业估值、商业化路径和竞争格局的潜在影响,并指出公开市场对 AI 公司的期待与挑战。