TorchNeuron:Amazon Trainium芯片的PyTorch新后端科学解析
Amazon 为 Trainium 芯片推出 PyTorch 后端 TorchNeuron,提升模型执行效率与可迁移性。
Amazon 为自研机器学习加速芯片 Trainium 推出了专用 PyTorch 后端 TorchNeuron,旨在解决 PyTorch 默认面向 GPU 优化、难以直接发挥 Trainium 性能的问题。文章介绍了其运行时优化的核心机制,包括计算图重写、算子融合与内存规划,将动态图转换为适配 Trainium 的静态执行计划以减少内核启动开销。同时,开发团队借助 Agentic AI 驱动评估流程,自动生成测试用例、分析瓶颈并迭代调优,从而提升后端的可靠性与兼容性。对开发者而言,TorchNeuron 降低了现有 PyTorch 模型迁移到 Trainium 的门槛,有助于控制训练与推理成本。文章还展望了软硬件协同设计与社区合作的前景。
Amazon 为 AWS Trainium 芯片推出了全新的 PyTorch 后端 TorchNeuron,旨在让 PyTorch 模型在 Trainium 系统上高效可靠地运行。本文深入解析其背后的科学原理与工程实践。
为什么需要 TorchNeuron?
Trainium 是 AWS 自研的机器学习加速芯片,其架构与 GPU 存在显著差异。PyTorch 作为主流深度学习框架,默认针对 GPU 优化。直接在 Trainium 上运行 PyTorch 模型往往无法充分发挥硬件性能。TorchNeuron 作为专用后端,填补了框架与芯片之间的鸿沟,通过运行时优化和系统性评估,确保模型高效执行。
Trainium 与 GPU 的架构差异
理解 TorchNeuron 的必要性,首先需要了解 Trainium 与 GPU 在设计哲学上的根本不同。Trainium 采用专用集成电路(ASIC)路线,其计算核心围绕脉动阵列(systolic array)组织,专为矩阵乘法等深度学习核心运算做深度定制,而非像 GPU 那样以通用并行计算为目标。这意味着 Trainium 在特定负载下能获得更高的能效比,但代价是对算子形态、内存层级和数据布局有更严格的要求。GPU 生态经过十余年 CUDA 积累,PyTorch 的许多默认实现都假定了 GPU 的内存模型与执行语义;直接把这些实现搬到 Trainium 上,往往会出现算子不被支持、访存模式不匹配、并行度利用不足等问题。TorchNeuron 正是为弥合这种架构级差异而生的适配层。
运行时优化的核心机制
TorchNeuron 的运行时优化涵盖计算图重写、算子融合、内存规划等方面。它能够将 PyTorch 的动态图转换为适合 Trainium 的静态执行计划,减少内核启动开销,并利用 Trainium 的并行计算单元。这些优化由 Agentic AI 驱动的评估流程持续调优,确保在不同模型上都能获得稳定性能。
计算图重写、算子融合与内存规划
这三个术语是编译器与运行时优化的核心手段。计算图重写指在保持语义等价的前提下,对图结构做变换,例如常量折叠、死代码消除、布局转换插入等,使图更契合目标硬件。算子融合是把多个细粒度算子合并为一个复合内核,避免中间结果反复读写显存,既降低内核启动开销,也提升数据局部性——这对采用静态执行计划的加速器尤为关键。内存规划则是在编译期确定张量的生命周期与复用关系,通过内存池化和地址复用减少峰值占用与分配开销。在 Trainium 这类需要预分配片上缓冲的架构上,内存规划的优劣直接决定模型能否跑得下、跑得快,因此它是 TorchNeuron 优化链路中不可省略的一环。
由 Agentic AI 驱动的评估流程
TorchNeuron 的开发团队采用 Agentic AI 来驱动评估过程。这种 AI 代理能够自动生成测试用例、分析性能瓶颈,并迭代优化策略。通过大规模自动化评估,团队能够快速验证 TorchNeuron 在各类模型上的表现,并及时发现和修复问题。这种数据驱动的开发方式显著提升了后端的可靠性和兼容性。
Agentic AI 与自动化性能调优
Agentic AI 指具备目标设定、工具调用与多步推理能力的智能体系统,区别于单轮问答式的模型调用。在 TorchNeuron 的评估场景中,这类代理可以自主规划测试矩阵、生成覆盖边界情况的模型与算子组合、读取性能剖析数据、定位瓶颈并据此提出下一轮优化假设,形成闭环迭代。相比人工编写测试用例,代理驱动的方式能显著扩大覆盖范围并加快反馈周期。需要说明的是,这类流程的价值在于把"评估"从一次性检查转变为持续的数据驱动过程,使后端的兼容性与稳定性能够在模型快速演进的背景下得到规模化验证。
对开发者的意义
对于使用 PyTorch 的开发者而言,TorchNeuron 意味着可以更轻松地将现有模型迁移到 Trainium 平台,无需重写大量代码。同时,TorchNeuron 的优化能力有助于降低训练和推理成本,提升资源利用率。随着 Trainium 生态的完善,TorchNeuron 有望成为 AWS 机器学习基础设施中的重要一环。
后端抽象与迁移成本
PyTorch 的后端机制允许通过设备抽象和自定义算子注册,把同一份模型代码映射到不同硬件上执行。TorchNeuron 作为后端接入后,开发者通常只需调整设备指定与少量不兼容算子,而不必重写训练循环或模型结构,这大幅降低了跨平台迁移的边际成本。不过实践中仍需注意:并非所有算子都能被高效映射,动态控制流较多的模型可能需要额外适配;此外,性能收益取决于模型形态与批大小,建议在迁移前后做基准对比,而非默认获得线性加速。理解这些边界,有助于开发者更务实地评估 Trainium 在自身工作负载中的适用性。
未来展望
TorchNeuron 的推出体现了 AWS 在软硬件协同设计上的持续投入。通过开源和社区合作,TorchNeuron 有望进一步扩展支持范围,并推动 Trainium 在AI训练市场的应用。开发者应关注其后续版本更新,以充分利用新特性。
相关推荐
开源魔兽寻路修复实录:1332行代码填平三年老坑
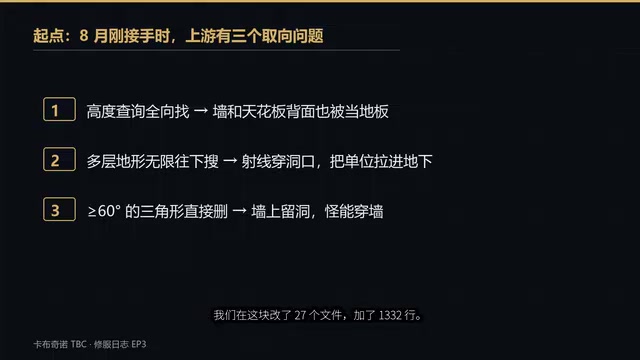
开源魔兽世界修服日志EP3实录:怪物卡闪避、穿墙、悬空、怪不来四大乱象的根因在寻路网格生成层。大肥鱼团队累计改27个文件、加1332行代码,用off mesh自动补连、按格给参数、高度换算向上取整三步修完整条bug链。
DeepSeek 4.1 Flash实测:开源最强模型与DeepInfer的野心
DeepSeek 4.1 Flash 实测解析:开源最强模型在视频生成、3D 游戏、找青蛙测试中的真实表现,以及 DeepInfer 推理引擎公开的缓存命中率、毛利率与华为芯片支持意味着什么。
DeepSeek开源推理框架领衔,本周五大科技亮点
本周科技周报:DeepSeek开源生产推理框架DeepInfo,DuckDB 2.0迈向服务端,Rust版TypeScript编译器TSRS性能提升8倍,Mac直接运行安卓应用,开源排版软件DesignCraft与电视桌面Ariel亮相。