投机解码的“偏科”现象:代码接受率7个/步,通用文本仅2.5个,是上限还是可优化?
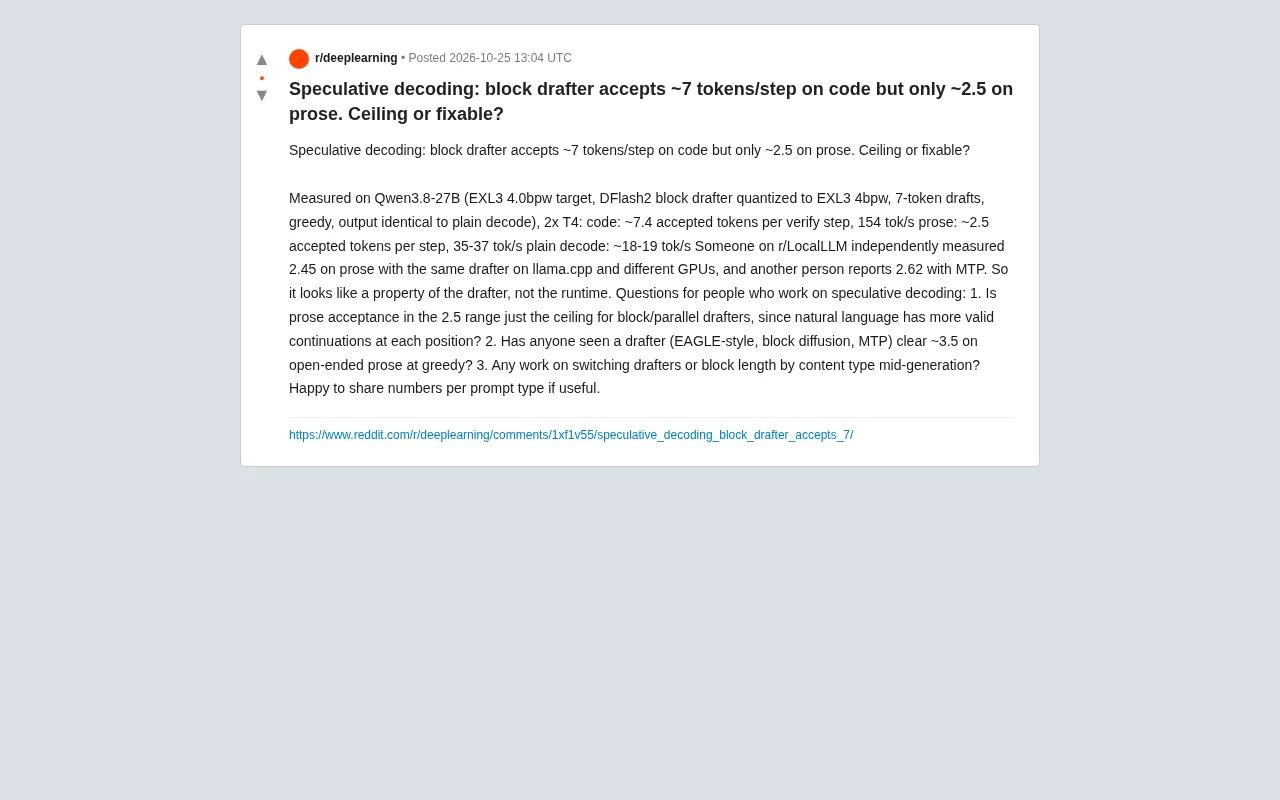
实测显示投机解码在代码上每步接受约7.4个token,散文仅约2.5个,低接受率源于草稿器特性而非运行时。
文章基于Reddit社区实测,揭示投机解码存在明显的“偏科”现象:在Qwen3.8-27B配块状草稿器的测试中,代码生成每验证步接受约7.4个token、吞吐154 tok/s,而开放域散文仅接受约2.5个、吞吐35-37 tok/s,普通解码基线约18-19 tok/s。多源交叉验证(llama.cpp复现2.45、MTP报告2.62)表明低接受率是草稿器本身的特性,而非特定运行时或硬件问题。文章从代码的强语法模式性与散文的高熵、多合法续写出发解释成因,并讨论2.5是否为理论上限、现有EAGLE/块扩散/MTP能否突破3.5,最后给出按内容类型分别评估加速比、匹配草稿器与负载、优化验证策略等部署启示。
投机解码的效率悖论:代码与散文的接受率差距
投机解码(Speculative Decoding)是当前大模型推理加速的主流技术之一,其核心思路是用一个轻量级的“草稿模型”(drafter)快速生成多个候选token,再由主模型并行验证,从而减少串行解码的步数。然而,来自Reddit社区的一项实测揭示了一个值得关注的“偏科”现象:在代码生成任务上,块状草稿器(block drafter)每步平均接受约7个token,而在开放域散文(prose)上,这一数字骤降至约2.5个。
该测试基于Qwen3.8-27B模型(EXL3 4.0bpw量化目标,DFlash2块草稿器量化为EXL3 4bpw,7-token草稿,贪心解码,输出与普通解码完全一致),在2块T4显卡上运行。数据显示:代码场景下,每个验证步接受约7.4个token,吞吐达到154 tok/s;散文场景下,每步仅接受约2.5个token,吞吐为35-37 tok/s;而普通解码的基线吞吐约为18-19 tok/s。
这一差距并非孤例。据r/LocalLLM社区的另一位用户独立测试,在llama.cpp运行时和不同GPU上,同一草稿器在散文上的接受率测得2.45;还有用户报告使用MTP(Multi-Token Prediction)方法时接受率为2.62。多个来源的交叉验证指向一个结论:散文接受率低是草稿器本身的特性,而非特定运行时或硬件的问题。
为什么散文的接受率天然更低?
要理解这一现象,需要回到投机解码的验证机制。草稿器一次性生成k个候选token(本例中k=7),主模型对每个位置进行验证,只有与主模型贪心选择一致的token才会被接受。一旦某个位置不匹配,该位置之后的草稿全部作废,需要回退重新生成。
代码与散文在“下一个token的可预测性”上存在本质差异。代码具有严格的语法约束和强模式性——缩进、括号配对、常见API调用序列、变量命名习惯等,使得草稿器更容易猜中主模型的选择。而自然语言散文的每个位置都存在大量合法且合理的续写方式,主模型的选择高度依赖上下文语义和训练分布,草稿器很难精准命中。
这引出了原帖提出的第一个核心问题:2.5左右的散文接受率是否是块状/并行草稿器的理论上限? 从信息论角度看,散文的“有效分支因子”更高,每个位置的熵更大,草稿器与主模型之间的分布差异被放大,接受率自然会下降。但这是否就是天花板,目前尚无定论。
有效分支因子是信息论与语言建模中的概念,指在给定上下文中,下一个token位置上“几乎同样合理”的候选数量。它并不等同于词表大小,而是由分布熵近似刻画:若主模型输出分布接近均匀,则有效分支因子大;若高度尖锐,则小。投机解码中,草稿器需在每一步命中主模型的贪心选择,而命中概率大致与分布尖锐程度正相关。代码由于语法与API约束,分布往往尖锐,有效分支因子小;开放域散文则相反,多个词、句式乃至标点都合理,分支因子大。这解释了为何散文接受率天然偏低,也提示块长度k应与有效分支因子匹配:k过大会放大失配代价。
现有草稿器方案能否突破3.5?
原帖作者向投机解码领域的研究者提出了一个关键问题:是否有人见过EAGLE风格、块扩散(block diffusion)或MTP等草稿器在开放域散文、贪心解码下达到约3.5的接受率?
从社区反馈来看,目前公开的实测数据大多集中在2.5-2.6区间,尚未见到稳定突破3.5的报告。这暗示当前的草稿器架构在散文场景下可能存在共同的性能瓶颈。EAGLE系列通过特征级对齐来提升草稿质量,MTP则利用模型自身的多token预测头,但两者在开放域文本上的收益似乎都受限于语言本身的多样性。
一个值得探索的方向是按内容类型动态切换草稿器或块长度。原帖作者也提到了这一点:在生成过程中根据内容类型(代码、散文、结构化数据)实时调整草稿策略。例如,代码段使用7-token块长和代码特化草稿器,散文段则缩短块长或切换为更保守的草稿模式,以减少无效验证的开销。这种自适应策略在理论上可行,但需要运行时能够低成本地识别内容类型并切换草稿器,工程复杂度不低。
EAGLE是一类特征级投机解码方法,它不在token空间草拟,而是在主模型倒数第二层隐状态上训练一个轻量自回归头,预测下一位置的隐特征再映射为token。由于利用了主模型的内部表示,EAGLE的草稿与主模型分布更接近,接受率通常高于独立小模型草稿,且支持树状候选。**MTP(Multi-Token Prediction)**则是在训练阶段让模型额外拥有多个预测头,一次输出未来多个token,推理时可直接作为草稿源。两者都是“更贴近主模型分布”的思路,但面对开放域散文的高熵,特征对齐也只能缩小而非消除分布差距,这解释了公开数据中它们仍停留在2.5-2.6区间。
对推理部署的实践启示
对于实际部署投机解码的团队,这组数据提供了几点参考。首先,不要假设投机解码的加速比在所有任务上一致。代码类任务可获得约4倍以上的吞吐提升(154 vs 18-19 tok/s),而散文类任务仅约2倍(35-37 vs 18-19 tok/s)。在容量规划和SLA设定时,应按业务内容类型分别评估。
其次,草稿器的选择应与目标负载匹配。如果业务以代码生成为主,块状草稿器的高接受率能带来显著收益;如果以开放域对话或长文写作为主,则需要重新评估草稿器的投入产出比,甚至考虑是否值得为2倍加速付出额外的显存和复杂度成本。
最后,散文接受率的提升空间可能不在于草稿器本身,而在于验证策略的优化。例如,允许主模型在验证时接受“等价”的替代token(而非严格贪心匹配),或采用树状验证结构同时评估多条候选路径,这些方向或许能绕开草稿器命中率的天花板。原帖作者表示愿意分享按提示类型分类的详细数据,这类细粒度实测对社区推进该问题的研究具有实际价值。
树状验证是突破线性草稿限制的重要方向:草稿器不再只生成一条k-token链,而是生成一棵候选树(如EAGLE-2的动态树),主模型一次前向并行验证多条路径,接受其中最长的一致前缀。这样即使某条路径中途失配,其他分支仍可能被接受,从而在同等验证开销下提高期望接受token数。与严格贪心匹配不同,树状验证还可结合“等价token”放宽策略,但需注意放宽会改变输出分布,可能偏离贪心解码的确定性保证。对散文这类高熵文本,树状结构的收益理论上更明显,代价是验证时的注意力掩码与KV缓存管理更复杂,显存占用上升。
社区协作与未解问题
此次讨论的价值在于多源数据的交叉印证:原作者在2x T4上的实测、r/LocalLLM用户在llama.cpp上的独立复现(2.45)、以及MTP用户的报告(2.62),共同将问题定位到草稿器特性而非运行时差异。这种社区协作模式对推理优化这类工程性极强的领域尤为重要。
目前仍悬而未决的问题包括:散文接受率是否存在理论下界与上界的严格分析;是否存在针对高熵文本重新设计的草稿器架构;以及内容自适应切换在真实生产环境中的延迟开销是否可接受。这些问题的答案,将决定投机解码能否从“代码生成加速器”进化为通用的大模型推理加速方案。
相关推荐

Last Week Tonight深扒:政客与白人至上主义的危险纽带
Last Week Tonight调查佐治亚州参议员候选人Mike Collins与佛罗里达州候选人Marshall Rawson,揭露他们与白人至上主义者的多重关联,以及共和党内的沉默反应。
AI圈爆料周:GPT-6.5泄露、Claude新模型与MiniMax性价比
本周AI圈爆料汇总:GPT-6.5疑似泄露、微软配置现GPT-6.1 Tera、Anthropic新模型能识别整类Bug、Gemini 4 Carbon早期表现失望,以及MiniMax M3.1 Flash以极低成本在基准测试中超越Claude Opus 5和GPT-5.6 Sol。
AI快讯:Gemini 4 Carbon发布,蚂蚁开源Ling-3.1
AI快讯:Google发布Gemini 4 Carbon量子位模型,宣称超越Opus 5.5且首发Token半价;蚂蚁百灵开源Ling-3.1-1019推动Personal Agent真实任务;国产AI制药19个项目18个成功,6个GPCR靶点全命中;零营收公司估值200亿美元再融10亿美元;四川便利店机器人售货失败。