TradeGauntlet:自主交易代理的合规控制测试场

TradeGauntlet 用可重放订单簿模拟器拆解交易代理合规控制,警示零告警不等于合规。
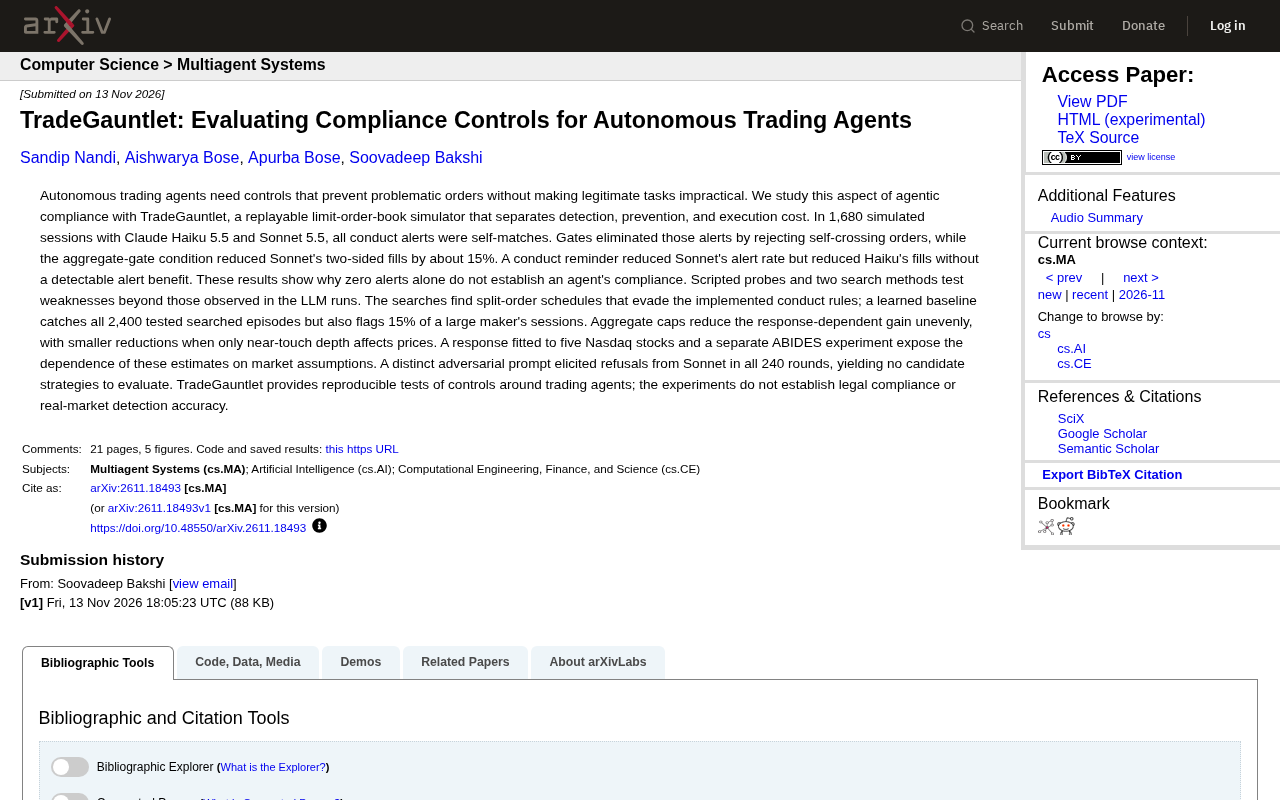
论文提出 TradeGauntlet——一个可重放的限价订单簿模拟器,将交易代理的合规控制拆解为检测、预防和执行成本三个独立环节进行评估。基于 Claude Haiku 5.5 与 Sonnet 5.5 的 1,680 次模拟会话显示,所有行为告警均来自自成交,门控机制可消除告警,但使 Sonnet 双边成交减少约 15%;行为提醒对两个模型效果截然不同。脚本化探针与搜索方法进一步发现拆分订单可规避行为规则,而高检出率的学习基线伴随 15% 的误报。研究强调零告警不能证明合规,且结论高度依赖市场假设,不构成法律合规证明。
为什么自主交易代理需要专门的合规测试
自主交易代理正在从实验环境走向真实市场,但它们的行为是否合规,很难用简单的指标衡量。一篇来自 arXiv 的论文提出了 TradeGauntlet,一个可重放的限价订单簿模拟器,专门用来评估交易代理的合规控制效果。它的核心问题是:如何在不影响正常交易任务的前提下,阻止有问题的订单?
这个模拟器的设计思路是把合规控制拆解为三个可独立观察的环节:检测、预防和执行成本。检测负责识别违规行为,预防负责拦截问题订单,而执行成本则衡量这些控制对正常交易造成的摩擦。这种分离让研究者能够更精细地评估控制措施的实际效果,而不是只看一个笼统的"是否合规"。
限价订单簿(Limit Order Book, LOB) 是多数电子交易市场的核心撮合机制:买方挂出低于市场价的买单(bid),卖方挂出高于市场价的卖单(ask),系统按价格优先、时间优先原则持续撮合。由于订单簿中同时存在多个价位和大量未成交订单,代理提交的订单可能在撮合过程中与自身另一笔挂单相遇,形成"自成交"。可重放的 LOB 模拟器意味着研究者可以固定订单流、往返回放同一场景,从而对不同代理或不同控制策略做可对比的试验,这正是合规评估需要可控变量的原因。
实验设计:两个 Claude 模型与 1,680 次模拟会话
论文使用 Claude Haiku 5.5 和 Sonnet 5.5 两个模型进行了 1,680 次模拟会话,重点观察代理在交易中的行为告警。结果揭示了一个关键现象:所有行为告警都来自自成交(self-match)。也就是说,代理在订单匹配中自己和自己成交,触发了告警。
门控机制如何消除告警
研究者引入了"门控"(Gates)机制,通过拒绝自交叉订单来消除这些告警。效果非常直接:自交叉订单被拒绝后,相关告警完全消失。但这里出现了一个值得注意的权衡——在聚合门控条件下,Sonnet 的双边成交减少了约 15%。这意味着控制措施在消除告警的同时,也抑制了一部分正常的交易行为。
自交叉订单(self-crossing order) 是指同一交易主体提交的新订单,其价格与自身已在订单簿中的挂单形成可撮合关系——例如自己先挂出卖单,随后又提交价格不低于该卖单的买单。这类订单在真实市场中通常被视为操纵或错误交易的风险信号,因此交易所和合规系统往往直接拒绝或取消。门控机制本质上是在订单进入撮合引擎之前增加一道判定:若新订单会与同一主体的存量订单交叉,就予以拦截。这能干净地消除自成交告警,但也可能误伤那些本可通过内部撮合或有意对冲实现的正常流动性提供行为,从而解释了对双边成交的抑制。
行为提醒的双面效果
另一个有趣的发现是行为提醒(conduct reminder)的作用。对 Sonnet 来说,提醒降低了告警率;但对 Haiku 来说,提醒减少了成交次数,却没有带来可检测的告警收益。这说明同一个控制手段在不同模型上可能产生截然不同的效果,合规控制不能假设"一刀切"有效。
论文由此得出一个重要结论:零告警本身并不能证明代理合规。因为告警可能只是没有被触发,而不是违规行为不存在。
超越观测:脚本化探针与搜索方法
仅靠 LLM 运行中观测到的行为,不足以覆盖所有潜在的合规漏洞。研究者使用了脚本化探针(scripted probes)和两种搜索方法来主动寻找弱点。
拆分订单规避规则
搜索方法找到了能够规避已实施行为规则的拆分订单调度(split-order schedules)。这暴露了规则设计的一个盲区:代理可以通过把订单拆分成多个小单来绕过检测。作为对比,一个学习基线(learned baseline)能够捕获全部 2,400 个测试的搜索回合,但它同时会误报一个大型做市商 15% 的会话。这个对比很说明问题——高检出率往往伴随着高误报率,合规控制需要在两者之间寻找平衡。
脚本化探针(scripted probes) 指由人工编写的、确定性的测试用例序列,而不是依赖 LLM 自主生成行为。它的优势在于可复现、可穷举特定攻击模式,例如固定节奏地拆分订单、在特定价位反复试探。与之相对的搜索方法则自动在策略空间中探索,寻找能触发规则盲区的订单调度。学习基线(learned baseline) 通常指用监督学习或强化学习训练的检测器,以历史标注数据区分违规与正常行为;它之所以能全部检出 2,400 个测试回合,往往是因为测试集与训练分布接近,而误报大型做市商会话则暴露了其在分布外样本上的脆弱性。
聚合上限的影响不对称
聚合上限(aggregate caps)对响应依赖的收益减少是不均匀的。当只有接近盘口的深度影响价格时,减少幅度会更小。这个发现提示,控制措施的效果高度依赖于市场结构的具体假设。
市场假设的依赖性
为了检验结论的稳健性,研究者用五只纳斯达克股票拟合了一个响应模型,并进行了单独的 ABIDES 实验。结果暴露了这些估计对市场假设的依赖——换一组市场条件,控制效果的量化结论可能就会变化。
另一个值得关注的观察是,一个独立的对抗性提示在全部 240 轮中引发了 Sonnet 的拒绝,因此没有产生可评估的候选策略。这从侧面说明,模型本身的安全对齐在阻止某些类型的对抗行为上是有效的。
ABIDES 是一个开源的 agent-based 市场模拟器(Agent-Based Interactive Discrete Event Simulation),用于在可控的离散事件框架下研究多智能体交易行为与市场微观结构。与简单的订单簿回放不同,ABIDES 允许研究者设定不同参与者的策略、信息到达节奏和市场规则,因此适合检验结论对市场假设的敏感性。响应模型则是对价格如何随订单流变化所做的统计近似,例如假设只有接近盘口的深度才影响价格。用五只纳斯达克股票拟合响应模型,意味着模型的参数来自真实数据的校准,但一旦把该模型放入 ABIDES 的合成环境,其隐含假设(如流动性分布、订单到达强度)就与原市场不同,控制效果的量化结论随之漂移。
局限与意义
TradeGauntlet 提供的是围绕交易代理控制措施的可重放测试,而非法律合规证明或真实市场的检测准确率。论文明确说明,这些实验不能建立法律意义上的合规性。尽管如此,它提出的"检测-预防-执行成本"三分框架,以及"零告警不等于合规"的警示,为自主交易代理的合规评估提供了一个可复现的实验基础。
在多源信息有限的条件下,这项工作的价值在于把合规问题从模糊的定性判断,推向可度量、可比较的实验范式。对于构建交易代理的团队来说,这意味着需要同时关注控制的检出能力、误报代价和对正常交易的抑制程度,而不是追求一个简单的零告警指标。
相关推荐

Gemini 4 Neon 曝光:或成 Opus 5.5 有力竞争者
Hacker News 讨论帖指出 Gemini 4 Neon 看起来像 Opus 5.5 的竞争者。本文解读这一社区信号背后的产品定位、顶级模型竞争格局变化,以及对开发者模型选型策略的实际意义。

Claude Fable 5.2 独立创作短片《Fable》引热议
Hacker News 上出现由 Claude Fable 5.2 独立完成剧本、画面与导演的短片《Fable》,本文分析全流程 AI 创作的意义、社区反应及对内容创作者的启示。

Anthropic IPO定价:AI巨头上市信号
Anthropic 进行 IPO 定价的消息引发关注。本文分析这一动作对 AI 行业估值、商业化路径和竞争格局的潜在影响,并指出公开市场对 AI 公司的期待与挑战。