Trae AI编程积分一天烧掉500?实测Token消耗省钱攻略
用AI编程工具一天烧掉500积分,真正的元凶是超长上下文与大日志全量提交
一位B站UP主使用Trae Code完成字幕工具的打包发布需求,一天内消耗了500多积分,相当于5天免费签到总量。文章拆解了他的消费明细:整理目录、删文档、生成说明、打包exe、验证build、排查报错、压缩体积,每一步都有真实积分数字。其中最出乎意料的是"删几句话"花了24积分、压缩exe花了58积分。核心原因在于:AI按Token计费,而Token消耗取决于上下文长度与文本吞吐量,而非需求本身的大小。AI总结了四条节省建议——避免超长单一对话、不整体提交大日志、精简报错信息、任务原子化——并推荐用"new context"重置上下文。此外,手动选低价模型而非默认auto,可节省三倍以上费用。
AI自动编程工具正变得越来越普及,但很多用户上手后才发现一个绕不开的问题——积分(本质上是Token)消耗远超预期。一位B站UP主分享了自己使用Trae Code(视频中称"春衣code",疑为语音转写误差)完成一个需求的真实账单:一天内消耗了500多积分,相当于其免费签到5天的总量。这篇文章拆解他的消费明细,并总结出几条实用的省积分思路。
一天花掉500积分的真实账单
这位UP主的目标很明确:把自己做的字幕编辑工具整理、打包并发布出去,让更多人能用。听起来是一个常规的工程化需求,但拆开来看,每一步的积分消耗都值得玩味。
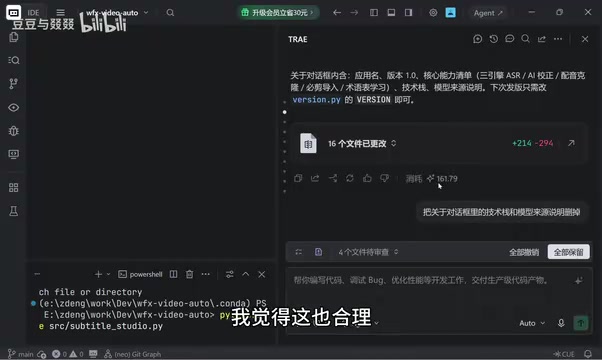
整理目录结构、删除冗余文件、新增版本信息——这个相对"重"的任务花了约 161.79 积分,UP主认为合理,毕竟涉及大量文件读取。真正让他意外的是接下来的小操作:仅仅是在一个文档里删掉几句关于技术栈和模型来源的说明,竟然用掉了 24.56 积分。相比之下,他回忆早期做类似小需求往往不到 10 积分。
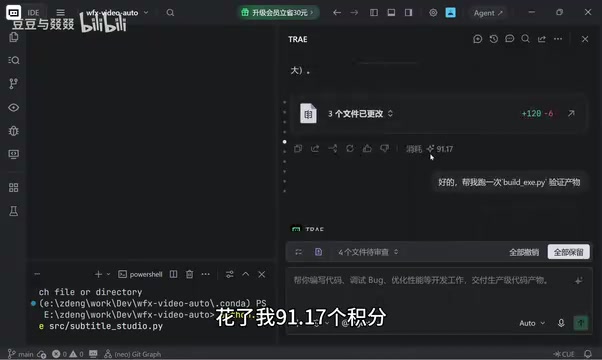
后续生成发布说明文档花了 10.49 积分,打包成 exe 可执行文件花了 91.17 积分。这两项他尚能接受——生成文档和打包都要动不少文件。
隐藏的积分黑洞:验证、日志与报错
真正把积分"吃干抹净"的,是那些看似不起眼的验证和排错环节。
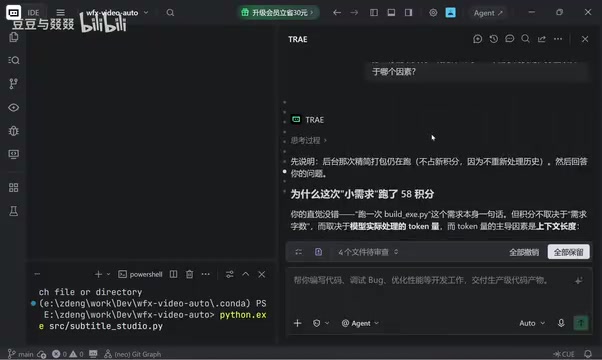
UP主让工具跑一次 build 验证 exe 产物,本以为只是本地执行、不该消耗太多,结果花了近 30 积分。打包时出现报错,让AI去读日志排查,又花了 39.59 积分。最后发现打包出来的 exe 接近 1GB,他要求压缩体积,这一步直接消耗 58 积分。
到这里他已经坐不住了,直接追问AI为什么一个"小需求"要烧掉这么多积分。AI的回答颇具参考价值:积分消耗取决于 Token 量,而他的会话是一个"超长连续对话",上下文越积越多;build log 的全文读取、tsc 编译输出都包含海量文本;更要命的是报错日志——动辄几千行的 XML、堆栈信息会瞬间推高 Token 占用。
Token(词元)是大语言模型处理文本的基本计量单位。模型并不直接处理完整的单词或字符,而是将文本切分成更小的片段——英文中一个单词大约对应1-2个Token,中文每个汉字通常对应1-2个Token。每次向模型发送请求时,计费范围包括两部分:输入Token(你发送给模型的所有内容,含历史对话上下文)和输出Token(模型返回的内容)。在连续对话模式下,系统为了让模型"记住"前文,会把整段对话历史一并打包送入模型,导致随着对话轮次增加,每轮的输入Token量成倍增长。一个几千行的构建日志或XML报错文件,单次提交就可能包含数万个Token,这正是"小需求"却烧掉大量积分的根本原因。
AI给出的四条省Token建议
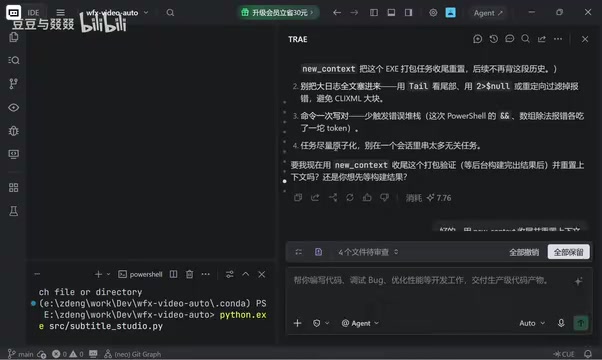
这段对话最有价值的部分,是AI自己总结的节省策略。对任何使用按 Token 计费的编程助手的人来说,这几点都通用:
- 避免超长单一对话:长对话会把全部历史上下文反复带入,每一轮请求都在为之前的内容付费。
- 不要把大日志文件整个塞给AI:构建日志、运行日志往往上万行,应先筛选再喂给模型。
- 报错日志要精简:报错块通常包含大量冗余文本,全量提交等于白白烧 Token,建议只保留关键错误信息。
- 任务尽量原子化:不要在一个会话里串联多个无关任务,前面的无关内容会持续占用上下文。
此外,AI还提到可以用 new context(新建上下文/重置会话)的方式终止旧的上下文累积——如果确实需要长时间协作,这是比一直延续同一对话更省钱的做法。
模型选择:便宜与贵的差三倍
另一个容易被忽视的省钱点是模型选择。UP主发现,工具默认采用 auto 自动选择模型,但其选择规则并不透明。而在手动可选的模型列表里,最便宜的单价约 0.06,最贵的约 0.20,差距超过三倍。
他的结论是:对于难度不高的常规需求,没必要让系统自动分配到昂贵模型,手动选最便宜的档位往往就能满足。毕竟平台上架的模型都经过测试,基础能力有保障。这一点对所有预算敏感的用户都是直接可操作的建议——把 auto 关掉,按需求难度手动挑模型。
AI编程工具平台通常同时接入多个不同规模的语言模型,并按模型能力分级定价。旗舰模型(如GPT-4级别或Claude Opus级别)参数量更大、推理能力更强,单价也更高;而轻量级模型(如GPT-3.5级别或各家的mini/haiku版本)在处理结构清晰、逻辑简单的任务时表现并不逊色,成本却低得多。"auto"自动选择模式通常由平台根据任务复杂度或流量负载动态分配,用户无法掌控实际调用了哪个模型,存在被路由到高价模型的风险。对于代码格式化、文档生成、文件重命名等明确性高的常规任务,手动指定低价模型是最直接的控制成本手段。
给AI编程用户的启示
这则亲身经历折射出当前 AI 编程工具的一个共性痛点:计费与 Token 深度绑定,而用户对 Token 消耗缺乏直观感知。删几句话花 24 积分、压缩文件花 58 积分,这些结果在传统认知里完全无法预估,因为真正决定成本的不是"需求大小",而是上下文长度和文本吞吐量。
对普通开发者而言,与其事后心疼积分,不如把节流意识前置:短对话、原子任务、精简日志、手动选模型。这些习惯不仅省钱,往往还能让AI的输出更聚焦、更准确——因为过长的上下文本身就会稀释模型对当前任务的注意力。
随着越来越多人把 AI 编程纳入日常工作流,如何在体验与成本之间找到平衡,会是每个用户都要面对的功课。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。