Transformer泛化边界新解:长序列训练为何比多样本更高效
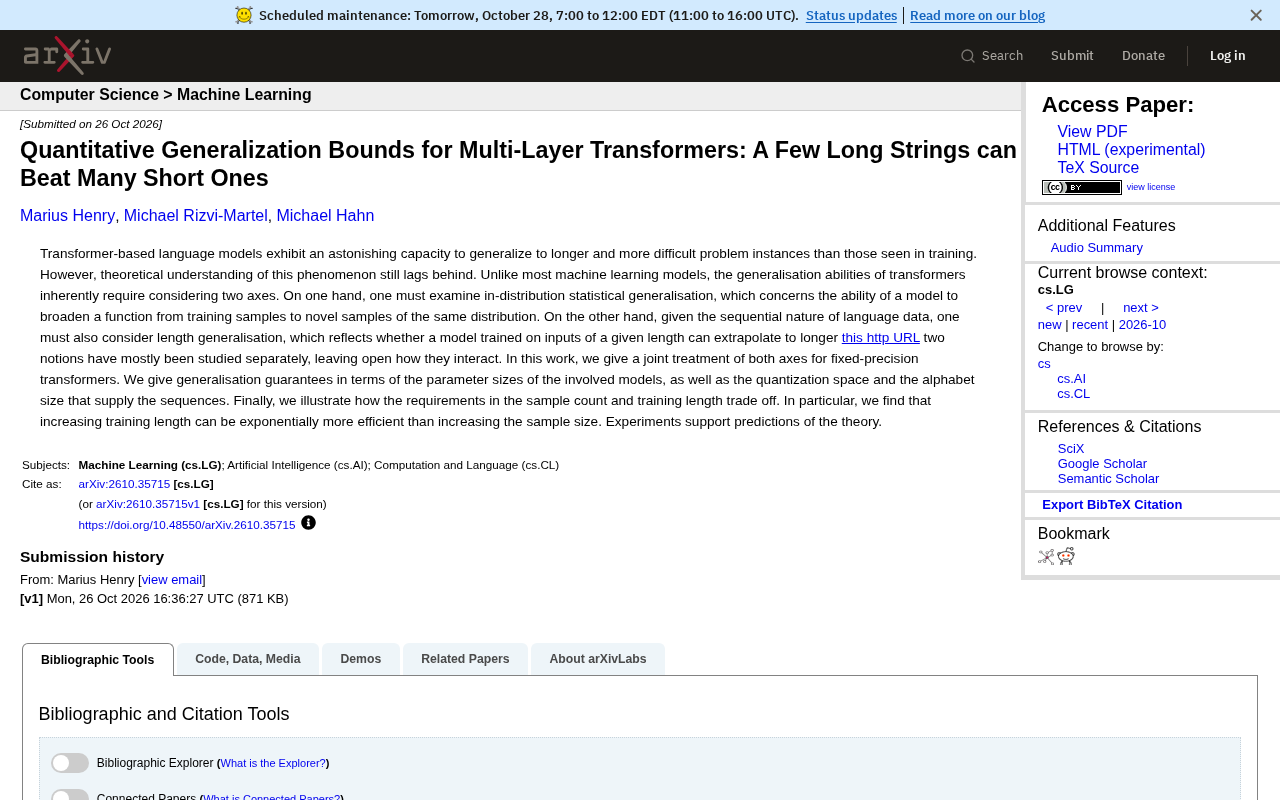
论文联合分析固定精度Transformer的分布内与长度泛化,证明长序列训练比多样本指数级高效。
该论文针对固定精度Transformer,首次联合分析了分布内统计泛化和长度泛化,给出了依赖参数规模、量化空间和字母表大小的泛化边界。核心发现是:增加训练长度可能比增加样本数指数级更高效,即少量长字符串的训练效果可优于大量短字符串。实验验证了样本数与训练长度之间的权衡关系。这一理论挑战了“更多数据总是更好”的直觉,提示实践者在固定计算预算下应优先获取更长序列,并关注量化精度和词表设计对泛化保证的影响。
Transformer模型在训练中未见过的更长、更复杂的问题上展现出惊人的泛化能力,但理论解释一直滞后。近期一篇论文《Quantitative Generalization Bounds for Multi-Layer Transformers: A Few Long Strings can Beat Many Short Ones》对固定精度Transformer的两种泛化——分布内统计泛化和长度泛化——进行了联合分析,并给出了基于参数规模、量化空间和字母表大小的泛化保证。
两种泛化轴线的分离与联合
传统机器学习泛化理论主要关注分布内泛化:模型能否从训练样本推广到同一分布的新样本。但语言数据具有序列性,模型还需要长度泛化:在给定长度输入上训练的模型能否外推到更长输入。论文指出,这两种泛化此前大多被分开研究,它们如何相互作用尚不清楚。
该工作对固定精度Transformer同时考虑这两个轴,给出了联合泛化边界。边界依赖于模型参数规模、量化空间以及序列的字母表大小。这意味着,理论保证不仅与模型容量有关,还与数值精度和词汇表大小挂钩。
固定精度Transformer指的是模型权重和激活值以有限位宽(如8位、4位)进行量化的Transformer,而非传统的32位浮点表示。这种量化在推理加速和边缘部署中很常见,但会引入舍入误差和离散的参数空间。论文之所以限定“固定精度”,是因为量化后的参数空间是有限的,这为推导泛化边界提供了组合计数的基础——模型的假设空间大小受限于参数量和量化级数,从而可以用离散数学工具给出保证。相比之下,全精度模型的参数空间是连续的,泛化分析需要依赖不同的容量度量(如VC维或Rademacher复杂度),难以直接与序列长度挂钩。
训练长度与样本数的指数级权衡
论文的核心发现之一是:增加训练长度可能比增加样本数指数级更高效。换句话说,少量长字符串的训练效果可能优于大量短字符串。这一结论挑战了“更多数据总是更好”的直觉,为数据收集策略提供了新视角。
作者通过实验验证了理论预测。实验支持了样本数和训练长度之间的权衡关系,表明在固定计算预算下,优先获取更长序列可能带来更大的泛化收益。
长度泛化(length generalization)是指模型在训练时只见过较短序列,测试时却要处理更长序列的能力。这与分布内泛化不同:分布内泛化的测试输入与训练输入同分布,而长度泛化的测试分布发生了系统性偏移(序列变长)。对Transformer而言,长度泛化尤为关键,因为位置编码、注意力掩码等机制在训练长度之外可能失效。理论分析长度泛化通常需要刻画模型如何将学到的模式(如局部依赖、语法规则)外推到更长的上下文,这比同分布分析更复杂。论文将长度泛化与统计泛化联合建模,正是为了捕捉“在短序列上训练、在长序列上测试”这一实际场景中的泛化风险。
理论边界的实际意义
对于实践者,该理论提示在训练Transformer时,应重视序列长度的作用。尤其是当任务需要模型处理长依赖时,增加训练长度可能比单纯增加样本量更有效。此外,量化空间和字母表大小的影响也提醒我们,模型精度和词表设计会影响泛化保证。
不过,该理论针对固定精度Transformer,实际应用中还需考虑其他因素如架构变体和训练动态。未来工作可以进一步探索这些边界在更复杂场景下的紧致性。
字母表大小在论文中指的是输入序列的词汇表规模(即不同token的数量)。在泛化边界中,字母表大小影响模型需要区分的模式数量:字母表越大,可能的序列组合越多,模型从有限样本中覆盖所有模式所需的样本量或序列长度就越大。直观地说,词汇表越大,语言越“丰富”,泛化保证越宽松。这一项提醒实践者,词表设计(如使用BPE合并粒度)不仅影响计算效率,也间接影响模型的泛化难度——过大的词表可能要求更多的训练数据或更长的序列才能达到同样的泛化保证。
相关推荐
CodeMode:让AI代理写代码代替调用工具,token成本直降90%
探索CodeMode如何让AI代理通过编写代码在沙箱中执行,替代传统逐个调用工具的方式,从而减少token消耗高达90%,并分析其实现要点与适用场景。
开发者自研PyTorch优化器ApexW:显存减半、提速1.5倍
开发者发布PyTorch优化器ApexW,采用紧凑优化器状态与Triton执行路径,在仅优化器基准中比fused AdamW快约1.5倍、状态显存约减半,但小张量与自动模式仍有明显短板,作者公开征集基准与实现反馈。
RL博士研究方向怎么选?六大前沿领域深度解析
RL博士研究方向怎么选?本文深度解析RL for LLMs、离线RL、安全RL、世界模型、多智能体RL和机器人RL六大前沿方向的开放问题、优势与风险,并提供兴趣匹配、产业价值平衡、导师匹配和技能可迁移性四个选择框架,帮助博士生做出明智决策。