Transformers v5.19.0 发布:EmbeddingGemma 2 多模态嵌入与 MoE 重大变更

Transformers v5.19.0 新增谷歌多模态嵌入模型 EmbeddingGemma 2,并对 MoE 输出、注意力机制和持续批处理 API 做出破坏性变更。
Hugging Face Transformers v5.19.0 的核心新增是谷歌 EmbeddingGemma 2——一个基于 Gemma 4 架构的多模态嵌入模型,可将文本、图像、音频和视频统一编码到 768 维共享向量空间,并通过 Matryoshka 表示学习支持灵活降维。与此同时,本版本引入多项破坏性变更:所有 MoE 模型在设置 `output_router_logits=True` 时统一遵循 Qwen3-MoE 模式返回路由 logits;注意力实现中弃用 `paged|` 前缀,SDPA 和 Flash Attention 原生支持持续批处理;专家并行新增 token 分发机制并移除 EP size 等于 TP size 的限制;缓存系统新增逐层配置以支持异构模型结构。对准备升级的团队而言,需重点评估 MoE 输出类适配、持续批处理前缀清理和 OWLv2 检测结果一致性三类影响。
Hugging Face Transformers 库迎来 v5.19.0 版本更新。这次发布的核心亮点是新增谷歌 EmbeddingGemma 2 多模态嵌入模型,同时在混合专家(MoE)模型、注意力机制和持续批处理(Continuous Batching)等底层架构上引入多项破坏性变更。对于依赖该库构建生产系统的工程师而言,这次升级既带来了新能力,也需要留意 API 兼容性问题。
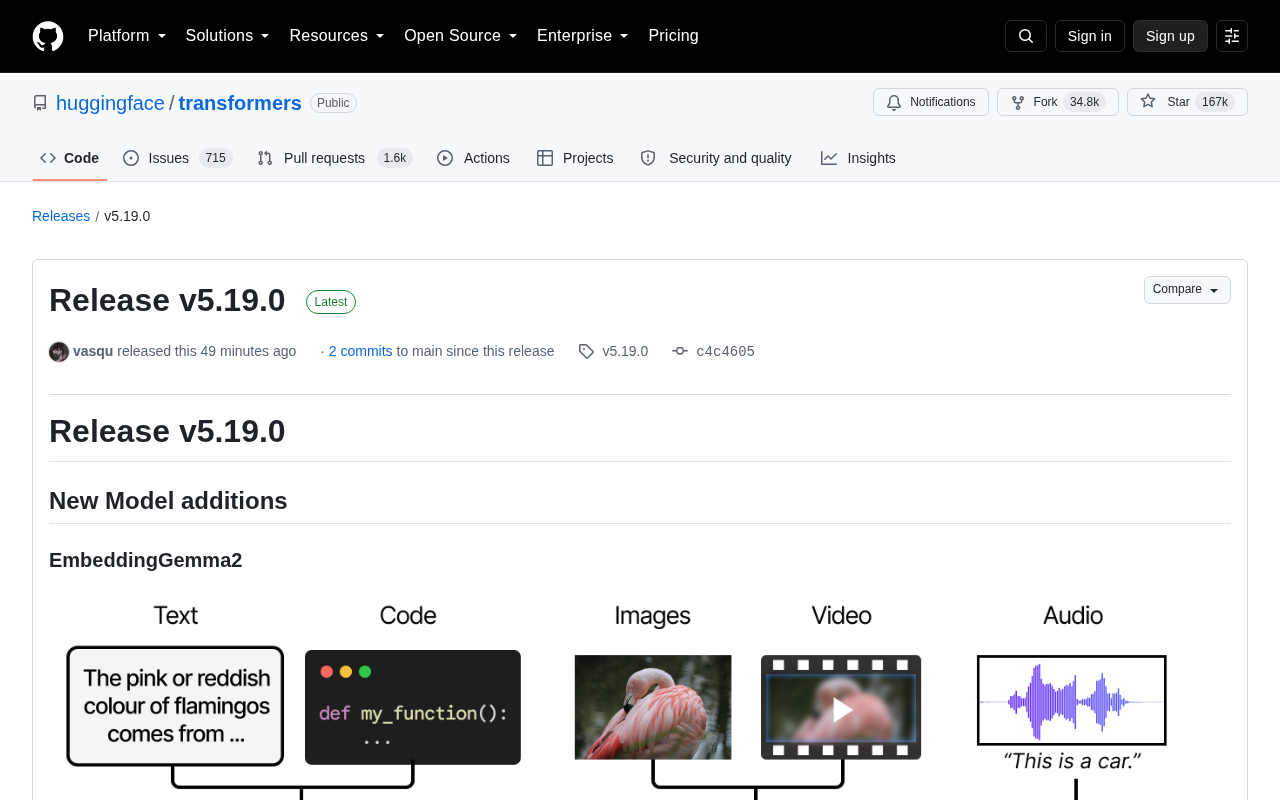
EmbeddingGemma 2:跨模态统一向量空间
本次版本最受关注的新模型是 EmbeddingGemma 2,这是谷歌基于 Gemma 4 架构打造的多模态嵌入模型。它能够将文本、图像、音频和视频——无论单独输入还是组合输入——编码到一个共享的 768 维向量空间中,从而支持跨模态检索、语义相似度计算、聚类与分类等任务。
该模型采用了 Matryoshka Representation Learning(俄罗斯套娃表示学习)技术,这意味着嵌入向量可以被截断到 512、256 或 128 维,而不会严重损失表达质量。这一特性对于需要在存储成本与检索精度之间权衡的场景尤为实用。
此外,EmbeddingGemma 2 还提供可配置的视觉与视频 token 预算,并允许在加载时禁用未使用的视觉或音频塔(vision/audio tower)以节省内存。对于只处理纯文本或图文场景的用户,这种灵活的组件裁剪能力能够显著降低部署开销。
Matryoshka Representation Learning(MRL,俄罗斯套娃表示学习)是由 Kusupati 等人于 2022 年提出的一种嵌入训练范式。其核心思想是在训练时同时优化多个粒度的嵌入子向量——例如完整的 768 维以及其截断后的 512、256、128 维前缀——使得较短的子向量也具备良好的表达能力。这与传统嵌入模型形成对比:传统模型若要降维通常需要额外的 PCA 或量化步骤,且会明显损失语义信息。MRL 的实际意义在于,同一个模型可以在不同资源约束的场景下复用:高精度检索时使用完整维度,大规模粗筛时使用低维度以节省存储和计算,无需重新训练或部署独立模型。OpenAI 的 text-embedding-3 系列也采用了类似技术,是目前生产环境中应用 MRL 的知名案例。
MoE 模型统一返回路由 Logits
这次更新中最需要开发者注意的破坏性变更,是所有计算路由 logits 的 MoE 模型行为的统一。现在,当设置 output_router_logits=True 时,这些模型都会返回路由 logits,遵循 Qwen3-MoE 的既定模式。
具体来说,基础模型上会有一个 router_logits 记录器,骨干网络输出 MoeModelOutputWithPast,而模型头部则输出一个 MoE 因果语言模型输出类。这意味着原先依赖旧输出结构或假设 logits 不存在的代码,都需要改为从这些新的输出类中读取路由 logits。
这一改动虽然统一了 API 的一致性,但也要求相关下游代码进行适配,是本次版本中影响面较广的变更之一。
混合专家(Mixture of Experts,MoE)架构的核心是路由机制:对于每个输入 token,路由器(router)会计算一组 logits,经过 softmax 后决定将该 token 分配给哪几个专家子网络处理。路由 logits 不仅决定了计算路径,也是分析模型负载均衡和实现辅助损失(auxiliary load-balancing loss)的必要信号——若某些专家被过度使用而其他专家闲置,会导致训练不稳定和推理效率低下,通常需要通过路由 logits 计算额外的均衡损失来缓解这一问题。在 Transformers 库的历史实现中,不同 MoE 模型(如 Mixtral、DeepSeek广告-MoE、Qwen3-MoE 等)在是否暴露路由 logits 及其输出位置上存在差异,导致下游代码需要针对不同模型分别处理。此次统一到 MoeModelOutputWithPast 和配套的头部输出类,简化了跨模型复用训练和分析代码的工作量。
注意力机制与持续批处理的重构
在性能相关的底层架构上,这次版本对注意力机制做了多项调整,核心围绕持续批处理(Continuous Batching,CB)展开。
首要变化是弃用了 SDPA 和 Flash Attention 实现中的 "paged|" 前缀。开发者在使用持续批处理时,应当直接设置常规的注意力实现(如 sdpa 或 flash_attention_2),而不再使用 paged|sdpa 或 paged|flash_attention_2 这样的写法。相应地,常规的 Flash 和 SDPA 注意力函数现在原生支持持续批处理,"paged|..." 实现会被重定向到它们;而 eager 模式仍需保留 "paged|eager" 前缀。
在持续批处理内部,针对索引路径和块表(block-table)路径的缓存更新被融合为单次调用,这轻微改变了缓存更新函数的行为,调用独立更新路径的自定义代码需要留意。此外,持续批处理也变得更加设备无关,并新增了对 XPU 的支持。
另一处值得注意的模型行为变更是 Owlv2ForObjectDetection.embed_image_query。它现在会按照原始 OWLv2 notebook 的做法,选择 objectness 得分最高的查询框,而非沿用 OWL-ViT 的启发式方法。因此图像引导的查询嵌入和检测结果可能与早期版本有所差异。
持续批处理(Continuous Batching)是现代 LLM 推理服务(如 vLLM、TGI)的关键优化技术。传统静态批处理要求同一批次内所有请求同步完成,导致短请求需等待长请求,GPU 利用率低。持续批处理则允许在每个解码步骤后动态插入新请求或移除已完成请求,从而大幅提升吞吐量。其底层依赖分页注意力(Paged Attention)——将 KV 缓存划分为固定大小的"块"并通过块表(block table)进行非连续内存管理,类似操作系统的虚拟内存分页,避免了为每条序列预分配最大长度缓存所带来的内存浪费。此次更新将 paged| 前缀逻辑内聚到标准注意力实现内部,意味着开发者无需在 API 层感知分页细节,框架自动处理持续批处理所需的内存管理,是对底层复杂性的一次有效封装。
并行化与缓存配置增强
在分布式训练方面,专家并行(Expert Parallelism,EP)得到了显著强化。新版本引入了 token 分发(token-dispatch)实现,通过新的 ep_dispatch_experts 规划规则选择,并已成为 Qwen3 MoE 和 Mellum 的默认方式。这一改进移除了 EP size 必须等于 TP size 的限制,让专家并行的部署更加灵活。同时 Trainer 也适配了专家并行,文档还补充说明 PEFT 适配器支持张量并行。
缓存处理方面修复了量化缓存的若干问题:generate 不再修改用户传入的 cache_config,QuantizedLayer.reorder_cache 得到修复。更重要的是,新增了逐层缓存配置能力,DynamicCache 和 StaticCache 现在会根据每一层各自的配置(滑动窗口、注意力分块大小、卷积状态以及注意力头数量)进行初始化,从而更好地支持异构模型结构。
其他改进与升级建议
本次版本还包含大量 bug 修复和工程优化,包括:将 CI 迁移到 Python 3.11、修复 DataCollatorForLanguageModeling 忽略 seed=0 的问题、修复 Qwen3-VL 的多轴位置 id 分块预填充、以及用乘法替代矩阵乘法来执行 RoPE 以提升效率等。废弃的 pipeline 现在会重定向,而已移除的 pipeline 则会直接抛出异常。
对于准备升级的团队,建议重点评估三类改动的影响:如果使用了 MoE 模型并读取路由 logits,需适配新的输出类;如果在生产中依赖持续批处理,需移除 "paged|" 前缀并测试缓存更新行为;如果使用 OWLv2 做图像引导检测,需验证结果一致性。总体而言,v5.19.0 在扩展多模态能力的同时,继续推进了底层架构向更统一、更高效方向的演进。
相关推荐

一条推文背后:产品留存与商业决策的启示
一条简短的 Twitter 推文反映了用户对某项商业决策的认可,并由此探讨科技产品中商业决策与用户留存之间的关系与启示。
AWS MCP Server 配置指南:让 Claude 直连你的云环境
本文详解如何通过 OAuth 方式配置 AWS MCP Server,将 Claude 与 AI agent 安全连接到 AWS 云环境,涵盖 CLI 验证、清理旧配置、安装服务器、OAuth 授权及 IAM 权限边界等完整步骤。

用MCP给AI编程助手共享记忆:告别重复解释代码
AI编程助手常因缺乏跨会话、跨仓库记忆而需要反复解释代码。本文解析如何通过MCP协议和mFlow平台为AI助手搭建共享记忆与知识库,实现自动文档生成、技术债务工单拆分及多助手协同。