Triton内核追平bitsandbytes:为何双双输给数学

Triton手写W4内核在RTX 3060上追平bitsandbytes,但bf16基线以带宽效率胜出。
一位开发者在RTX 3060上用Triton手写面向batch-1解码的融合W4A16 GEMV内核,以25.5 tok/s追平bitsandbytes NF4的25.7 tok/s,困惑度更低(15.76对18.98)。但bf16基线以31.3 tok/s胜出,达到roofline的29.8%,量化方案仅6.1%。项目用roofline方法论先实测内存带宽(323.9 GB/s),再算理论上限,逐层定位差距。主要瓶颈是标量nibble解包循环,每MAC约6个ALU操作且无流水线;Marlin靠异步拷贝和软件流水线隐藏了这一开销。作者还踩过autotune与atomic_add冲突的坑,并诚实报告了按实际移动字节计算差距为9.6倍而非16倍两个口径。
Triton内核追平bitsandbytes:为何双双输给数学
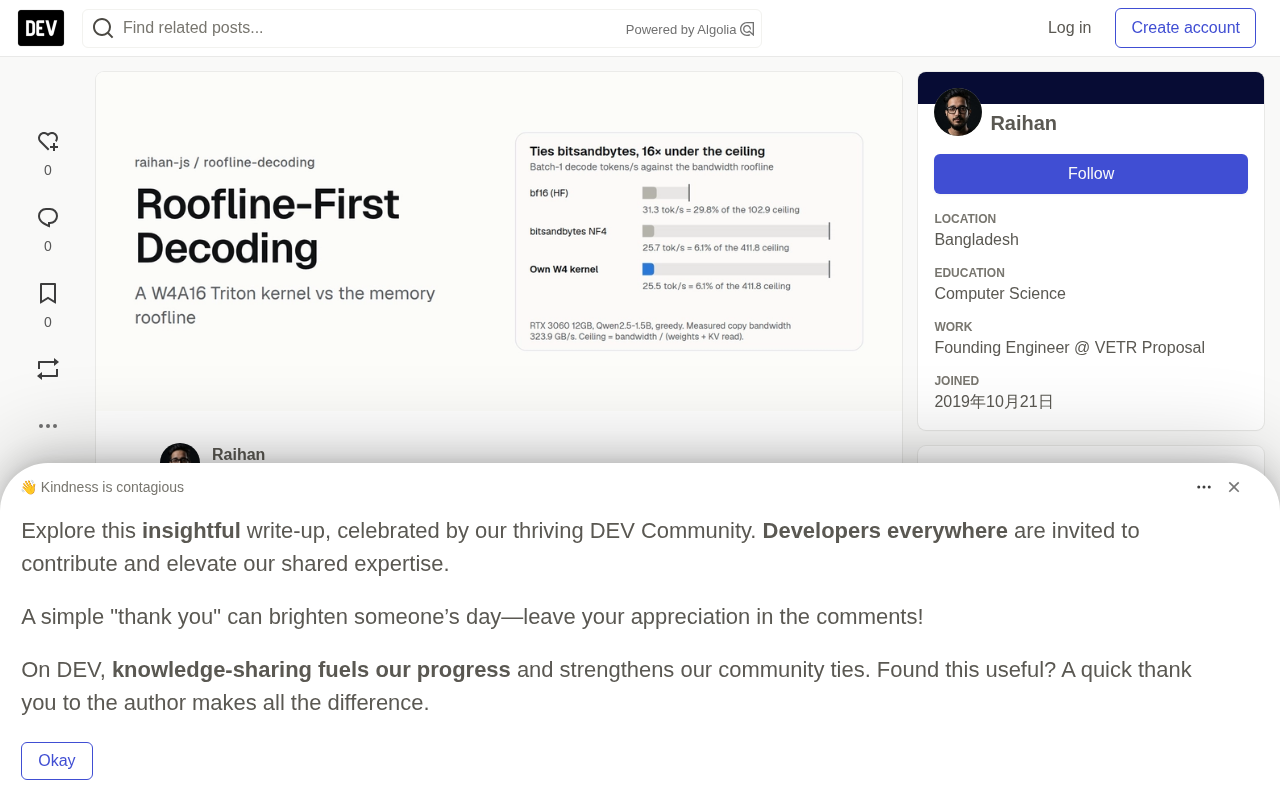
在RTX 3060上,一位开发者用Triton手写了一个面向batch-1解码的融合W4A16 GEMV内核,速度追平了bitsandbytes的NF4量化方案——两者都在约25.5 tok/s附近。然而,bf16基线却以31.3 tok/s的实测成绩轻松胜出,仅达到理论roofline的29.8%。这个结果看似反直觉:量化明明减少了权重体积,为什么反而更慢?答案藏在内存带宽、解码开销与内核工程的三重博弈之中。
Roofline先行:算清上限再写代码
项目的核心方法论是“先测量,再写代码,最后解释差距”。开发者首先用torch copy benchmark实测了RTX 3060的实际内存带宽:323.9 GB/s(spec标称360 GB/s,实测打九折)。基于此,batch-1解码的roofline天花板可以直接算出——每个token需要读取全部权重一次,加上2048-token的KV-cache读取。
| 模型 | dtype | 权重 (GB) | 理论上限 (tok/s) |
|---|---|---|---|
| Qwen2.5-1.5B | bf16 | 3.087 | 102.9 |
| Qwen2.5-1.5B | int4 | 0.772 | 411.8 |
| ORCH-Fusion | bf16 | 0.550 | 539.7 |
| ORCH-Fusion | int4 | 0.137 | 2158.8 |
两个值得注意的细节:Qwen2.5的绑定embedding(151,936 token)占权重的约15%;ORCH-Fusion的矩阵极小,启动开销可能成为主导因素。这意味着int4理论上有411.8 tok/s的上限,但实测只有25.5 tok/s,存在约16倍的鸿沟——这个差距本身就是项目的意义所在。
Roofline 模型是一种性能分析框架,由伯克利的研究者提出,用于判断一个内核在给定硬件上究竟受限于计算吞吐还是内存带宽。其横轴是算术强度(Arithmetic Intensity),即每读取一字节数据所执行的计算操作数;纵轴是可达性能(FLOPS 或 tok/s)。硬件会呈现一个“屋顶”形状:低算术强度区域是斜线(内存带宽受限区),高算术强度区域是水平线(计算峰值受限区),两者的交点称为“脊点”。对 batch-1 解码这类自回归推理而言,每生成一个 token 都要把全部权重从显存读一遍,却只做极少量的矩阵乘加,算术强度天然极低,因此必然落在斜线一侧——即内存带宽瓶颈区。这也是为什么文章用实测带宽乘以权重字节数就能直接算出理论 token 上限:在带宽受限区,性能天花板完全由“每 token 需搬运的字节数”决定,而与 GPU 的算力无关。
三个内核版本与两个栽跟头的Bug
开发者实现了三个逐步演进的Triton内核,全部在真实矩阵形状上与PyTorch参考实现做了正确性验证:
- v1(先反量化再矩阵乘):物化fp16后调用torch matmul,展示了额外内存遍历的代价——比v2慢3到7倍。
- v2(融合):单个内核,即时反量化,不物化中间结果。
- v3(split-K + 调优):autotuned tile,对大矩阵使用split-K并行。
一个反直觉的发现是:v3在五个形状的微基准中都不比v2快(v2快1.0到1.4倍),但端到端解码却使用了v3。融合内核本身在宽MLP-gate形状上比预反量化参考快最多5.5倍,说明将v2换入解码循环是显而易见的下一步实验。
过程中踩了两个“承重级”Bug。第一个是打包时遗漏了**+8 zero-point**,导致所有权重被破坏,在首次GPU运行前的代码审查中被拦截。第二个更隐蔽:@triton.autotune与atomic_add的冲突——autotune会用同一个输出缓冲区对所有配置做约500次计时,而split-K内核会向缓冲区累积结果,导致缓冲区里堆了约500份过期副本,最先调优的配置实际在基准测试垃圾数据。修复方式是显式调优:每次试验用全新缓冲区,缓存胜出配置。
split-K 是矩阵乘法并行化的一种策略。标准 GEMM 会把输出矩阵按行和列切分成 tile,每个线程块负责一个 tile 的所有累加。但当矩阵的某一维极小(例如 GEMV 中输出维度很小、K 维很长)时,可切分的 tile 数量不足以填满 GPU 的所有 SM,导致大量计算单元空闲。split-K 的做法是把归约维度 K 再切成若干段,让多个线程块各自计算部分和,最后通过 atomic_add 或二次归约把部分和合并。代价是引入了写冲突和额外的原子操作开销,在 K 不够长时反而可能拖慢速度——这解释了文中 v3 在多个形状的微基准上不敌 v2 的反直觉现象:对小矩阵来说,split-K 带来的并行度收益抵不过原子累加与调度开销。
@triton.autotune 是 Triton 提供的自动调优装饰器:它会对同一内核的多组编译配置(如 BLOCK_SIZE、num_warps、num_stages)逐一实际运行并计时,最终缓存并选用最快的配置。其默认行为是复用同一份输入/输出缓冲区做反复计时以保证公平。但当事先不知道哪个配置正确、且内核本身会向缓冲区做累积写入(如 split-K 用 atomic_add 累加)时,这次复用的缓冲区会不断叠加各配置的中间结果,使后续计时读到的是被污染的数据。修复思路因此是把“自动调优”改为“显式调优”:为每次试验分配全新缓冲区,跑完后单独测速,再缓存胜出配置。
实测数字:追平bnb,但都输给bf16
| 方案 | tok/s | Probe ppl | GB/s | % of roofline |
|---|---|---|---|---|
| bf16 (HF) | 31.3 | 12.91 | 96.6 | 29.8% |
| bitsandbytes NF4 | 25.7 | 18.98 | 19.8 | 6.1% |
| 自研 W4 (v3) | 25.5 | 15.76 | 19.7 | 6.1% |
自研内核在速度上追平bitsandbytes,且困惑度更好(15.76 vs 18.98)。但两者都输给了bf16——后者以roofline的29.8%成为全场工程最优路径。这个结果说明:在batch-1解码场景下,权重量化省下的带宽,被反量化的计算开销和内核效率损失抵消了。
为什么Marlin仍然更快,以及6%的诚实
逐层拆解显示:GEMV时间合计约25ms,而完整decode step约39ms,其余部分是attention、norm、采样和Python调度。在GEMV时间内,标量nibble解包循环(每个元素的shift、mask、subtract、scale)主导了开销——每个MAC约6个ALU操作且无流水线。Marlin正是用async copy、软件流水线和提前bit staging隐藏了这部分。开发者尝试了tl.dot重写,结果慢4到7倍——dequant-scatter进dot tile的代价超过了dot节省的部分,这一负面结果被如实报告。
关于6.1%这个数字还有一个更公平的分母:412 tok/s的int4上限假设所有权重都是int4,包括绑定的embedding/lm_head。在替换后的模型中,该矩阵保持bf16,因此每个token实际读取1.263 GB权重(外加约0.06 GB KV cache)。按实际移动的字节计算,25.5 tok/s相当于约34 GB/s,约为实测带宽的10%,模型自身的天花板约245 tok/s——差距约9.6倍而非16倍。两个口径都写进了结果文件;6.1%这个头条数字是相对于全int4理想值而言的。
Marlin 是 vLLM 生态中一个高度优化过的 int4/int8 权重量化推理内核,专为 batch 极小(含 batch-1)的 LLM 解码设计。它的核心技巧是把反量化与矩阵乘在流水线层面重叠:通过 cp.async 异步拷贝把权重从显存预取到片上,用软件流水线让“取权重—解包—乘加”三段并行,并在数据进入计算单元前就完成 bit staging(把打包的 4-bit nibble 提前展开成可乘的形式)。这样一来,nibble 解包这种在朴素内核中占主导的标量 ALU 操作就被隐藏到访存延迟之后,实际生效的瓶颈回到带宽本身。这正是文中自研内核与 Marlin 的差距所在——两者算法相同,但工程实现成熟度不同。作者尝试用 tl.dot 替代标量循环却慢 4–7 倍,说明在 GEMV 这种极低算术强度的形状下,dequant 后散射进 dot tile 的代价超过了张量核带来的收益。
局限与下一步
作者坦诚列出了局限:probe困惑度只用了4句话(噪声大);bnb量化的层与自研swap不同,ppl差距是方向性的而非定论;Marlin无法编译(torch 2.13 / CUDA 13),llama.cpp未安装,都缺少对比;单prompt计时,仅batch-1、仅greedy。ORCH-Fusion端到端仍待完成。
下一步计划包括:GPTQ风格的校准scale来缩小ppl差距、用CUDA graphs包裹decode step来验证ORCH形状上的启动开销假设、以及为ORCH-Fusion编写专属checkpoint loader。仓库有46个测试全绿。
这个项目的价值不在于打败Marlin,而在于用roofline方法论把每个性能差距都量化到可解释——这比一个漂亮的加速比数字更有教育意义。
相关推荐

Cursor AI编程实战:30分钟从零构建学生管理系统
B站UP主实战演示Cursor AI编程:30分钟用自然语言生成学生管理系统。详解Agent模式、Claude模型选择、提示词技巧与使用门槛,帮你判断Cursor是否值得入手。

AI编程工具20强榜单:从夯到拉的评分矩阵
B站UP主发布AI编程工具20强榜单,从夯到拉分为T0-T4五个层级,Claude Code和Codex并列T0。本文详解评分维度(能力、可靠性、耐操性、耐久性、成本、国内可用性)及工具表现,帮助开发者选择适合的AI编程助手。

Vibe Coding系统教程:零基础玩转AI编程实战
B站UP主耗时三个月打造的Vibe Coding系统教程,覆盖Codex、ClaudeCode、Cursor等AI编程工具,从基础逻辑到商业级项目实战三段式讲解,适合零基础学习者系统入门AI编程。