TS+Zod全栈实战:从类型安全到openclaw智能体

TypeScript+Zod构成AI应用层从类型统一到运行时校验的闭环,是AI全栈的实用入场券。
文章围绕B站UP主的分享,论证TypeScript配合Zod正在成为企业级AI应用的核心技术组合。核心逻辑是:大模型输出具有非确定性,而企业应用要求标准化,TypeScript负责应用层代码统一,Zod负责模型输出的结构约束,二者形成从开发规范到运行时校验的闭环。文中介绍了Zod的parse运行时校验、describe注入提示词语义、coerce类型宽容转换与refine业务规则校验等能力,并通过Ollama本地部署千问3、LangChain创建agent、传入Zod schema作为response_format的实战,演示了文本与多模态输入均能输出结构化JSON。文章还梳理了LangChain.js、RAGFlow.ts、Mastra等TS AI框架生态,同时提醒「百万年薪」叙事含营销成分,真正价值在于掌握LLM输出标准化的工程能力。
在AI开发领域,Python与TypeScript的生态竞争从未停歇,但一个被低估的事实是:前端技术栈在AI应用层正展现出惊人的爆发力。B站UP主在近期分享中旗帜鲜明地指出,TypeScript配合Zod的组合,正在成为构建企业级AI应用的核心竞争力,其生态丰富度甚至超越Java。
为什么TS+Zod是AI全栈的入场券
AI开发中存在一个根本矛盾:大模型的输出本质上是非确定性的,而企业应用要求高度标准化。UP主在视频中反复强调,TypeScript解决的是应用层的代码统一问题,Zod解决的则是模型输出层的结构约束问题。两者结合,恰好构成了从开发规范到运行时校验的完整闭环。
从市场反馈看,这种技术选型并非孤例。YouTube上多个AI工程频道也讨论过类似观点:在构建LLM应用时,TypeScript的类型系统能显著降低多团队协作的沟通成本,而Zod作为schema定义标准已被OpenAI官方SDK采纳,这本身就是行业风向标。
Zod:从编译时到运行时的桥梁
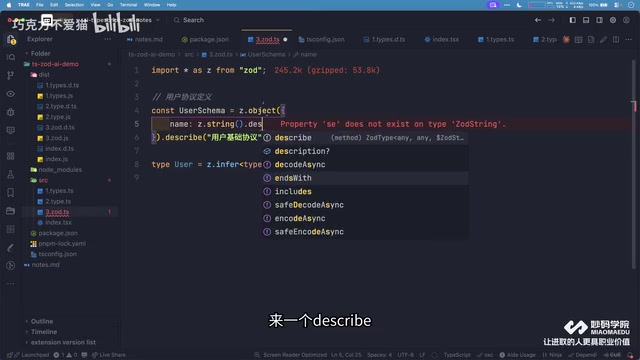
传统TypeScript的价值在于编译时检查,但AI应用的数据往往在运行时才产生。UP主在演示中定义了一个用户协议schema,当输入数据从{name: '合一', age: 18}变为age: '18'时,Zod的parse方法会立即抛出错误。这种运行时防护对于处理大模型返回的不可靠数据至关重要。
更关键的是,Zod的describe方法能将字段语义注入到给大模型的提示词中——UP主在Demo中把年龄字段描述从“用户年龄”改为“用户今年的年龄”后,模型自动将“明年18岁”计算为17岁输出。这种通过schema驱动提示词工程的思路,比手写提示词更可控。
Zod 与 JSON Schema 的关系:Zod 是一个 TypeScript 优先的 schema 声明与校验库,它并不直接等同于 JSON Schema,但可以借助 zod-to-json-schema 等工具将 Zod schema 转换为 JSON Schema。OpenAI 等厂商的函数调用/结构化输出接口底层普遍使用 JSON Schema 描述期望的输出格式,因此 Zod 实际上充当了「开发者友好的书写层」,最终仍会被序列化为标准 schema 提交给模型。理解这一层转换关系,有助于排查「模型为什么不按 schema 输出」——问题往往出在转换后的 JSON Schema 是否足够精确,而非 Zod 本身。
实战路径:从零初始化到智能体输出
视频中UP主演示了完整的项目搭建流程,其严谨程度值得借鉴:安装TypeScript时特意指定5.9.3版本,并解释为何要检查node_modules/.bin目录下的tsc软链接——“学习时要把每一步的调用链路搞清楚,而不是复制命令”。
工程化配置的关键决策
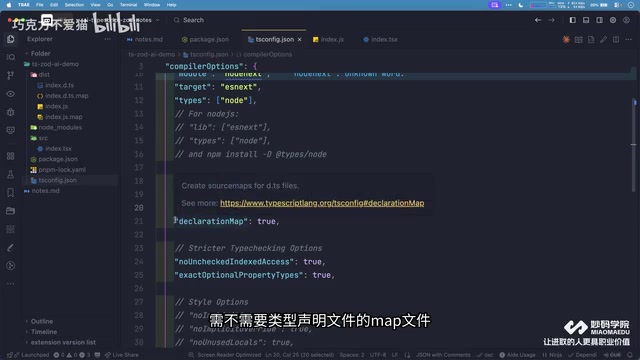
在tsconfig配置环节,UP主给出了明确的前后端分界建议:前端应用将module设为esnext、moduleResolution设为bundler;Node.js项目则保持CommonJS规范。这种差异化配置直接影响AI应用能否顺利接入Vite等现代构建工具。
module 与 moduleResolution 的含义:module 决定编译后代码采用哪种模块语法(如 esnext 输出原生 import/export,commonjs 输出 require),moduleResolution 则决定 TypeScript 如何解析 import 路径。二者必须与运行时环境匹配:Vite 等现代打包器基于 ESM,因此前端项目通常用 esnext + bundler;而许多 Node.js 服务与部分 AI SDK 仍以 CommonJS 分发,混用会导致「找不到模块」或「无法在 CommonJS 中使用 import」等报错。这也是 AI 全栈项目常见的踩坑点——同一仓库中前后端 tsconfig 往往需要分开维护。
类型工具的实战价值
视频中展示了Omit和Pick在AI场景下的妙用。比如定义User类型包含name和age,但创建轻量用户对象时只需name,用Omit<User, 'age'>即可派生新类型。这种类型操作在构建RAG系统时尤为常见——文档块、向量、元数据往往需要从基础类型派生不同形态。
结构化输出:智能体开发的分水岭
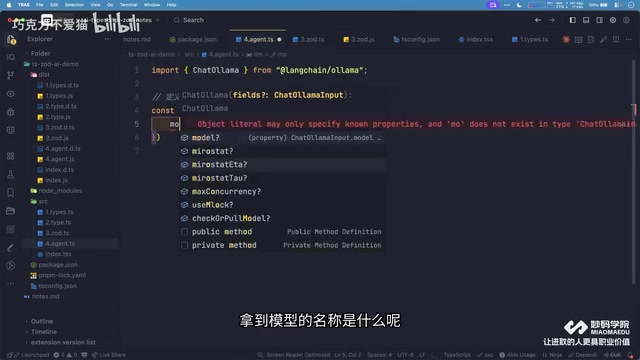
最令人印象深刻的Demo出现在智能体环节。UP主先用Ollama本地部署千问3模型(0.6B参数版本),然后通过LangChain创建agent,并传入Zod定义的userSchema作为response_format。当输入“你好,我先自我介绍一下,我是合一,今年18岁”时,模型直接返回了结构化JSON:{name: '合一', age: 18}。
更精彩的是多模态测试:将同样内容的图片传给千问3-VL模型,agent依然输出了标准化结果。据UP主和部分观众在评论区确认,这验证了Zod schema可以跨模态约束输出格式。
宽容模式与自定义校验
Zod的coerce特性在AI场景下被重点推荐。当模型输出age: '18'字符串时,z.coerce.number()会自动转换为数字,避免因类型不匹配导致流程中断。而refine方法则用于处理业务规则——比如时间区间schema中,必须保证开始时间早于结束时间。
coerce 的代价与 refine 的定位:z.coerce.number() 本质上是先对输入执行 Number() 转换再校验,因此它会把 '18' 转成 18,但也会把空字符串转成 0、把 true 转成 1,在宽松处理模型输出的同时可能掩盖数据质量问题。实践中更稳妥的做法是仅在明确知道模型可能返回字符串数字的字段上使用 coerce,其余字段保持严格校验。refine 则用于表达 schema 结构无法覆盖的跨字段或业务规则,它返回布尔值并可附带自定义错误信息,但默认不会短路后续校验,复杂场景可配合 superRefine 获得更精细的错误路径控制。
生态全景:被忽视的TypeScript AI框架
UP主列举了前端AI生态的多个框架,这部分信息在多数中文技术社区中较少被系统整理:
- LangChain.js / LangGraph.js:智能体编排的主流选择
- RAGFlow.ts:面向RAG工程的专用框架
- Mastra:专注Agent开发的TS框架
- LlamaIndex.ts:数据索引与检索层
说个细节(此处引用UP主个人判断),他认为TS生态在AI应用层比Java的Spring AI或LangChain4j更活跃。这一观点在Hacker News的讨论中也有类似声音,但尚未形成行业共识。
学习路径的取舍
面对TS庞杂的知识体系,UP主划定了核心四模块:类型定义(基础/引用/自定义)、泛型、函数类型、兜底符号(可选链与空值断言)。这种抓大放小的策略,对于已有JavaScript经验的开发者而言,确实能在一周内建立可用认知。
冷静看待“百万年薪”叙事
视频标题中的“百万年薪架构”更多是营销话术。从技术实质看,TS+Zod确实降低了AI应用开发的门槛,但架构能力的核心仍在于对业务场景的抽象——比如如何设计MCP工具协议、如何规划RAG的检索策略。UP主也承认,底层原理和工程化经验需要长期积累。
对于开发者而言,更务实的收获是:掌握Zod的结构化输出能力后,可以快速将任意LLM的返回结果接入现有业务系统。这种“最后一公里”的工程能力,在当前AI落地阶段具有很高的实用价值。
相关推荐

Cognition SWE-2 实战:一个提示词搞定产品发布全流程
解析 YouTube 创作者用 Cognition SWE-2 发布产品的完整提示词:落地页、七封邮件序列与未购买用户跟进工具三段式结构,以及"测试并汇报"这一约束如何改变 AI 的交付质量。
AWS AgentCore Gateway:用MCP打通AI Agent与企…
AWS AgentCore Gateway:用MCP打通AI Agent与企业后端
AWS AgentCore Gateway如何作为主MCP服务器聚合REST API、Lambda与已有MCP服务?解析其AST实时映射、零冷启动、语义搜索治工具过载、会话隔离与密钥注入安全设计,以及企业AI Agent解耦后端的架构思路。

一个链接给Figma AI装上新技能:MCP连接器实战
通过粘贴一个MCP服务器链接,Figma中的AI Agent就能获得新工具能力。本文拆解配置流程、超过20个一键接入应用、读写权限与执行策略设置,以及公开HTTPS链接这一关键限制。