图神经网络入门指南:从零构建GNN知识体系

本文为GNN初学者梳理了一条从直觉到数学、先现代架构后经典论文的高效学习路径。
本文针对已具备深度学习基础、希望真正理解图神经网络(GNN)内部机制的学习者,系统梳理了学习路径与资源。核心建议是:先学现代架构(GCN→GraphSAGE→GAT),再回溯Scarselli 2009年的经典论文,因为原始论文基于「不动点迭代」框架,与现代消息传递范式差异较大,不适合作为入门起点。文章以消息传递(Message Passing)的三步骤——消息、聚合、更新——为主线,详解了GCN的数学公式,并对比了三种主流架构在聚合机制上的设计差异。此外,文章从置换不变性的角度阐明了GNN与MLP、CNN的本质区别,并推荐了斯坦福CS224W等权威学习资源。真正的理解来自数学公式、代码实现与物理直觉三者的反复对照。
为什么GNN成为AI学习者绑不开的一环
在深度学习的版图上,图神经网络(Graph Neural Networks, GNN)正逐渐从一个小众研究方向变为主流工具。从社交网络分析、推荐系统、分子性质预测,到知识图谱推理,凡是数据天然以「关系」形式存在的场景,GNN都展现出传统神经网络难以企及的建模能力。
最近,一位计算机科学本科生在 Reddit 上发帖求助:他已经掌握了基础的人工神经网络、MLP 以及计算机视觉架构,正在做一个可能用到 GNN 的项目。他不满足于「会调用现成的实现」,而是希望真正理解 GNN 的内部运作机制。这个诉求非常具有代表性——很多学习者卡在了「知道 GNN 能做什么」和「理解 GNN 如何工作」之间的鸿沟上。
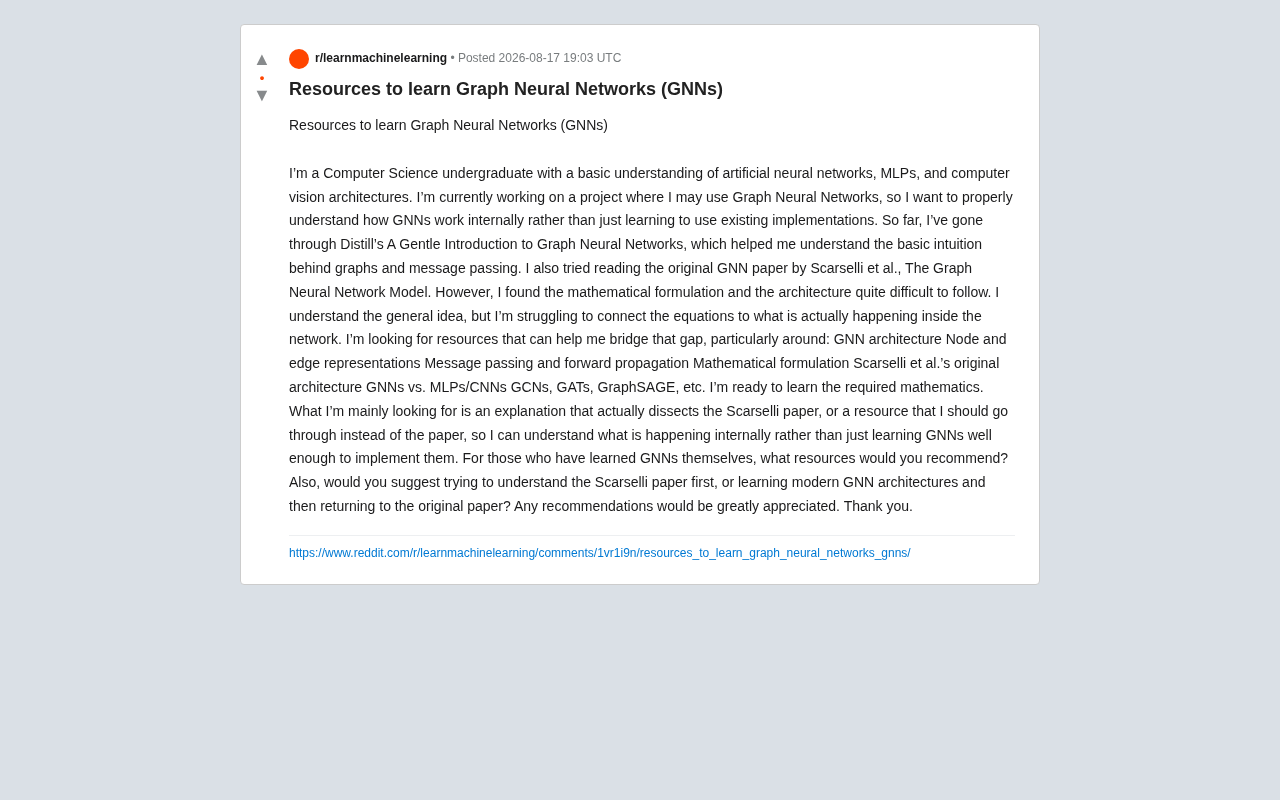
本文将围绕这位学习者的核心困惑,梳理一条从直觉到数学、从经典论文到现代架构的完整学习路径。
学习GNN的两难:先读经典论文还是先学现代架构
这位提问者已经读过 Distill 的经典科普文章《A Gentle Introduction to Graph Neural Networks》,建立了对图结构和消息传递(message passing)的基本直觉。但当他尝试啃 Scarselli 等人 2009 年的原始论文《The Graph Neural Network Model》时,却发现数学公式和架构描述难以跟上——他理解大致思路,却无法把方程和网络内部实际发生的事情对应起来。
这引出了一个关键的学习策略问题:应该先攻克 Scarselli 的原始论文,还是先学习现代 GNN 架构(如 GCN、GAT、GraphSAGE),再回头理解经典论文?
建议:先现代架构,后经典论文
对于大多数学习者,先学现代架构、再回溯经典 是更高效的路径。原因在于:
- Scarselli 2009 年的原始 GNN 采用了基于「不动点迭代」(fixed-point iteration)的递归框架,其数学表述与今天主流的消息传递范式差异较大,学习成本高且实用性有限。
- 现代架构(尤其是 GCN)建立在更简洁、更直观的谱域/空域卷积思想上,公式更容易与代码和直觉对应。
- 一旦理解了 GCN 的消息传递机制,再回头看 Scarselli 的论文,你会发现原始论文的很多思想在现代框架下有了更清晰的对应,反而更容易读懂。
换句话说,原始论文更适合作为「知识考古」,而非入门第一站。
「不动点迭代」(fixed-point iteration)是 Scarselli 原始论文的核心计算机制,值得简单了解以避免初读时的困惑。其思想来源于 Banach 不动点定理:对于一个收缩映射 f,反复迭代 x → f(x) 最终会收敛到唯一的不动点 x* 满足 f(x*) = x*。Scarselli 的 GNN 将节点表示的更新定义为这样一个收缩映射,通过反复迭代直至节点表示不再变化来完成推断。这要求模型参数满足特定的利普希茨条件以保证收敛性,大幅限制了网络的表达能力和训练灵活性。现代 GNN 则转向固定层数的前向传播(L 层消息传递对应 L 跳邻居感受野),完全绕开了收敛性约束,训练效率和表达能力都得到了显著提升。理解这一根本差异,有助于解释为什么现代架构在实践中全面取代了原始框架。
循序渐进的GNN学习路径
第一步:巩固直觉——理解消息传递范式
消息传递(Message Passing)是理解所有现代 GNN 的核心。它的基本思想是:每个节点通过聚合(aggregate)邻居节点的信息来更新自己的表示(representation)。一次消息传递可以拆解为三个步骤:
- 消息(Message):每个节点根据自身和邻居的特征,计算要传递的消息。
- 聚合(Aggregate):将来自所有邻居的消息汇总(求和、求平均或取最大值等)。
- 更新(Update):结合聚合结果和节点自身的旧状态,生成新的节点表示。
理解了这三步,你就掌握了绝大多数 GNN 架构的骨架。Distill 的文章已经打下了这个基础,接下来要做的是把它数学化。
第二步:吃透GCN图卷积网络的数学表述
图卷积网络(Graph Convolutional Network, GCN)由 Kipf 和 Welling 在 2017 年提出,是入门 GNN 数学的最佳起点。其单层传播公式为:
H^(l+1) = σ( D̃^(-1/2) Ã D̃^(-1/2) H^(l) W^(l) )
这个公式看似复杂,但每一部分都有明确含义:Ã 是加了自环的邻接矩阵,D̃ 是对应的度矩阵,D̃^(-1/2) Ã D̃^(-1/2) 是对称归一化后的邻接矩阵(本质上就是「带权重的邻居平均」),H^(l) 是当前层节点特征,W^(l) 是可学习的权重矩阵。
建议对照 Kipf 的原始论文和他的博客文章一起学习,同时找一份 PyTorch Geometric(PyG)或 DGL 的 GCN 实现代码,把公式的每一项和代码中的每一步对应起来——这正是「连接方程与网络内部实际行为」的关键练习。
第三步:横向对比GNN主流架构
掌握 GCN 后,可以横向扩展到其他经典架构,理解它们在「聚合」这一步上的不同设计哲学:
- GraphSAGE:核心创新在于采样邻居 + 可学习的聚合函数,使 GNN 能够扩展到大规模图并支持归纳式学习(inductive learning)。
- GAT(Graph Attention Network):引入注意力机制,让每个邻居的贡献权重由数据自适应学习,而非 GCN 中固定的归一化系数。
通过对比这三者,你会深刻理解 GNN 架构设计的自由度所在。
「归纳式学习」(inductive learning)与「直推式学习」(transductive learning)是理解 GraphSAGE 创新意义的关键概念。早期的 GCN 本质上是直推式的:模型在训练时需要看到完整的图结构,推断时无法处理训练集中从未出现过的新节点。这在动态图场景(如新用户不断加入的社交网络)中是严重的局限。GraphSAGE(Sample and Aggregate)的解决思路是:不学习每个节点的固定嵌入,而是学习一个聚合函数——只要知道一个节点的局部邻域特征,就能为其生成表示。这使得模型可以直接泛化到训练时未见过的节点,实现真正意义上的归纳式学习。邻居采样机制同时解决了大规模图中邻居数量爆炸的问题,使 GNN 能够扩展到数百万节点量级的工业图数据。
GNN与MLP、CNN的本质区别
提问者特别提到想理解 GNN 与 MLP、CNN 的区别,这是一个非常有价值的切入角度。
- MLP 假设输入是固定维度的独立向量,忽略样本内部结构。
- CNN 利用了图像数据的「网格结构」和「局部平移不变性」,通过卷积核在规则网格上滑动提取局部特征。
- GNN 则将 CNN 的思想推广到不规则的图结构上——图没有固定的网格和顺序,节点的邻居数量各不相同,因此 GNN 用「置换不变的聚合函数」替代了固定的卷积核。
可以说,CNN 是图为网格时的 GNN 特例。抓住这条主线,你就能从已有的 CNN 知识平滑迁移到 GNN。
「置换不变性」(permutation invariance)是 GNN 聚合函数必须满足的核心数学性质,直接决定了为什么不能简单地把邻居特征拼接后送入 MLP。对于一个节点,其邻居集合是无序的——节点 A 的邻居 {B, C, D} 与 {D, B, C} 在图结构上完全等价,模型对其输出应当相同。满足置换不变性的聚合操作包括求和(SUM)、均值(MEAN)和最大值(MAX)。值得注意的是,不同聚合函数的表达能力并不相同:SUM 聚合能够区分节点的邻居数量(多集合结构),理论上表达能力最强;MEAN 聚合只能感知邻居特征的比例分布;MAX 聚合则只保留最显著的特征。Xu 等人在 2019 年的论文《How Powerful are Graph Neural Networks?》中通过与 Weisfeiler-Leman 图同构测试的对比,系统分析了不同聚合方式的理论上界,是深入理解 GNN 表达能力的重要参考。
GNN学习推荐资源清单
结合社区经验,以下资源组合能够有效弥合直觉与数学之间的鸿沟:
- 入门直觉:Distill《A Gentle Introduction to Graph Neural Networks》(已读,可作复习)
- 数学与代码结合:Kipf & Welling 的 GCN 论文及其博客、PyTorch Geometric 官方教程
- 系统课程:斯坦福 CS224W《Machine Learning with Graphs》(Jure Leskovec 主讲,被公认为 GNN 领域最权威的公开课)
- 动手实践:DGL 或 PyG 的官方示例,从 GCN 到 GAT 逐个复现
- 经典回溯:在掌握现代架构后,再阅读 Scarselli et al. 的原始论文
结语
学习 GNN 最忌讳的是停留在「会用库」的层面。真正的理解来自于把数学公式、代码实现和物理直觉三者反复对照。对于这位(以及所有类似处境的)学习者,建议不必执着于一开始就攻克 Scarselli 的原始论文,而应以消息传递为主线,从 GCN 入手,逐步扩展到 GraphSAGE 和 GAT,最后再回到经典论文完成知识闭环。一旦这条路径走通,你会发现图神经网络并不神秘——它只是把深度学习的思想优雅地推广到了关系数据的世界。
相关推荐

内华达的“特朗普衰退”:中期选举前的选民懊悔
从拉斯维加斯烹饪工会的拉票现场出发,解析内华达选民为何出现“买家懊悔”,以及贸易战、移民政策与高物价如何影响中期选举选情。

Anthropic IPO:伦理护城河还是信托陷阱?
Anthropic递交IPO申请,营收暴涨1300%至163亿美元,但半年净亏损807亿美元。独特的治理结构让使命优先于股东回报,散户零控制权。本文从财务、治理和竞争格局拆解这场IPO的投资价值。

Anthropic IPO招股书拆解:163亿营收与807亿亏损的真相
Anthropic IPO招股书显示半年营收163亿美元、净亏损807亿美元,但其中724亿为会计调整,核心经营亏损仅6.93亿美元且同比收窄。本文拆解算力承诺、创始人控制权等三大关键事实。