图数据库让事故Agent准确率提升14%,但真相没那么简单

事故诊断Agent用图数据库实现95.2%合成准确率,真实基准优势消失,揭示图结构价值边界。
开发者构建了SynapseGuard事故诊断Agent,将服务调用图、变更日志和人员信息统一存入FalkorDB,通过可达性剪枝和证据打分定位根因,在合成数据上达到95.2%的排名第一准确率,远超无图基线81.6%。然而在真实基准RCAEval上,图结构优势几乎消失,因为该基准缺少变更和主机位置等连接维度。作者还分享了给LLM提供参数化工具而非自由Cypher访问的务实设计、FalkorDB的查询bug与索引优化经验,以及必须在他人的真实数据上做评测的核心教训。
当微服务故障告警响起时,你只知道系统出错了,却不知道是哪个服务、哪次变更惹的祸。一位开发者用图数据库构建了事故诊断Agent,在自建数据集上根因定位准确率达到95.2%,但在真实基准测试中,图结构带来的优势却几乎消失。这背后的经验值得每个做AI Agent的团队细看。
图数据库给事故Agent带来了什么
开发者Mohit Sachin Shirke为Graph Hacks竞赛构建了SynapseGuard,一个从告警出发、沿着服务调用链找到起火点的诊断Agent。核心思路是把Agent需要的全部上下文放进图里:服务调用图(来自OpenTelemetry Demo的真实拓扑)、每个服务所在的主机、变更日志(部署、配置修改、功能开关)、人员信息(团队归属、值班轮换、变更作者),以及Agent自己对历史事故的记忆。
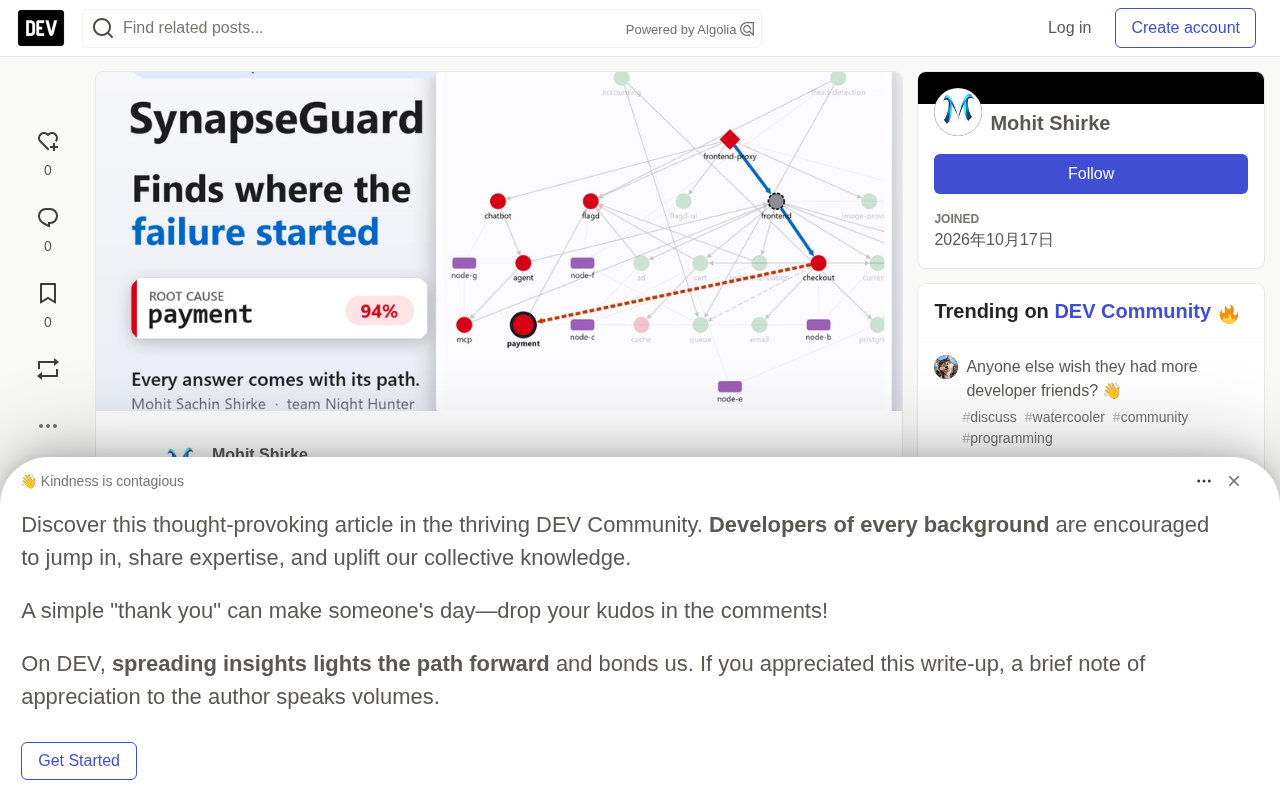
当事故发生时,Agent利用图结构完成五件事:按可达性剪枝(只沿着同步CALLS边追踪到不健康的服务)、基于证据给候选服务打分(候选服务下游是否解释了问题、它是否最先劣化、是否有变更刚刚落地)、给出带证据链的应召人员(比如p-alice → ON_CALL → team-checkout → OWNS → payment这样的路径)、计算爆炸半径并用最大流算法放置断路器、最后等待人工审批后执行操作。
这个设计的巧妙之处在于,每一步决策都能回溯到图上的一条路径。对于凌晨三点被叫醒的运维工程师来说,这比让AI说“相信我”有用得多。
最大流算法(Max-Flow)是图论中的经典算法,用于在带容量限制的网络中寻找从源点到汇点的最大可行流量。在事故诊断场景中,作者将其用于断路器放置:将服务调用图视为网络,边容量代表服务间的依赖强度或流量承载能力,通过计算最大流可以识别出系统中的关键瓶颈路径。在瓶颈处放置断路器,能够在故障扩散时以最小代价切断传播链,同时尽量减少对正常业务的影响。这一算法的优势在于它基于全局图结构而非局部指标做决策,体现了图模型在系统性风险评估中的独特价值。
给LLM图工具,而不是图访问权限
SynapseGuard通过MCP服务器暴露能力,但没有让LLM自由写Cypher查询。取而代之的是一套人工编写的参数化工具目录:blast_radius、who_to_page、path_between、recent_changes等。任何查询执行前,服务名会先在图中解析——如果你问了一个不存在的payments-gateway,Agent不会运行任何查询,而是告诉你这个名字不在图中,并询问你指的是不是payment。
自由格式的Cypher默认关闭,也没有任何工具能审批操作。作者用一个跑在CPU上的8B本地模型做了测试,12道题里选对了12次工具,最后一句输出必须与工具返回结果一致,否则会被拒绝。这个思路很务实:LLM擅长的不是写查询,而是理解意图和解释结果,把安全边界放在工具设计层面而非提示词里。
MCP(Model Context Protocol)是Anthropic提出的一种开放协议,旨在标准化LLM与外部工具、数据源之间的交互方式。它允许开发者将数据库查询、API调用等能力封装为工具,以统一的接口暴露给LLM,由模型根据用户意图选择合适的工具并传入参数。与直接让模型生成SQL或Cypher不同,MCP工具模式将查询逻辑固化为经过审核的参数化模板,模型只负责意图理解和参数填充。这种设计天然限制了模型的自由度过高带来的安全风险,同时降低了模型因不熟悉查询语言而生成错误或危险操作的概率,是当前Agent工程中较为务实的实践范式。
合成数据很美好,真实数据打脸了
在500个留出的合成事故上——带干扰项、红鲱鱼部署和缺失遥测——图Agent将真实根因排在第一位的比例是95.2%。去掉关系、保留相同信号和调参的最强表格基线是81.6%,而作者自己第一版“选最深失败服务”的朴素方案只有25%。合成数据上的信号很明确:图结构值14个百分点。
但作者随后在RCAEval这个真实故障注入公开基准上做了测试,覆盖Online Boutique、Sock Shop和Train Ticket三个系统共645个案例。对于Train Ticket,他从574,479条真实Jaeger span中学习调用图。结果诚实得令人意外:默认设置下图结构的排名与强基线持平,在不同系统上互有胜负,在留出的Train Ticket上还落后4个百分点。
用其他真实系统学习的权重进行调参后,图打分器在6个留出系统套件中的4个上胜出,但作者看到这些结果后并没有修改产品默认值。原因不难理解:图结构的排名优势来自将遥测与变更、主机位置做连接,而RCAEval不包含这些连接数据,图没有可利用的结构信息。
作者的原话是:“我的合成基准在奉承我;真实数据告诉了我图在哪里有用、在哪里没用。”这句话值得所有做Agent评测的人写在墙上。真实数据还抓到了一个合成数据永远不会暴露的bug:严重度分数饱和在1.0,导致服务之间无法区分。
RCAEval是一个面向根因分析(Root Cause Analysis)的公开基准,专门用于评估自动化故障诊断系统在真实故障注入场景下的表现。它覆盖了Online Boutique、Sock Shop和Train Ticket三个典型的微服务演示系统,包含大量真实注入的故障案例和对应的遥测数据(如Jaeger链路追踪span)。与合成数据不同,RCAEval的故障模式、服务拓扑和信号噪声均来自真实运行环境,但正因如此,它不包含变更日志、主机位置等与调用图可连接的辅助维度。作者选择该基准进行评测,恰恰是为了检验图结构在缺乏连接信息时的真实边界,这种评测设计本身就体现了对“自建基准容易过拟合”的警惕。
使用FalkorDB踩到的坑
把FalkorDB 6.0.2推向极限的过程中,作者复现了两个问题:一种查询形状包含两个MATCH … WHERE … IN $list子句时会静默返回空行,除非在两个子句之间插入WITH;另一种查询包含两个OPTIONAL MATCH、一个聚合和ORDER BY时会导致服务器崩溃。
另外两条经验有普适价值。WHERE n.id IN $list能走索引,而UNWIND … MATCH (n {id: x})不会——切换后在1000个服务的规模下调查速度提升了约3.6倍。结果集默认上限是RESULTSET_SIZE(10,000行)且没有警告,所以任何“返回全部”的查询都必须显式限定范围。
FalkorDB是一款基于Redis的图数据库,采用稀疏矩阵和线性代数技术实现高性能图查询,支持Cypher查询语言和OpenCypher标准。它常被用于知识图谱、推荐系统和实时关系分析等场景,因其内存优先的架构在低延迟查询上具有优势。在SynapseGuard项目中,FalkorDB承担了存储服务调用图、变更记录和人员关系等多维上下文的角色,属于典型的图数据库应用场景——将异构实体及其关系建模为节点和边,从而支持多跳路径查询和可达性分析。作者在压测中发现的查询优化器bug和结果集截断问题,也反映了图数据库在复杂查询形状下仍需谨慎验证的工程现实。
一个图数据库从业者的坦诚总结
作者给出了四条经验,每条都有真实数据支撑,而非泛泛而谈。
图结构在答案依赖连接时才有价值。当查询需要把调用关系与变更、部署位置和时间窗口联合起来,关系缺席就会导致相同信号归因到错误的服务上。去掉关系后,同样的指标会指向另一个服务。这解释了为什么合成数据上图优势明显,而RCAEval上优势消失:后者缺少的恰好是图连接能发挥作用的维度。
在别人的数据上做评测。自建基准容易让自己产生错觉,真实数据才能告诉你优势的边界在哪里。
给Agent图工具而非图写权限。只读访问应该放在数据库和工具设计层面,而不是托付给提示词。
让每个答案展示路径。这把“相信我”变成了“检查我”,才是凌晨三点值班工程师真正需要的东西。
代码、基准和原始结果都在GitHub仓库中。对于正在构建需要结构推理的AI Agent的团队来说,这个项目的价值不在于95.2%这个数字,而在于作者愿意把81.6%、持平、落后4个百分点这些不那么好看的结果一起放出来。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。