团队引入Claude后Sprint几天清空:开发效率飙升的隐忧
AI编程工具让Sprint数天内清空,揭示出开发团队从"执行"向"判断"转型的结构性挑战。
一位技术负责人在Reddit分享:团队引入Claude后,原本需数周的Sprint几天内即告完成,随之而来的不是庆祝,而是"快没活干"的尴尬——产品团队措手不及,规划会议占据了大量时间。文章分析认为,这一现象的本质是瓶颈从"写代码"转移到了"决定写什么",同时暴露出产品路线图深度不足的组织问题。短期看,团队需重新校准Sprint估算基准、主动消化技术债;中长期看,软件开发的价值正从"实现"向"判断"迁移——能够定义问题、把控质量、理解业务的能力将取代单纯编码速度成为核心竞争力。这一案例可能预示着未来数年大量开发团队将面临的共同转型。
一个真实的开发团队困境
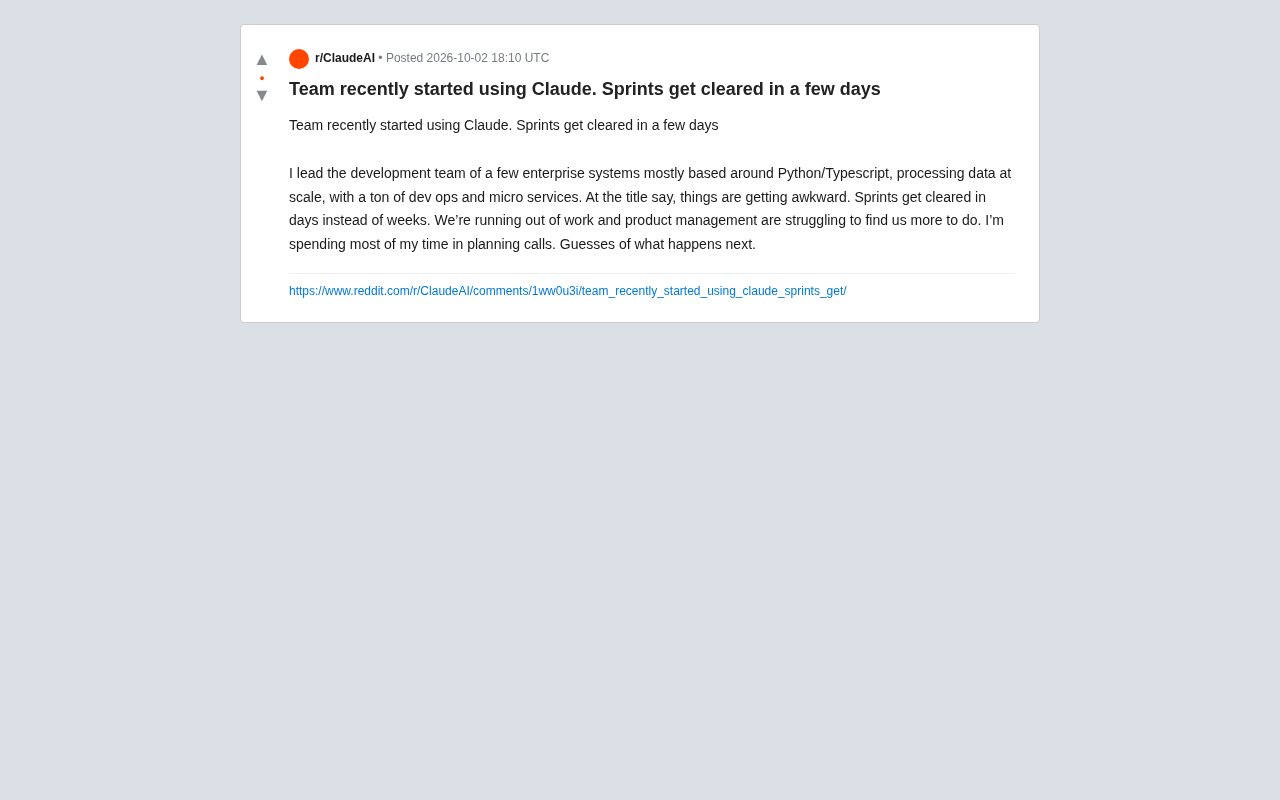
一位带领企业级系统开发团队的技术负责人在Reddit上分享了一个耐人寻味的现象:自从团队开始使用Claude后,原本需要数周才能完成的Sprint,现在几天内就被清空了。
这位团队负责人管理着多个企业系统,技术栈以Python和TypeScript为主,负责大规模数据处理,并涉及大量DevOps和微服务架构。按理说,开发效率提升应该是好事,但他的描述却透出一丝尴尬与不安:"事情变得有点奇怪。Sprint在几天内就清空了,而不是几周。我们快没活干了,产品管理层正忙着给我们找更多任务。我大部分时间都花在规划会议上。"
他最后抛出一个开放式问题:接下来会发生什么?这个问题不只是他个人的困惑,也折射出当下整个软件开发行业正在面对的结构性变化。
效率跃升背后的真实信号
Sprint在几天内清空,这个现象本身值得拆解。传统敏捷开发中,Sprint周期通常为两到四周,团队根据历史速度(velocity)来估算能承载多少工作量。当AI编程工具显著压缩了实际开发时间,原有的估算模型就被彻底打乱了。
这里有几个关键点值得关注。其一,产能的提升是实打实的。企业级Python/TypeScript项目、大规模数据处理、微服务和DevOps,这些恰恰是AI编程助手目前表现较好的领域——有明确规范、有重复模式、有大量样板代码。Claude在生成这类代码、编写测试、处理配置文件方面能带来数倍效率。
其二,瓶颈从"写代码"转移到了"决定写什么"。当实现速度不再是约束,产品管理层反而成了新的瓶颈。负责人提到自己"大部分时间花在规划会议上",这说明团队的价值重心正在从执行向定义需求、梳理优先级迁移。
**速度(velocity)**是敏捷开发中衡量团队单位Sprint内完成工作量的核心指标,通常以"故事点"(Story Points)计算。团队在多个Sprint中积累的历史velocity,是制定计划、与产品方对齐交付节奏的基础。当AI工具使实际编码时间缩短数倍,历史velocity数据便失去参照意义——同样数量的故事点可能只需原来四分之一的时间完成,导致Sprint频繁提前结束、Backlog被快速消耗。这种"校准失效"并非罕见:任何生产力技术的重大跃升(如引入新框架、自动化测试工具)都会短暂打乱既有节奏,区别在于AI编程助手带来的变化幅度更大、传导速度更快,组织需要主动重建估算基准,而不是等待数据自然收敛。
产能过剩揭示的组织问题
"快没活干了"这句话背后,其实暴露的是组织层面的问题,而非技术问题。
如果一个团队因为效率提升就无事可做,说明产品路线图(roadmap)的深度和需求储备的广度本就有限。在AI工具出现之前,这些问题被较慢的开发节奏掩盖了——产品团队有充足时间去规划下一批需求。现在开发速度上来了,需求供给的短板立刻显现。
换个角度看,这恰恰是一个重新配置资源的机会。过去因为"没时间"而被搁置的技术债务、重构、性能优化、监控完善、文档建设,现在都有了处理的空间。真正成熟的团队不会因为Sprint清空就焦虑,而会主动把富余产能投向这些长期价值的工作。
接下来可能发生什么
对于原帖提出的"接下来会发生什么",可以从几个层面来推演。
短期:角色与流程调整
开发团队的日常会更偏向架构设计、代码审查和需求澄清,而非单纯的编码实现。规划会议变多是必然趋势,因为团队需要更频繁地对齐方向。团队可能需要重新校准Sprint的工作量估算基准,否则每次规划都会反复出现"低估"的情况。
中期:岗位结构变化
当单位时间产出大幅提升,同样的业务需求所需的开发人力理论上会下降。这对团队规模是一个潜在压力——要么业务扩张消化掉富余产能,要么面临人员结构的调整。对个人开发者而言,能够定义问题、把控质量、理解业务的综合能力,比纯粹的编码速度更具稀缺性。
长期:价值链条重塑
软件开发的价值正在从"实现"向"判断"迁移。谁能提出正确的问题、设计合理的系统、审慎地验证AI产出的质量,谁就掌握主动权。AI生成代码的速度越快,对代码质量把关、安全审查、系统设计的要求反而越高——因为错误被放大的速度也更快了。
微服务架构是将单一应用拆分为若干小型、独立部署服务的架构模式,每个服务专注于单一业务能力,通过API或消息队列通信。这类架构在大型企业系统中广泛采用,因为它提升了可扩展性和团队自治性,但也带来了服务间依赖管理、分布式追踪、配置一致性等复杂性。AI编程助手在微服务场景中尤其能发挥作用——生成样板化的服务脚手架、编写契约测试、处理重复性的基础设施即代码(IaC)配置——但同时也意味着错误可以更快地在多个服务间扩散。因此,AI加持下的微服务团队对集成测试、服务边界设计和变更管理的要求不降反升。
给团队负责人的几点建议
面对这种"幸福的烦恼",与其被动等待产品团队派活,不如主动出击:
- 清理技术债:把过去无暇顾及的重构、测试覆盖率、依赖升级提上日程。
- 投资基础设施:完善CI/CD、监控告警、自动化运维,这些投入会持续放大团队产能。
- 重估流程:Sprint节奏、估算方法、协作方式都需要根据新的生产力水平重新设计。
- 强化把关能力:AI产出需要严格审查,建立代码质量门禁和安全扫描机制。
- 向业务靠拢:让开发团队更深入理解业务目标,主动参与需求定义,而非等待被喂需求。
这位Reddit用户遇到的情况,很可能是未来几年大量开发团队的共同写照。AI编程工具带来的不只是效率数字的变化,更是对软件开发组织形态、岗位定义和价值评估体系的一次深层重构。能否从容应对,取决于团队是把它当成威胁,还是当成重新定义自身价值的契机。
相关推荐

无GPU也能跑大模型?老旧DDR3服务器的本地推理性价比探讨
一场Reddit讨论探讨了无GPU本地部署大模型的可行性:用老旧DDR3多路服务器靠内存带宽跑Qwen 3.8 Flash,以及4bit量化、KV缓存与上下文长度的实用权衡与电费成本争议。

拓扑域外泛化:让AI预测系统从未见过的动力学突变
NeurIPS论文提出拓扑域外泛化方法,通过特征分离与物理稀疏先验修复分层DSR模型缺陷,使AI能在不知控制参数的情况下预测系统分岔与动力学突变,适用于PLRNN和Neural ODE。

用不好AI Agent是你的错吗?破解AI工具焦虑的实用指南
用不好AI Agent是你的能力问题吗?本文从产品成熟度、使用预期和场景匹配三个角度剖析AI工具使用困境,提供破解AI焦虑的实用方法与选型建议。