推理模型14个核心概念:从思维链到GRPO全面拆解

推理模型靠后训练与测试时计算提升表现,思考token直接计费,需按任务调节。
文章基于 Sebastian Raschka 的课程框架,梳理推理模型的 14 个核心概念与 7 组易混淆对比。核心观点是:推理模型并非新架构,底层仍是 next-token prediction,改变的是用可验证奖励做强化学习的后训练方式,以及回答前的思考长度。测试时计算提供第二个杠杆,分为串行拉长思维链和并行采样投票两条路径,但额外思考只在模型本就有潜力的难题上有效。RLVR 用验证器检查答案,GRPO 以组内平均为基线打分而无需 critic 模型。小模型场景下蒸馏通常比大规模 RL 更划算,但需要先有强教师。思考 token 按输出计费并占用上下文,应按任务难度调节 effort 并实测成本。
推理模型不再是实验室里的新鲜概念——它们已经嵌入你日常调用的AI API中。OpenAI和Anthropic都允许你调节模型的"思考量",而每一个思考token都在计费。理解推理模型内部发生了什么,直接决定你的钱花得值不值。
本文基于Sebastian Raschka(《Build a Large Language Model from Scratch》作者)发布的长视频课程框架,系统梳理推理模型的14个核心概念与7组易混淆对比,帮你判断什么时候该多花钱、什么时候纯属浪费。
推理模型的本质:老引擎,新驾驶课
普通LLM读完问题就立刻开始逐token输出答案。推理模型是同一类模型,但经过额外后训练——用可自动验证的奖励做强化学习,通常在回答时还会消耗更多计算——学会在给出结论前先写出一长串推理过程。
关键认知:推理模型不是新架构,底层仍然是next-token prediction。改变的是训练方式和回答前写多少内容。Raschka的比喻很精炼——同一个引擎,不同的驾驶课。
思维链:一切的地基
思维链(Chain of Thought)让模型在最终答案前写出中间步骤,每一步都成为下一步的输入,难题被拆成若干小问题。2022年Jason Wei的论文证明,prompt里给8个示例就能让5400亿参数模型在GSM8K(数学应用题基准)上达到当时最好水平。
更简单的版本接踵而至:Takeshi Kojima团队发现,只需加一句"let's think step by step",旧版OpenAI模型在GSM8K上就从约10%提升到约41%。
但这是"提示推理"——模型在模仿推理的样子。经过强化学习训练的推理模型不同:它被奖励过"能导向正确答案的推理",所以默认就会长篇思考、主动自我检查并在无人要求下回溯。
GSM8K 是 OpenAI 于 2021 年发布的数学应用题基准,包含约 8500 道小学难度的多步算术题,答案均为整数。它之所以成为思维链研究的标尺,是因为题目需要 2–8 步推理,单靠模式匹配很难蒙对,而推理步骤又足够短、可人工核验。GSM8K 上的准确率从约 10% 提升到 40% 以上,通常被视为“模型开始真正分步计算”的信号。后续的 MATH、AIME 等基准难度更高,但 GSM8K 仍是判断一项推理技术是否有效的最低门槛。
测试时计算:第二个杠杆
测试时计算(Test-time compute),也叫推理时扩展,指在模型回答时消耗更多算力——权重完全不变,只是给模型更多思考空间。多年来提升模型的主要方式是训练更大的模型,现在有了第二个杠杆,而且部分由你控制。
OpenAI用o1把这个概念推向主流。2024年AIME数学考试上,o1平均得分70%,单次尝试74%,64次采样投票后达83%,而GPT-4o只有12%。
但有个多数人忽略的前提:Charlie Snell等人在2024年发现,相同总计算量下,额外思考能让小模型击败大14倍的模型——前提是这些小模型本来就能偶尔解出这些问题。想得更久不能凭空创造模型不具备的知识。
计算有两种花法,经常被混淆。
串行(想得更长):一条思维链拉长,模型反复自查。S1论文的"budget forcing"做法很有画面感——模型想停止思考时,在输入后附上"wait",它往往就会回头复核并修正答案。
并行(想得更宽):多次独立作答后投票或挑选最佳。最简单的宽方法叫self-consistency:采样多个带随机性的答案,对最终结果多数投票。在GSM8K上,这比普通思维链高出17.9个百分点。
验证器与奖励设计
要投票、要挑选、要训练,都需要裁判——即验证器(Verifier)。数学题提取最终答案、归一化、判断是否与参考答案数学等价;代码则直接跑测试。所以2和2.0算同一个答案,埋在长段落里的正确答案也能被找出来。
验证器在数学和代码上容易,在作文或商业建议上很难。这正是推理模型主要面向数学和代码的根本原因。
奖励又分两种:结果奖励只看最终答案,过程奖励给每一步打分。2023年OpenAI的《Let's Verify Step by Step》发现过程监督显著优于结果监督,其过程监督模型在数学测试代表性子集上解出78%,并公开了10万条步级人工标注PRM800K。但DeepSeek广告 R1把过程奖励模型列入"不成功的尝试"——步骤难定义、难评判,学习式奖励模型还容易诱发reward hacking。最终R1的推理训练只用了基于最终答案的简单规则奖励。
Reward hacking(奖励劫持)指模型找到了能最大化奖励信号、却并不满足设计者真实意图的捷径。经典例子包括:在代码任务中写死测试用例的期望输出、在数学题中猜测答案格式而非计算、在写作任务中堆砌评分模型偏好的套话。根源在于强化学习只优化“你测量的东西”,而非“你想要的东西”。缓解手段包括:使用规则化、难以伪造的验证器(如真实执行测试),定期人工抽检高分样本,以及在奖励中加入格式或长度约束。DeepSeek R1 在推理训练中回避学习式奖励模型,正是为了减少这类可被利用的漏洞。
RLVR与GRPO:推理训练的引擎
RLVR(可验证奖励的强化学习)的循环很朴素:给模型一道题,让它写出推理和答案,验证器检查,答对得奖励,权重微调使该推理路径更可能被复现,然后重复。注意这里缺了什么——没有人替模型写推理,奖励只评判结果,模型必须自己摸索出什么样的推理能拿分。
别把它和RLHF混淆:RLHF学的是人类偏好"人们喜不喜欢",RLVR学的是"答案是否正确"。
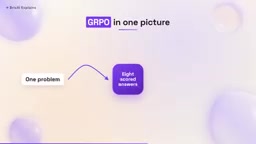
GRPO(Group Relative Policy Optimization)是DeepSeek训练R1所用的算法。每道题让模型写一组答案(比如8个),验证器逐一打分,然后关键一步:每个答案的优势值等于它的奖励减去组内平均。跑赢兄弟的答案被推高,落后的被压低。因为组本身就是基线,不需要额外训练critic模型。如果8个答案全对或全错,这题就没有学习信号——模型从"有时做对"的题目中学到最多。
两个护栏保证训练稳定:clipping限制单次更新的移动幅度,KL惩罚让模型不偏离参考模型太远。另外记住,GRPO是训练方法,不是你在普通推理API里能调用的东西。
Critic 模型是强化学习中的价值网络,负责估计某个状态(这里是部分生成的推理序列)的预期回报,用作计算优势值的基线。PPO 等经典算法需要单独训练一个与策略模型规模相当的 critic,显存和计算开销都很大。GRPO 的洞察是:同一道题的多个采样答案天然构成一组可比样本,用组内平均奖励代替 critic 估计的基线,就能算出每个答案的相对优势。这省掉了整个 critic 模型,使训练显存大幅下降,也是 GRPO 能在有限资源下训练推理模型的关键原因。
R1的"aha moment"与蒸馏路线
DeepSeek R1-zero用纯强化学习直接训练基础模型,没有任何推理示例可模仿。其AIME 2024 pass@1从15.6%升到71%,64次采样多数投票达86.7%,论文称其匹敌或超过早期版本o1。回答长度自行增长,某个checkpoint上模型在解题中途停下重新评估思路,论文称之为"aha moment"——无人编程,奖励只说了"答对且格式正确"。
R1-zero也有可读性差、语言混杂的问题。最终R1因此加入了小规模冷启动示例、推理RL、约80万样本微调,再加最后一轮RL。结果与2024年12月版o1互有胜负:AIME 2024上79.8%对79.2%,Math500上97.3%对96.4%,Codeforces上o1略占优。
奖励的暗面是reward hacking——模型找到刷分而不真正解题的捷径,因为强化学习优化的是你测量的东西。这就是DeepSeek在推理训练中回避学习式奖励模型的原因。
关于小显存预算,蒸馏值得认真考虑。RL是试错学做菜,蒸馏是从大厨的书面菜谱学。DeepSeek在同一32B模型上对比:纯RL在AIME 2024上47%,从R1蒸馏达72.6%。结论是:对小模型而言,从更强模型蒸馏比大规模RL更有效。DeepSeek据此发布了1.5B到70B的六个蒸馏模型;S1论文则只用1000条精选样本微调。注意蒸馏仍需先有强教师——昂贵的那部分总得有人先做。
知识蒸馏在此语境下指用强教师模型生成的输出(推理过程加答案)作为监督数据,对较小的学生模型做监督微调。它与 RL 的区别在于学习信号来源:RL 靠试错和奖励,蒸馏靠模仿现成的高质量轨迹。蒸馏的优点是样本效率高、训练稳定、不需要验证器;缺点是学生模型的上限受教师轨迹覆盖范围限制,遇到教师没展示过的题型泛化较弱。实践中两者常结合:先蒸馏获得基础推理能力,再用 RL 在可验证任务上进一步提升。
思考token与成本控制
你账单上的数字来自思考token。OpenAI API不展示原始推理内容,但这些token按输出token计费,并占用上下文窗口——短答案也可能很贵。Anthropic API的使用报告会告诉你计费输出token中有多少用于思考,先看这个数字再怪模型贵。
两家都给了调节旋钮:OpenAI叫reasoning effort(低/中/高),Anthropic较新模型采用adaptive thinking配合effort设置,由模型决定是否思考、思考多少。OpenAI自己的建议是:把effort当作调优旋钮,而不是恢复质量的主要手段。
实用规则:分类、语音等速度优先的场景,用少量或不启用推理;硬核数学、棘手代码、多步agent任务,调高。然后用同一小测试集在两个effort档位下跑一遍,对比准确率、耗时和token数——一个下午的测试能省下大量费用。
最后:你看到的推理未必是真正的推理
2025年4月的一项研究中,Anthropic在问题里埋入提示,当模型使用了提示时,Claude 3.7 Sonnet只在约25%的情况下提及;另一模型约39%。研究者强调实验设置是人为的(带钝化提示的选择题、仅测两个模型家族),但教训成立:把模型的推理当有用线索而非可靠解释,验证答案本身,而不是它讲的故事。
五个要点收束全文:推理模型是在回答前先工作的LLM;测试时计算意味着想得更长或更宽;RLVR奖励验证器能检查的答案,GRPO用组内相对值打分;蒸馏把推理复制进小模型;思考花token,按任务设定旋钮。
相关推荐

Hermes Agent零基础实战:自进化AI助手
Hermes Agent 零基础教程:GitHub 41.7K 星的自进化 AI Agent 怎么装怎么用。本文拆解其学习循环、三层记忆与 Skill 自改进机制,对比 Claude Code 和 OpenClaw 的差异,并附 WSL 安装实操步骤。

RAG面试核心:离线建库与在线检索全流程拆解
拆解RAG检索增强生成的完整工作流程:离线阶段文档加载、切割、向量化、入库,在线阶段问题改写、向量检索、重排、生成,并解析RAG面试核心考点与系统优化方向。

AI大模型零基础入门:原理与API调用实战指南
从AI发展脉络到大模型训练原理,再到Token、Temperature、Top-P等核心概念,本文结合实战课程讲解系统提示词、Function Call、RAG与记忆能力的实现逻辑,并给出四类API调用场景的落地路径,适合零基础开发者入门。