推理延迟的隐形成本:模型加载时间被你忽略了吗?

推理服务的真实延迟瓶颈往往在模型加载而非推理本身,首次请求可比热状态慢近10倍。
一位开发者在测试推理服务器时发现,同一模型的首次请求耗时13.9秒,热状态后仅需1.6秒,近10倍的差距揭示了「推理延迟」与「模型可用性延迟」这两个常被混淆的概念。模型从请求到就绪需经历权重下载、反序列化、预热、worker启动等多个阶段,每个环节都在消耗时间。文章进一步探讨了模型状态可观测性的重要性——明确暴露loading/loaded/available等状态,可让调度逻辑更智能而非靠猜测。针对生产环境,文章梳理了三种应对冷启动的策略:全部常驻(体验最佳但内存成本高)、按需加载(资源利用率高但首请求延迟大)、以及模型路由器加专用worker(折中方案但引入调度复杂度),并建议将「模型可用性延迟」作为独立指标纳入监控体系。
被忽视的推理成本:模型加载 vs 推理本身
当我们讨论推理服务的性能时,注意力往往集中在「推理延迟」上——模型处理一个请求需要多少毫秒。但一位 Reddit 开发者在测试推理服务器时发现,真正吃掉时间的,可能并不是推理本身,而是「把模型准备就绪」这个被长期低估的环节。
这位开发者在本地运行了 Superlinked 的 SIE(Superlinked Inference Engine),并刻意观察模型加载过程。结果颇具启发性:在 CPU 上测试 BAAI/bge-reranker-v2-m3 这个 reranker 模型时,第一次成功请求耗时约 13.9 秒,而紧随其后的相同请求仅需约 1.6 秒。这近 10 倍的差距,清晰地揭示了两个常被混为一谈的概念:推理延迟(inference latency)与模型可用性延迟(model availability latency)。
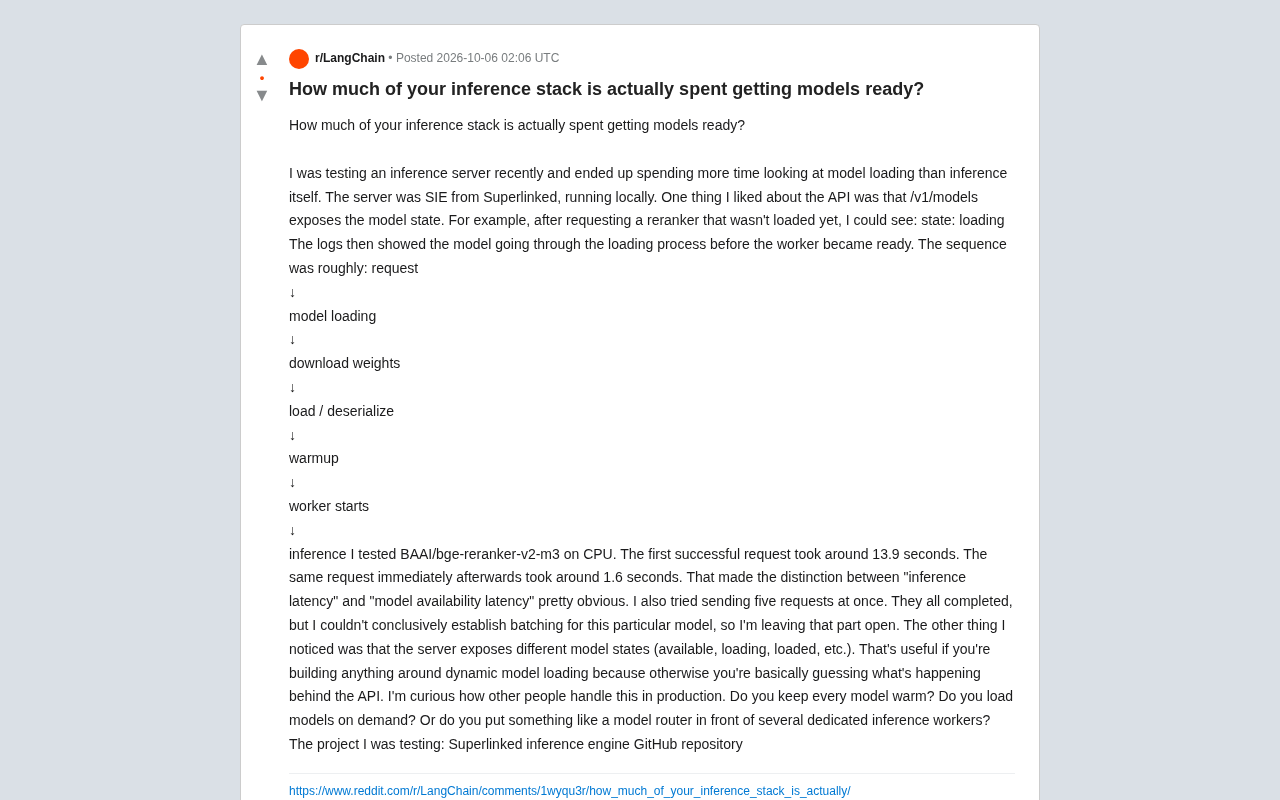
模型从请求到就绪的完整链路
大多数开发者把推理 API 当成黑盒:发请求、拿结果。但这台服务器通过 /v1/models 端点暴露了模型状态,让整个「准备」流程变得透明。当请求一个尚未加载的 reranker 时,API 会返回 state: loading,日志则显示模型正在走完一整套加载流程。
这个链路大致如下:
请求
 ↓
模型加载
 ↓
下载权重
 ↓
加载 / 反序列化
 ↓
预热(warmup)
 ↓
worker 启动
 ↓
推理
每一个环节都在消耗时间:权重下载受网络和存储影响,反序列化取决于模型体积与格式,而 warmup 阶段则要完成内存分配、算子初始化甚至首次计算图构建。这些加起来,就是那首次请求 13.9 秒的真正去向。而一旦模型进入「热」状态常驻内存,后续请求才回归到约 1.6 秒的真实推理成本。
**反序列化(Deserialization)**是加载链路中容易被忽略的耗时环节。模型权重通常以 SafeTensors、PyTorch .pt/.bin 或 GGUF 等格式存储在磁盘上,加载时需要将这些二进制数据解析并映射到 GPU/CPU 内存中的张量结构。对于参数量较大的模型,这一步本身就可能耗费数秒。SafeTensors 格式因采用零拷贝内存映射设计,相比传统 PyTorch pickle 格式反序列化速度更快且更安全,这也是近年来推理框架普遍迁移到该格式的原因之一。
**预热(Warmup)**阶段同样不可忽视。以 PyTorch 为例,首次推理时框架需要完成 CUDA 算子的 JIT 编译(或从缓存加载)、cuDNN 卷积算法的自动调优(auto-tuning),以及计算图的构建与优化。这些操作只在第一次执行时发生,后续请求可直接复用已编译的内核,这正是冷热请求延迟差距悬殊的底层原因。
模型状态可观测性的价值
这次测试中最值得关注的设计,是服务器把模型的不同状态(available、loading、loaded 等)显式暴露出来。这看似只是个小功能,但对任何构建动态模型加载系统的人来说意义重大。
如果 API 不告诉你模型当前处于什么状态,你本质上是在「猜」后台发生了什么——请求卡住是因为排队、下载、还是预热?无从判断。而有了状态可观测性,你可以据此设计更智能的调度逻辑:比如在模型 loading 时给客户端返回明确的等待提示,或者提前触发预加载来规避冷启动。
不过这位开发者也诚实地保留了一个未解问题:他尝试同时发送五个请求,虽然都成功完成,但无法确切验证该模型是否进行了批处理(batching)。这是一个需要进一步观察的开放项,提醒我们在评估推理引擎时,批处理能力同样是个不能靠想当然的变量。
生产环境中的三种应对策略
这个测试引出了一个在生产部署中非常现实的问题:如何平衡资源占用与冷启动延迟? 社区讨论中归纳出三种主流思路,各有取舍。
保持所有模型常驻(keep warm)
把每个可能用到的模型都加载在内存里保持热状态。好处是任何请求都没有冷启动延迟,体验最佳;代价是内存成本高昂,当模型数量多、体积大时几乎不可持续。
按需加载(load on demand)
只在请求到来时才加载模型。这种方式资源利用率最高,但会把那首次的「十几秒」直接甩给第一个用户——这正是本次测试中观察到的现象。它适合访问频率低、对首请求延迟不敏感的场景。
模型路由器 + 专用 worker
在多个专用推理 worker 前面放一层模型路由器(model router),根据请求把流量导向已加载对应模型的 worker。这是在延迟与成本之间折中的工程方案,也是许多成熟推理平台的做法,但它引入了额外的调度复杂度。
除了上述三种策略,业界还发展出了预测性预加载(Predictive Preloading)和模型量化两类补充手段。前者通过分析历史访问模式,在模型被实际请求之前提前触发加载,将冷启动成本从用户感知延迟中剥离出去;后者则通过将权重从 FP32/FP16 压缩到 INT8 或 INT4 精度,大幅缩小模型体积,从而同时降低下载时间、反序列化耗时以及内存占用,是在资源受限场景下兼顾加载速度与常驻成本的实用手段。在 Serverless 推理场景(如 AWS Lambda、Google Cloud Run)中,由于实例会被频繁回收与重建,冷启动问题尤为突出,通常需要将模型权重预先缓存到与计算节点同区域的对象存储或本地 SSD,以规避每次冷启动时的网络下载延迟。
对推理架构设计的启示
这次看似随意的本地测试,实际上触及了推理服务设计的一个核心命题:用户感知到的延迟,不等于模型的计算延迟。 冷启动、权重下载、反序列化、预热——这些「准备成本」在高频稳定场景下可以被摊薄到忽略不计,但在模型频繁切换、动态加载或 serverless 式部署中,它们会成为主导性能体验的关键因素。
对于正在搭建推理栈的团队,这里有几点可以直接落地:优先选择能暴露模型状态的推理引擎,让系统可观测而非靠猜;根据模型访问模式决定是常驻、按需还是路由;并把「模型可用性延迟」作为一个独立指标纳入监控,而不是笼统地记一个端到端延迟。
毕竟,当你的推理栈有相当一部分时间其实花在「让模型准备好」而非真正推理上时,优化的方向可能和你最初设想的完全不同。
相关推荐

Anthropic 官方揭秘:Opus 5.5 的 12 条提示词新规则
Anthropic 官方发布 Opus 5.5 提示词指南,涵盖 effort 默认档位、缓存保留、agents.md 支持、time matters 提速等 12 条实用技巧,帮你让 Claude 系统更快、成本更低。

用Claude Opus构建工具站:一个月上线130+工具并变现
本文详解如何用Claude Opus在一个月内构建并变现超过130个在线工具的网站,涵盖选题规划、框架搭建、AI代码生成、质量检查、规模化与AdSense联盟变现的完整步骤。

Claude Code Hooks完整教学:Event、Matcher、Handler三层架构详解
Claude Code Hooks完整教学,详解Event、Matcher、Handler三层架构。涵盖SessionStart、PreToolUse、PostToolUse、Stop等核心Event与五种Handler类型,附Git金钥检查、文章AI味检测实战案例及Codex差异说明。