推理专用NPU上从零预训练:VKORE-46M-NPU实现反向传播

VIDRAFT在推理专用NPU上完成反向传播,从零训练出与GPU损失曲线相关系数达0.99的46M模型。
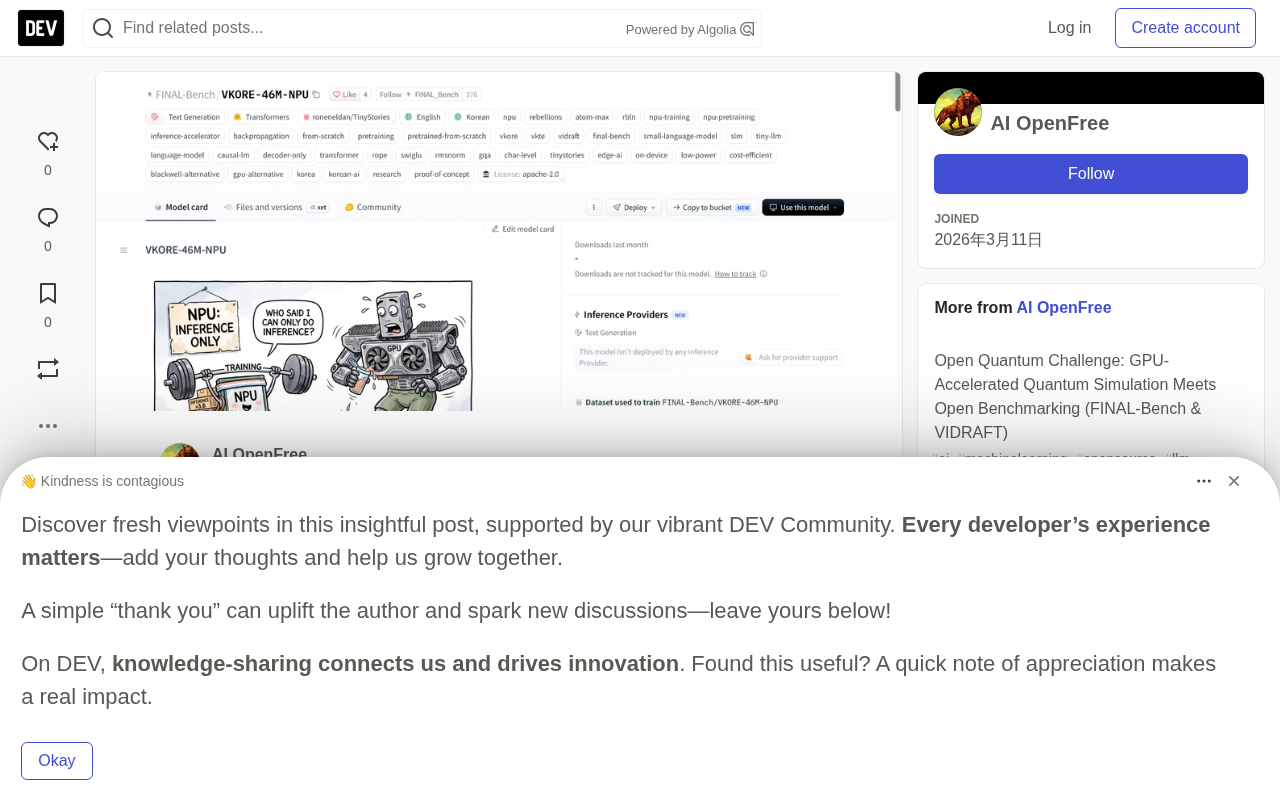
VIDRAFT打破了「推理NPU无法训练」的行业默认认知,在一款第一代推理专用NPU上用32颗芯片完成了完整的反向传播,从零预训练出46M参数语言模型VKORE-46M-NPU。研究的关键证据在于:在相同初始化、数据和学习率条件下,NPU与GPU的损失曲线相关系数达0.99,吞吐量也收敛到可比水平,证明训练在数值上等价于GPU参考而非仅仅「看起来在训练」。同一套NPU方案还覆盖LoRA微调、推理加速和量化执行,公司正将其整合为定位类似CUDA的VKORE软件层。模型已在Hugging Face发布,但核心训练技术专利待审、代码未开源,独立复现目前尚不可行。
推理专用NPU通常被认为只能做前向计算——静态图、低精度、权重固定,训练所需的计算图、梯度同步和优化器状态在其软件栈中根本不存在。VIDRAFT用实际工作打破了这一默认认知:他们在一款推理专用NPU上完成了完整的反向传播,从零预训练了一个语言模型,并将结果发布为VKORE-46M-NPU。
为什么在推理NPU上训练如此困难
推理NPU的设计目标与前向路径完全对齐:静态计算图、低精度运算、权重作为常量固化在硬件中。而训练需要的是几乎相反的一套能力——带激活保存的反向图、优化器状态管理、小梯度下的数值稳定性,以及多芯片间的梯度同步。这些路径在推理软件栈中通常并不存在。
正因如此,「NPU做不了反向传播,所以无法训练」长期被视为行业默认结论。VIDRAFT的工作直接在这类芯片上运行反向传播,在没有预训练权重的情况下从零开始训练模型,用工程实现回应了这一判断。
反向传播(Backpropagation) 是训练神经网络的核心算法,其本质是链式法则在计算图上的反向应用:前向传播时逐层计算并保存中间激活值,反向时从损失函数出发,逐层计算损失对各参数的梯度,再交由优化器更新权重。与推理只需一次前向不同,训练需要保存整个前向过程的激活、构建反向计算图、维护动量与方差等优化器状态,显存/片上存储占用通常是推理的数倍。
低精度训练 则进一步放大了难度。推理常用的 FP16、INT8 甚至 INT4 已经足够,但反向传播中梯度值往往极小,在低精度下容易出现下溢(underflow)或被舍入噪声淹没,导致参数无法有效更新。因此低精度训练通常需要损失缩放(loss scaling)、FP32 主权重副本或随机舍入等技巧来维持数值稳定性。推理 NPU 的软件栈通常不提供这些机制,这正是「NPU 做不了反向传播」这一判断的技术根源。
核心证据:同一模型,两种硬件
这项工作中最具说服力的部分在于方法设计。研究团队在完全相同的初始化、数据和学习率调度条件下,分别在32芯片NPU和GPU上从零训练了同一个模型。
- 两条损失曲线的相关系数达到0.99
- 吞吐量(每秒token数)收敛到可比水平
单条下降的损失曲线本身并不能证明什么。如果低精度内核对梯度造成破坏,曲线会逐渐偏离GPU参考运行。在相同条件下与GPU参考达到0.99的相关系数,是反向传播和优化器更新在数值层面完成了与参考实现相同工作的强有力证据。换句话说,这不是「看起来在训练」,而是「数值上等价于GPU训练」。
这也是多源信息中反复确认的核心事实:NPU上的训练路径在数学意义上走通了。
皮尔逊相关系数(Pearson correlation coefficient) 是衡量两条曲线线性相关程度的指标,取值范围为 -1 到 1,1 表示完全正相关。在训练对比实验中,它被用来量化 NPU 与 GPU 两条损失曲线在形状上的贴合程度。
选择相关系数而非简单地比较最终损失值,是因为它能捕捉训练全程的动态一致性。如果低精度内核在某一阶段对梯度造成了系统性破坏,损失曲线会在该阶段出现偏离,相关系数随之下降。0.99 意味着两条曲线几乎同步下降、同步收敛,说明 NPU 上的每一步参数更新在方向和幅度上都与 GPU 参考高度一致。这比单一终点指标更能证明训练过程的数值有效性。
旧芯片跑通,新芯片空间更大
这套训练跑在一款2025年发布的第一代推理专用NPU上,使用32颗芯片完成,并非最新硬件。旧一代芯片能够完成从零预训练,意味着新一代NPU在算力、精度和互联带宽上都有明确的提升空间。
对硬件厂商和模型团队来说,这个信号比「新芯片能做到」更有价值——它说明训练能力并非依赖最新制程或专用训练单元,而是软件栈层面的工程问题。
一颗NPU覆盖全流程
VIDRAFT的工作不止于预训练。同一套NPU方案已经覆盖了模型生命周期的多个环节:
- 从零预训练
- LoRA微调
- 推理加速(在通用开源模型上同样得到验证)
- 量化模型执行与加速
公司正在将这些能力整合为一个名为VKORE的NPU软件层。其定位类似于Nvidia通过CUDA构建的生态优势——不是依靠单一GPU硬件,而是通过通用加速层降低对特定GPU及其软件生态的依赖。VIDRAFT将其描述为「NPU的CUDA」。
这一策略的深层逻辑在于:硬件的可替代性取决于软件栈的粘性。如果训练和推理都能跑在同一套通用NPU软件层上,企业选择硬件时的迁移成本将显著降低。
CUDA(Compute Unified Device Architecture) 是英伟达自 2007 年起构建的通用并行计算平台与编程模型。它的意义远超一套工具链:通过统一的编程接口、丰富的算子库(cuBLAS、cuDNN)和成熟的开发者生态,CUDA 让开发者一旦基于它编写代码,就极难迁移到其他硬件,从而形成强大的生态锁定。英伟达的护城河很大程度上正来自 CUDA 而非单纯的芯片性能。
「NPU 的 CUDA」 这一提法,指向的是同一种策略逻辑:如果存在一套通用加速层,让训练、微调、推理、量化都能运行在同一软件栈上,那么企业在选型时对特定硬件(尤其是英伟达 GPU)的依赖就会降低,迁移成本随之下降。对后来者而言,软件生态的通用性比单点硬件性能更能决定硬件的可替代性。
为什么这件事值得关注
高端GPU服务器价格昂贵、交付周期长、功耗高。一颗更便宜、低功耗且能同时承担训练任务的NPU,让企业可以在本地自主扩展模型——像在办公室装一台桌面设备一样部署,不必等待GPU交付,也不必把敏感数据送出本地。
发布的模型使用公开数据集训练,能够生成简短的英文故事。核心训练技术为专有方案,正在申请专利,细节将在后续论文中公布;核心训练代码出于知识产权保护暂未开源。
需要客观看待的是,46M参数模型的规模很小,其意义在于验证NPU训练路径可行,而非模型本身的质量。据VIDRAFT透露,扩展到更大模型和真实数据是下一步计划。单一来源指出核心训练技术尚未公开,这意味着独立复现目前还无法完成。
LoRA(Low-Rank Adaptation,低秩适配) 是一种参数高效微调方法。它在预训练模型的权重矩阵旁引入一对小规模的低秩矩阵,训练时只更新这部分新增参数,冻结原始权重。由于可训练参数量通常只有原模型的千分之一到百分之一,LoRA 大幅降低了微调的显存与算力需求,同时便于为不同任务保存多个轻量适配器。
量化模型执行 指将模型权重和/或激活从 FP16、FP32 等高精度格式压缩为 INT8、INT4 等低比特表示,以减小存储占用、提升推理吞吐并降低功耗,代价通常是轻微的精度损失。
46M 参数 的规模值得放在参照系中理解:GPT-2 Small 约 1.24 亿参数,46M 约为其三分之一,远小于当前主流大模型。这一规模的意义在于以最小成本验证「NPU 能否走通完整训练路径」,而非追求模型能力。VIDRAFT 将扩展到更大模型和真实数据列为下一步计划,正是从可行性验证迈向实用性的自然路径。
常见问题
反向传播真的跑在推理专用NPU上了吗? 是的。反向传播直接运行在一款为推理设计的芯片上,完成了从零预训练。
0.99的相关系数意味着什么? NPU的损失曲线与相同条件下的GPU参考几乎重合,证明训练在数值上是有效的。
模型有多大? 46M参数。重点在于验证NPU训练路径可行,而非模型质量。扩展到更大模型和真实数据是下一步。
模型在哪里可以获取? 已发布在Hugging Face:FINAL-Bench/VKORE-46M-NPU,包含权重、模型卡和对比数据。
相关推荐

AGENTS.md 实战指南:让编程 Agent 真正好用
AGENTS.md 和 CLAUDE.md 能显著提升编程 Agent 表现,但研究发现用错反而让成本上升 20%。本文详解该写什么、该删什么、200 行与 32KB 的硬边界、Monorepo 嵌套规则及安全提醒。

花旗AI编程代理Devon:年省30%技术外包费,1.4万工程师已使用
花旗集团利用AI编程代理Devon,一年内削减30%技术供应商费用,1.4万工程师使用,产品发布提速30%-40%。本文分析其对IT外包行业的冲击及未来人机协作模式。

从生日派对到千亿AI帝国:新一代PayPal黑帮崛起
2015年一张生日派对合影,十年后催生Scale AI、Cognition AI等千亿估值AI公司。解析新一代PayPal黑帮的创业路径、互相投资生态,以及Peter Thiel的Founders Fund如何完成代际传承。