推理专用NPU也能训练Transformer:VKORE实现0.9999精度对齐

VIDRAFT的VKORE软件层让推理专用NPU同时实现数倍推理提速与LoRA训练。
VIDRAFT推出硬件无关的软件加速层VKORE,在不改动NPU芯片的前提下,既将推理性能大幅提升,又让Transformer的LoRA训练在被称为"推理专用"的NPU上跑通。实测显示,Gemma 4 26B在韩国8卡NPU服务器上单用户响应从14.1提升到53.9 tokens/s,服务器吞吐从214提升到881 tokens/s,64并发下零失败且每token稳定29ms。LoRA训练与PyTorch达到0.9999精度对齐,速度约为同机CPU的170倍、单张B200吞吐的54%,而价格相当。结合ZTC决策引擎的零token判断特性与"夜班循环"模式,数据中心可白天推理、夜间用同一批NPU训练,形成自我进化闭环。
NPU长期被业界定位为"推理专用"加速器,训练任务默认交给GPU。VIDRAFT推出的VKORE软件加速层挑战了这一分工——在不改动芯片的前提下,既将NPU推理性能提升数倍,又让Transformer的LoRA训练在这类"推理专用"硬件上跑通,数值精度与标准PyTorch达到0.9999对齐。
为什么要在NPU上做训练
数据中心的经济账正在发生变化。过去的思路是"买更多GPU",现在则转向"用同样的功耗和同样的芯片榨取更多智能"。NPU在推理场景的能效优势明显,因此在推理集群中快速铺开。但行业普遍将其视为只能推理的硬件,训练则被认为是GPU的专属领地。
VKORE要打破的正是这道分界线。如果NPU也能承担训练任务,运营方就不必为了微调单独搭建一套GPU集群。VIDRAFT的思路很直接:既然推理集群已经存在,为什么不让它在下班时间也干活?
NPU与GPU的架构差异
NPU(神经网络处理单元)是专为神经网络张量运算设计的专用集成电路,典型代表包括Google TPU、华为昇腾、苹果Neural Engine等。与GPU相比,NPU通常牺牲通用可编程性,换取更高的每瓦算力:它内置大规模脉动阵列(systolic array)或类似结构,能以极低功耗完成矩阵乘加,但缺乏灵活的指令调度与动态分支能力,也不像GPU那样拥有成熟的CUDA生态、大容量显存与高速互联(如NVLink)。正因如此,NPU在推理——尤其是固定shape、低精度量化的前向计算——上效率突出,而在需要反向传播、梯度累积、优化器状态维护的训练任务上,长期被认为"力不从心"。VKORE的意义在于,它试图用软件层弥补NPU在可编程性上的短板,而非等待硬件本身进化。
同一块NPU上的推理提速实测
测试平台是一台韩国NPU服务器(8张卡),模型为Google开源的Gemma 4 26B。硬件没有任何改动,只替换了软件层。
- 单用户响应:从14.1 tokens/s提升到53.9 tokens/s,约3.8倍。
- 服务器吞吐:从214 tokens/s提升到881 tokens/s,约4.1倍。
- 在64并发用户的过载场景下,每token生成时间稳定在29ms,零失败请求。
最后一点对运维方意义不小:当需求超过容量时,每个用户仍然感受到稳定的速度,这让服务等级承诺更容易兑现。有意思的是,这些提升并非来自硬件升级,而是纯粹通过软件加速层实现——这意味着已部署的NPU集群可以立即受益。
推理专用NPU真的能训练吗
答案是肯定的。VIDRAFT在一台服务器的全部32颗芯片上,对标准Transformer块(注意力层加前馈网络)进行了LoRA训练,结果如下:
- 精度:与标准PyTorch训练达到0.9999的一致性。
- 速度:约为同一台服务器CPU的170倍。
- 对比单张NVIDIA B200:约为其训练吞吐的54%,而硬件价格相当。
LoRA的做法是在已有模型上附加一个小的修正层,针对特定任务进行调优,这是企业实践中最常见的训练方式。让LoRA在NPU上正确运行,意味着推理集群可以在低峰时段做微调,而不是闲置。从成本角度看,一台已经为推理采购的NPU服务器,如果还能承担训练任务,其投资回报率会有明显改善。
LoRA与训练精度的0.9999对齐意味着什么
LoRA(Low-Rank Adaptation,低秩适配)是一种参数高效微调方法:它冻结预训练模型的主权重,只在每个Transformer层旁挂一对低秩矩阵(A和B),训练时仅更新这小部分参数,从而将显存与算力需求降低数个量级。文中"0.9999一致性"指的是NPU训练出的LoRA权重与标准PyTorch在同数据、同超参下训练出的权重之间的数值相关系数或余弦相似度,而非模型最终任务的准确率。0.9999是一个非常高的对齐水平,说明NPU在反向传播、梯度计算、混合精度累加等环节没有引入显著误差。不过需要注意,对齐的是LoRA这一小规模适配层,并不等同于全参数预训练也能达到同等精度——全量训练对数值稳定性和显存带宽的要求会苛刻得多。
ZTC决策引擎与NPU的天然匹配
决策引擎返回的是判断结果,而非生成的文本。VIDRAFT的Darwin ZTC在单次前向传播中完成判断,输出token数为零。这意味着大量短小、确定性的计算,而不是逐token的长序列生成——这种计算模式恰好契合高能效的NPU。
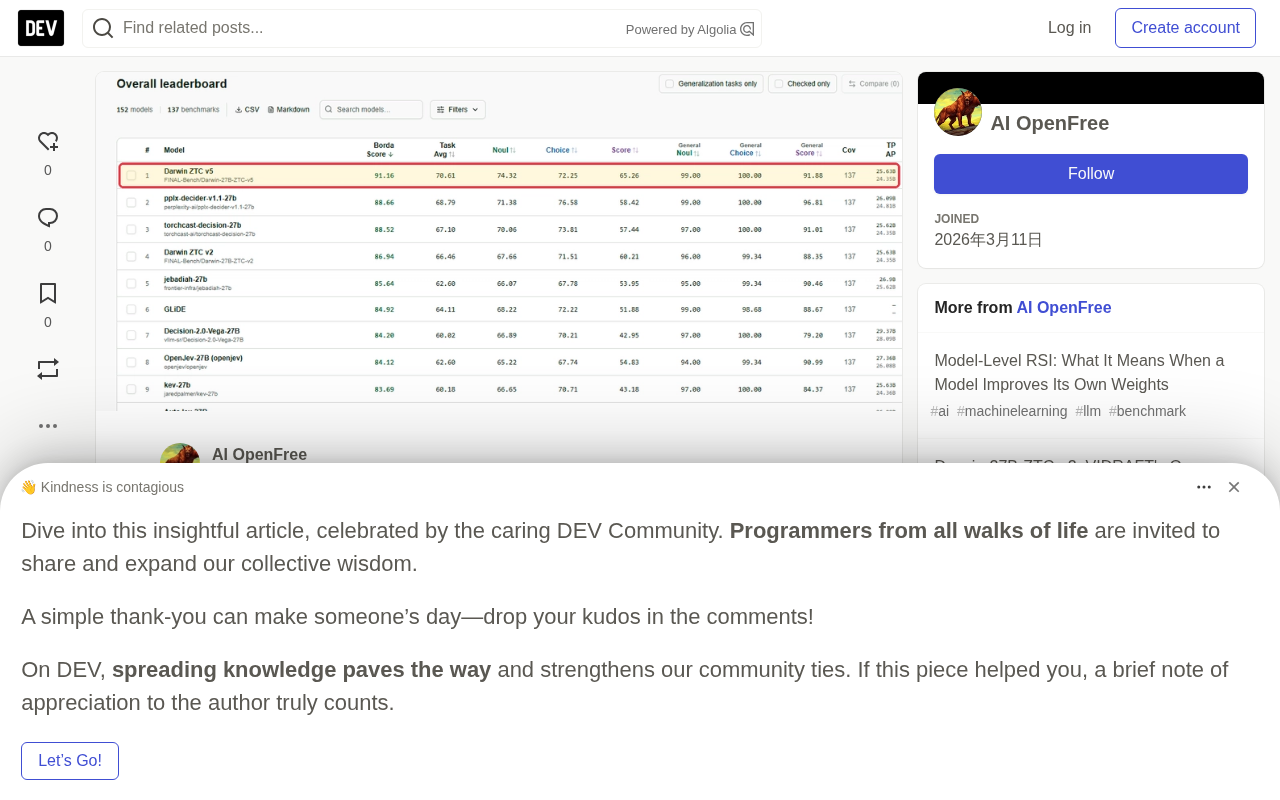
在S1MB公开排行榜上,Darwin-27B-ZTC-v5在152个模型中排名第一。将顶级决策引擎部署在NPU上,能让同样的电力预算服务更多判断请求。换句话说,NPU的能效优势在这个场景下被进一步放大。
什么是"零输出token"的决策引擎
传统大模型推理是自回归的:每生成一个token都要完成一次完整前向传播,并把它追加到上下文里再算下一个,序列越长开销越大。ZTC(Zero-Token Classification,推测命名)决策引擎则只在单次前向传播后直接读取某个汇聚向量(如最后一层的[CLS]表示或池化输出),输出一个分类判断,不产生任何文本token。这使它属于判别式模型而非生成式模型,计算量恒定、延迟可预测,非常适合风控、路由、内容审核等"给个结论就行"的场景。正因为它不需要KV Cache、不需要逐token解码,NPU的能效优势得以完全释放,不会被解码阶段的内存带宽瓶颈拖累。
夜班循环:一个数据中心的自我进化闭环
把上述能力拼在一起,一个数据中心可以跑起这样的循环:
- 白天服务推理请求。
- 由决策引擎对当天流量打分,挑选值得学习的数据。
- 夜间让同一批NPU执行训练。
决策引擎负责选数据,自我改进负责训练模型,加速层负责让这一切在NPU上运行。VIDRAFT表示该方法已申请专利,内部细节暂不公开,结果将以论文形式发布。
硬件无关设计
VKORE被定位为硬件无关的软件层,面向混合部署GPU和NPU的数据中心。它不绑定特定芯片厂商,这为运维方在采购和调度上保留了灵活性。对于已经在推理集群上投入大量资金的企业来说,这种不挑硬件的加速层降低了尝试门槛。
不过,目前公开的实测数据来自单一配置——韩国NPU服务器的8卡(32芯片)方案,模型为Gemma 4 26B。VIDRAFT计划发布完整的测量方法论论文,届时可以验证这些结果在其他硬件组合上的可复现性。
硬件无关层如何做到——以及它的边界
所谓"硬件无关"软件层,通常通过中间表示(IR)加分发式后端实现:上层用统一的计算图描述模型,下层针对不同芯片生成对应的kernel或调用厂商运行时(如CUDA、CANN、各种NPU SDK)。这样做能让同一套代码在GPU和NPU上运行,但也存在边界:不同硬件支持的算子集、数值精度(FP16/BF16/INT8)与内存布局各异,某些优化可能只在特定架构上生效,因此"硬件无关"更多指接口与部署流程的统一,而非性能完全可移植。文中实测仅覆盖单一配置,也正说明跨硬件的性能一致性仍需更多独立验证。
常见问题
VKORE是否绑定某一芯片厂商? 不绑定,它被设计为硬件无关层,面向混合GPU和NPU的数据中心。
在NPU上训练会损失精度吗? 实测中,LoRA训练与标准PyTorch达到0.9999的一致性。
使用了什么模型和硬件? Google开源的Gemma 4 26B,运行在韩国NPU服务器上,8张卡共32颗芯片。
与B200相比成本如何? NPU服务器达到单张B200训练吞吐的约54%,硬件价格相当,同时也是已经为推理采购的集群。
在哪里可以看到更多信息? VIDRAFT计划以论文形式发布测量方法论。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。