Twigg:让LLM上下文管理自动化的有状态API
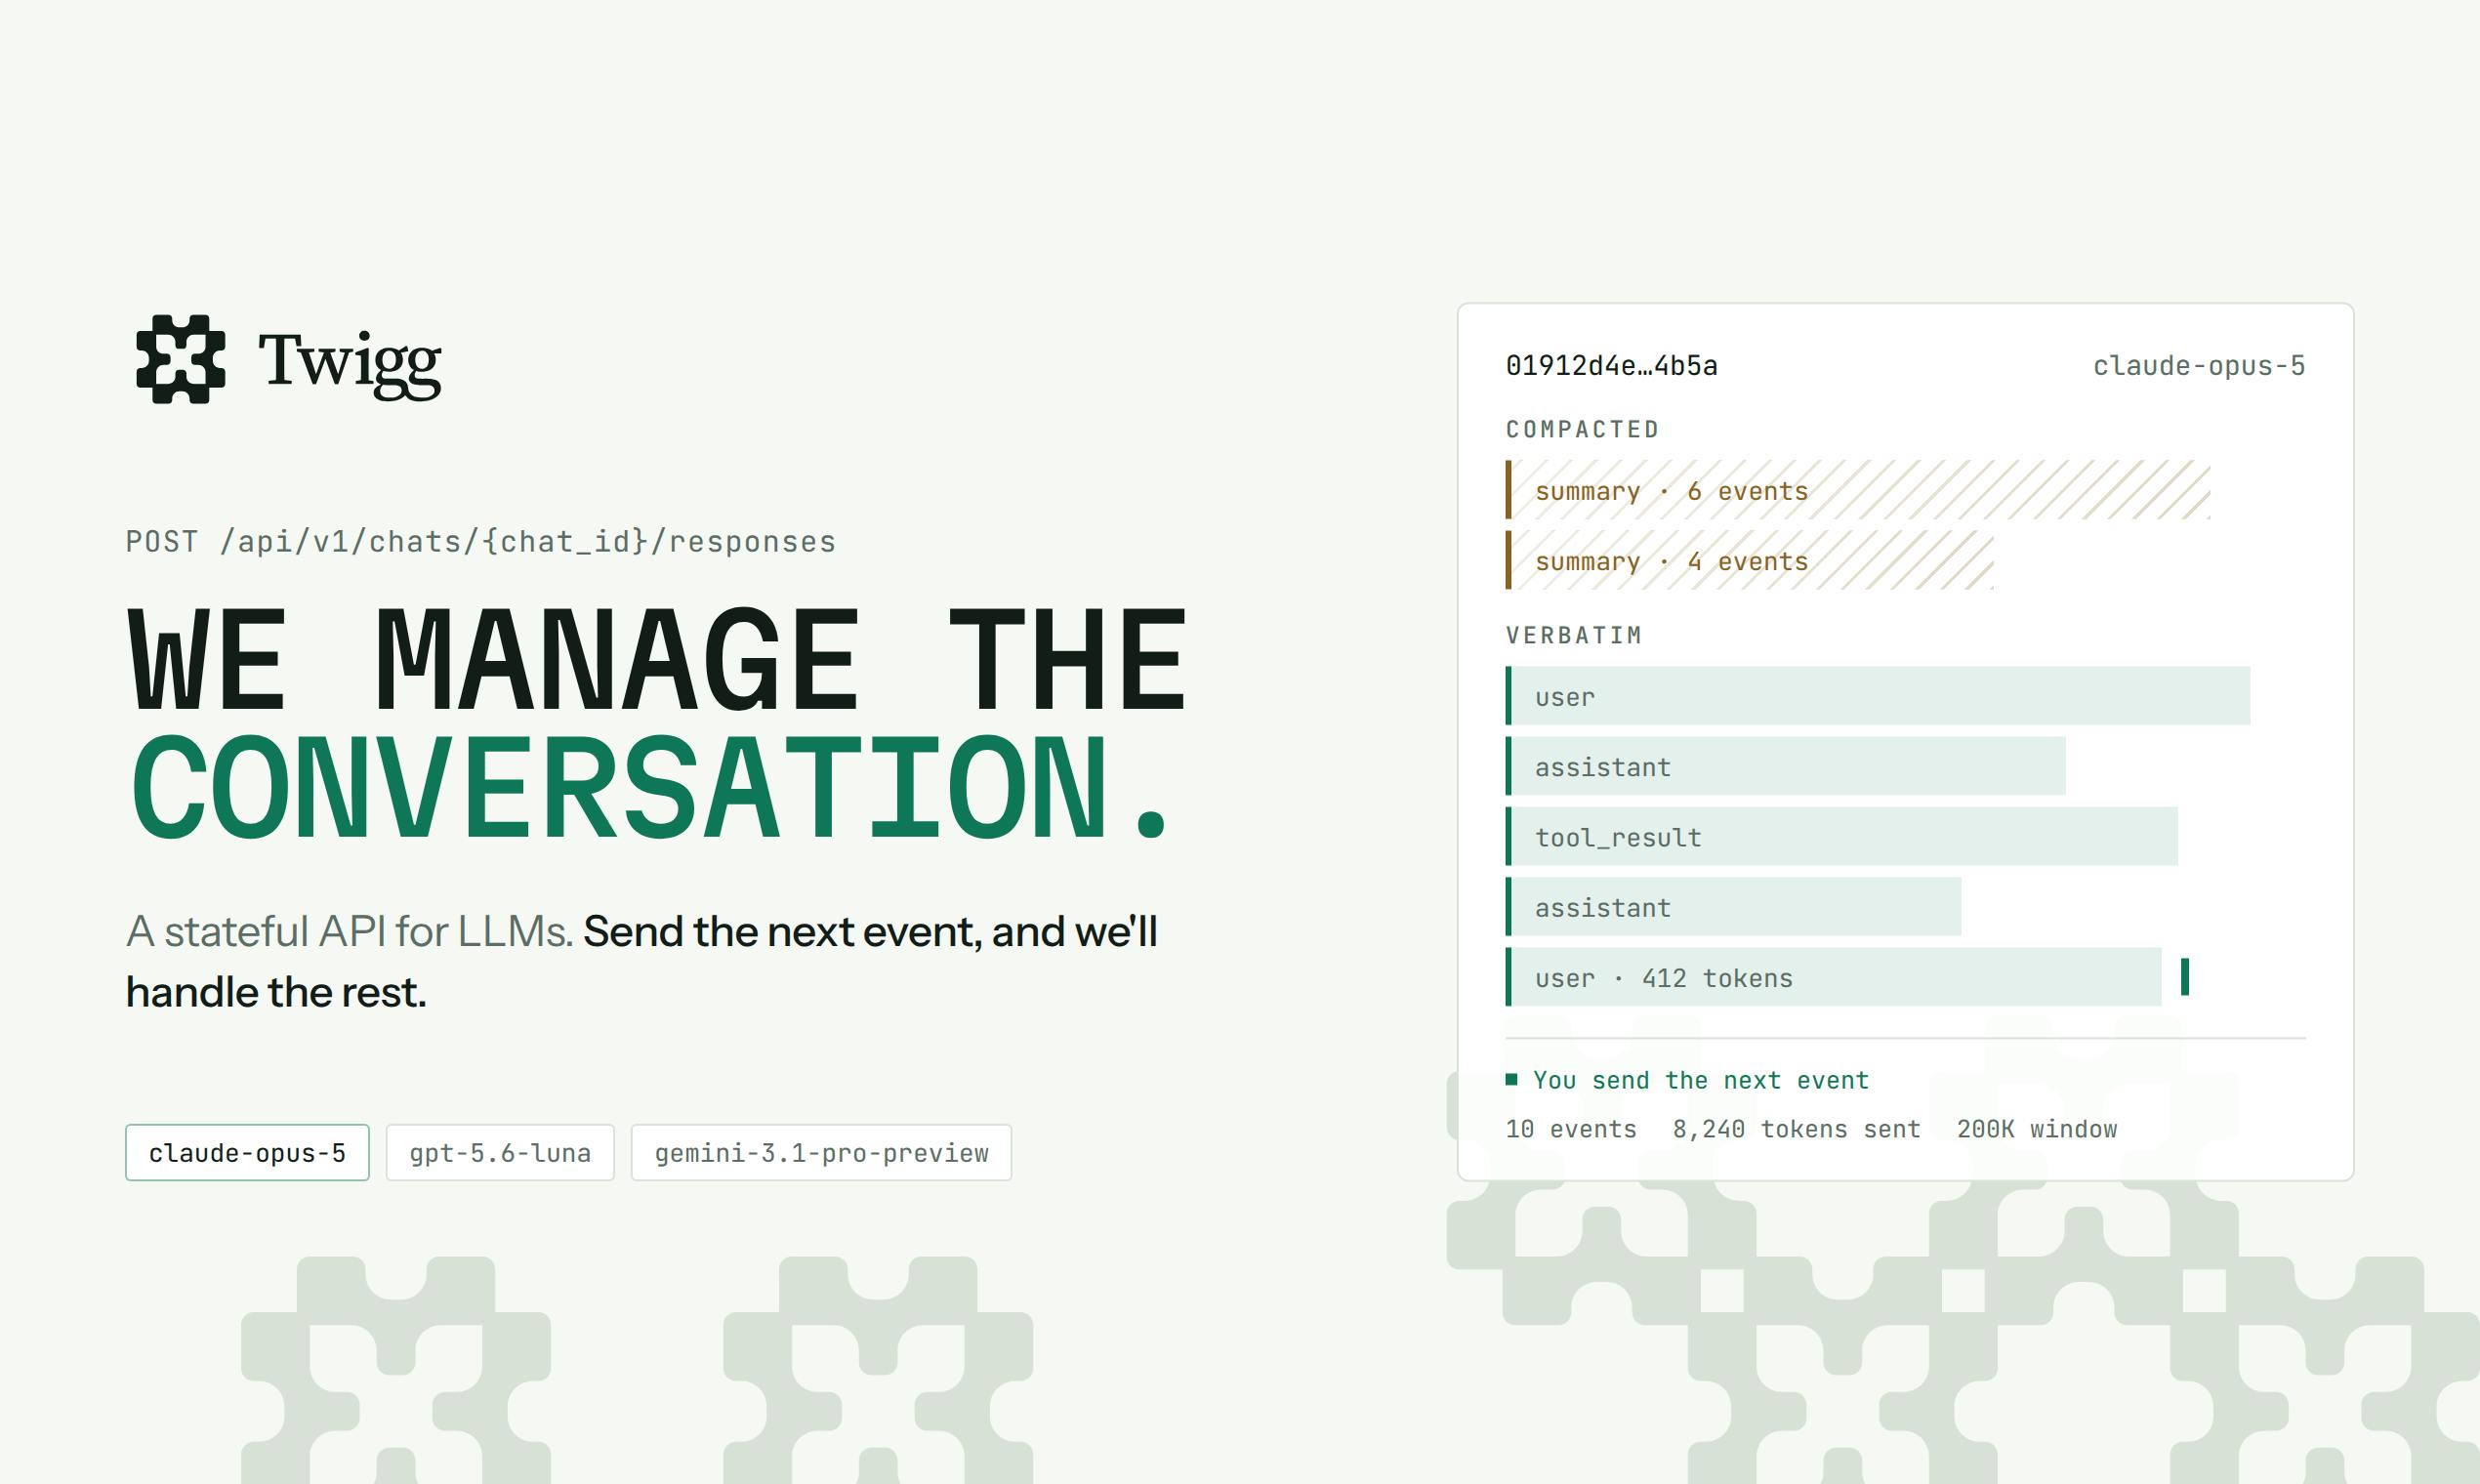
Twigg 是一个有状态的 LLM 调用 API,将上下文维护、模型适配与压缩截断全部托管到服务端。
Twigg 是一款面向开发者的有状态 LLM 调用 API,核心价值在于将上下文管理从客户端彻底剥离。传统 LLM 应用开发中,开发者需要在每次请求时手动拼接完整对话历史,并自行处理上下文超长、多模型格式差异等问题。Twigg 让开发者只需创建一次会话后发送增量事件,服务端自动完成模型 schema 适配、上下文压缩/截断和调用路由。配套的仪表盘支持集中管理工具定义、系统提示和用量账单。产品定位为从个人智能体到企业级应用的通用上下文基础设施层,但托管上下文带来的第三方依赖与数据风险是企业评估时的重要考量。
在构建大语言模型(LLM)应用时,开发者最头疼的问题之一就是上下文管理。每次调用模型都要重新拼接、重发整段对话历史,不仅代码冗长,还要手动处理上下文超长、模型格式适配等一系列繁琐工作。Product Hunt 新上榜的开发者工具 Twigg 试图从根本上解决这个痛点——它主打「你永远不必自己构建的上下文层」。
Twigg 是什么
Twigg 是一个有状态(stateful)的 LLM 调用 API。它与常见的无状态调用方式最大的区别在于:传统做法是每次请求都把完整的会话历史打包发给模型,而 Twigg 让你只需创建一次聊天会话,之后每次只发送「下一条事件」,剩下的状态维护全部交给它来处理。
换句话说,Twigg 把「记住上下文」这件事变成了服务端的职责。开发者不再需要在客户端反复组装 prompt,也不用为超出上下文窗口而写各种截断逻辑。这个思路瞄准的是 LLM 应用开发中一块高频、重复、又容易出错的基础设施工作。
该产品目前在 Product Hunt 上获得 86 个赞、3 条评论,排名当日第 9 位,归类于 API、开发者工具与人工智能三个类别,由 Louis Ellis 等人打造。
核心能力拆解
Twigg 把上下文管理拆成了几个自动化环节,值得逐一来看。
自动适配模型 Schema
不同的目标模型有各自的输入格式与结构要求。Twigg 会自动将上下文「适配到目标模型的 schema」,这意味着切换底层模型时,开发者不需要重写数据组装逻辑。对于需要在多个模型间灵活切换、或做 A/B 对比的团队来说,这能省下不少适配成本。
不同 LLM 提供商对输入格式的要求存在显著差异。以函数调用(function calling)为例,OpenAI 使用 tools 字段传入 JSON Schema,Anthropic Claude 使用 tools 但结构略有不同,Google Gemini 则采用 functionDeclarations 格式。消息角色的命名(如 assistant vs model)、系统提示的位置、多轮对话的拼接方式也各有出入。开发者若要同时支持多个模型或做模型迁移,往往需要为每个提供商单独维护一套数据转换逻辑。Twigg 的 schema 自动适配层本质上是在做这层「格式归一化」工作,将上游应用与具体模型 API 的差异隔离开来。
智能压缩与截断
当对话变长、逼近甚至超过上下文窗口时,Twigg 会自动进行压缩(compact)或截断(truncate)。这是实际生产环境中极常见的问题——长对话会导致成本飙升甚至请求失败。把这套策略交给服务端统一处理,比每个应用各自实现要可靠得多。
上下文窗口(context window)是大语言模型一次能处理的最大 token 数量,不同模型从几千到数十万 token 不等。当对话历史超出这一上限时,请求会直接报错或被模型截断,导致模型「失忆」。常见的应对策略包括:滑动窗口(只保留最近 N 条消息)、摘要压缩(用模型对历史对话生成摘要后替换原文)、以及语义检索(只把与当前问题最相关的历史片段放入上下文)。每种策略都有各自的精度损失与延迟代价,且需要针对具体场景调优。这正是各团队反复重造轮子的根源——Twigg 试图把这些策略的选择与执行权统一收归服务端,让开发者无需关心具体实现。
调用路由
Twigg 还负责「路由调用(route the call)」,即把请求分发到合适的模型端点。结合前面的 schema 适配能力,路由让多模型架构的落地变得更简单。
面向开发者的控制面板
除了 API 层的自动化,Twigg 提供了一个仪表盘(dashboard),让开发者可以集中管理若干关键配置:
- 工具 Schema(tool schemas):定义模型可调用的工具接口
- 系统提示词(system prompts):统一维护应用的角色与行为设定
- 上下文窗口(context windows):控制上下文长度策略
- 用量与账单(usage and billing):追踪调用消耗与成本
把这些配置从代码里抽离到面板上管理,好处是显而易见的:调整系统提示或工具定义不必重新部署代码,运营和产品人员也能更直观地掌握用量成本。
适用场景与定位
按照官方描述,Twigg 的适用范围从「个人智能体(personal agents)」一直延伸到「企业级应用(enterprise apps)」。这个跨度说明它把自己定位为一个通用的基础设施层,而非针对某一垂直场景的工具。
对独立开发者而言,Twigg 能让搭建一个带记忆的对话机器人变得轻量;对企业团队而言,统一的上下文层、集中的配置管理和用量追踪,则有助于治理和成本控制。核心卖点始终如一:「你再也不用管理上下文」。
简单点评
上下文管理确实是 LLM 应用开发中一块被反复重造的轮子,Twigg 将其抽象为托管服务的方向是合理的。有状态 API 的模式与 OpenAI 近期推出的部分会话状态功能思路相近,但 Twigg 强调的多模型 schema 适配与集中式面板,是其试图建立的差异化。
需要留意的是,把上下文状态托管给第三方,意味着要接受额外的服务依赖、数据流转与潜在的锁定风险。对数据敏感的企业应用,这些都是评估时无法回避的因素。目前公开信息主要来自 Product Hunt 的产品介绍,具体的压缩算法效果、延迟表现和定价细节还有待实际上手验证。
对于正被上下文拼接逻辑困扰的开发者,Twigg 至少提供了一个值得关注的新选项。
OpenAI 在 2025 年推出的 Responses API 中引入了服务端会话状态(store: true)功能,允许通过 previous_response_id 串联多轮对话,无需客户端重传历史。这与 Twigg 的核心思路高度吻合,也印证了「有状态 LLM 调用」正在成为行业关注方向。两者的主要区别在于:OpenAI 方案仅限自家模型生态,而 Twigg 强调跨模型的通用性。对于已深度绑定单一提供商的团队,原生状态 API 的可信度与集成成本可能更有优势;对需要多模型灵活调度的场景,独立的上下文层则更具吸引力。
相关推荐
AI Agent实战入门:从大模型演进看智能体的价值与落地
从原生大模型、提示工程、RAG到AI Agent智能体,系统梳理大模型商业落地的四个阶段,解析Agent的翻译官、工具达人、记忆管家、任务管家四大核心能力,并给出企业级Agent入门的三个实战项目路线。
AI Agent智能体系统学习路径拆解:从原理到实战的完整框架
AI Agent智能体系统学习路径拆解:从Agent原理、Prompt工程、RAG知识库到多Agent协作与工具调用,再到个人知识库助手、智能客服等实战项目,帮零基础学习者打通从入门到落地的完整链条。
AI Agent智能体入门:大脑、记忆与工具三要素详解
从零理解AI Agent智能体:详解大脑、记忆、工具三大核心组件,梳理大模型从原生模型、提示工程、RAG到Agent的四阶段演进,帮你搞懂Agent到底解决了什么问题以及为何值得学习。