Twindex:为ODE/PDE/PINN参数拟合提供精确可验证的“孪生”证明
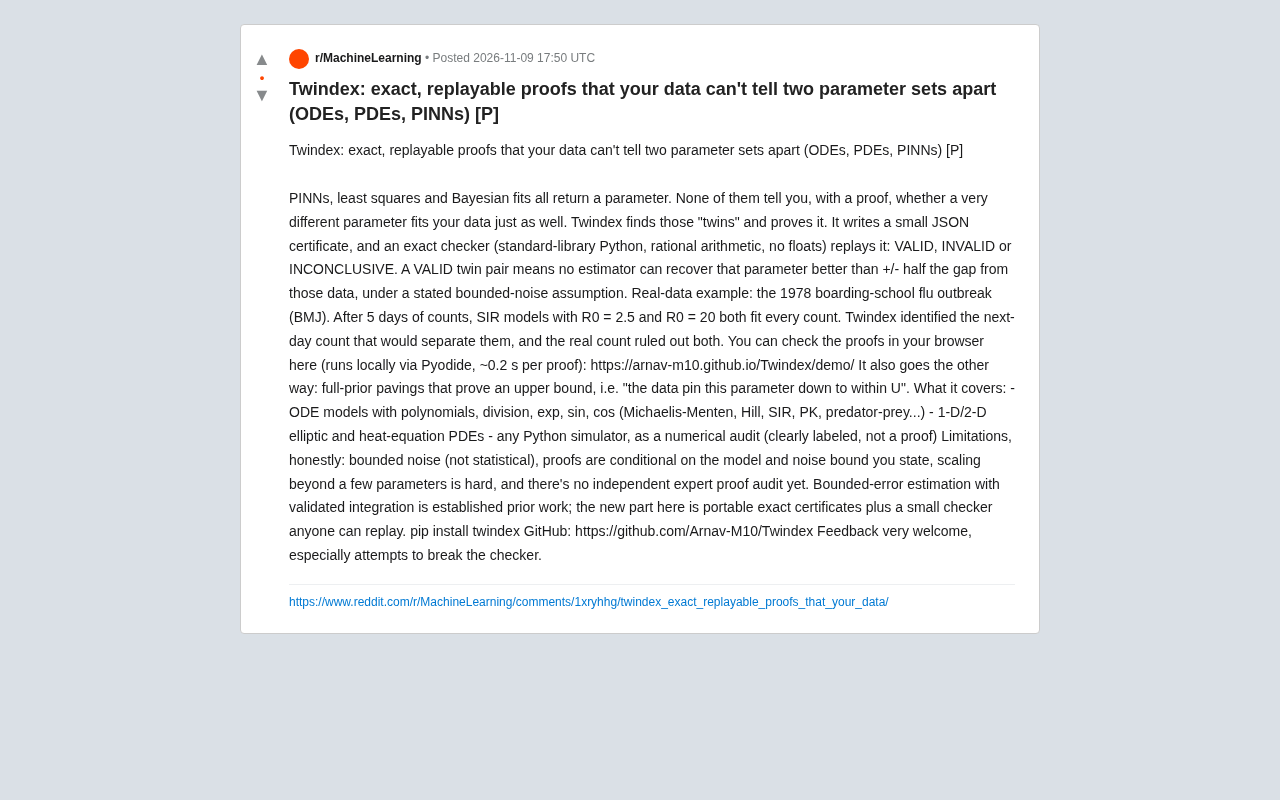
Twindex 用可回放的 JSON 证书证明参数不可辨识性或上界,填补拟合结果唯一性的盲点。
Twindex 是一个针对参数可辨识性的开源工具,它不返回参数估计,而是生成小型 JSON 证书,精确证明在声明的有界噪声假设下数据无法区分两组“孪生”参数,或证明参数被锁定在某个上界内。配套检查器仅用 Python 标准库与有理数算术,可独立回放证书并返回 VALID、INVALID 或 INCONCLUSIVE。论文以 1978 年英国寄宿学校流感数据为例,展示前 5 天计数无法区分 SIR 模型中 R0=2.5 与 R0=20,并精确找出能区分二者的下一天计数。工具支持多种 ODE、一维/二维 PDE 及任意 Python 模拟器(数值审计),安装简便且提供浏览器内演示。作者坦承其局限:有界噪声而非统计噪声、条件性证明、高维扩展困难、尚无独立审计。
参数可辨识性的盲点:你的拟合结果真的唯一吗?
在科学计算与机器学习交汇的领域,参数估计一直是核心问题。PINNs、最小二乘法与贝叶斯拟合都能返回一组参数,但它们有一个共同的盲点:无法证明是否存在另一组截然不同的参数,同样能完美拟合你的数据。这意味着,你以为的“最优解”可能只是众多等价解之一,而模型的可解释性与预测可靠性因此大打折扣。
来自Reddit社区的一个新工具Twindex尝试填补这一空白。它不返回参数,而是生成一个小型JSON证书,证明“你的数据无法区分两组参数”——或者反过来,证明“数据将参数锁定在某个上界内”。
结构可辨识性(structural identifiability) 与 实际可辨识性(practical identifiability) 是参数估计中两个常被混淆的层次。结构可辨识性问的是:在理想的无噪声数据下,模型参数是否唯一确定?它只取决于模型方程的形式,与具体数据集无关。实际可辨识性则关注:在有限、含噪的真实数据下,参数能否被可靠地约束。Twindex 处理的正是实际可辨识性的一种严格形式——在声明的有界噪声假设下,数据能否区分两组参数。许多看似“拟合良好”的模型之所以给出不可靠的参数,恰恰是因为结构或实际层面存在不可辨识性,而仅靠点估计与置信区间无法暴露这一点。
精确证明如何工作:证书与回放检查器
Twindex的核心机制是精确可回放的证明。它针对给定的模型(ODE或PDE)和数据,搜索是否存在“孪生”参数对:两组参数在给定的有界噪声假设下,对观测数据的拟合程度无法区分。一旦找到,Twindex会输出一个JSON证书,其中包含证明所需的全部信息。
配套的检查器完全基于Python标准库,使用有理数算术(不涉及浮点数),可以独立回放证明并返回三种结果:VALID(有效)、INVALID(无效)或INCONCLUSIVE(不确定)。一个VALID的孪生对意味着:在声明的有界噪声假设下,任何估计器都无法将参数恢复到优于间隙一半的精度。这为参数可辨识性提供了严格的下界保证。
反过来,Twindex也能生成“全先验铺砌”(full-prior pavings),证明数据将参数限制在某个上界U之内。这种双向证明能力,让研究者既能发现不可辨识的情况,也能量化可辨识的程度。
有理数算术意味着数值以分数形式(分子/分母整数)精确表示与运算,不存在浮点舍入误差。在 Twindex 的检查器中,所有区间运算与比较都基于有理数,因此“证明有效”的判定是确定性的,不会因平台或编译器差异而改变。这与其他依赖浮点区间的数值验证工具形成对比:浮点误差可能让一个本应判为 INVALID 的证书偶然通过,而有理数算术排除了这种可能。代价是运算速度较慢、内存占用较高,但 Twindex 通过将证明规模控制得很小(回放约 0.2 秒)来平衡这一取舍。
真实案例:流感爆发数据中的R0孪生
论文中给出了一个来自1978年英国寄宿学校流感爆发(BMJ)的真实数据案例。在仅使用前5天的病例计数时,SIR模型中的基本传染数R0=2.5与R0=20都能完美拟合每一个观测值——两者在统计上无法区分。
Twindex不仅找到了这对孪生,还精确识别出哪一天的病例计数能够区分它们。随后的真实数据表明,实际计数既不符合R0=2.5也不符合R0=20,从而排除了两者。这个案例生动展示了Twindex的实用价值:它不仅能揭示不可辨识性,还能指导实验设计——告诉你还需要哪些数据才能打破简并。
SIR 模型是流行病学中最基本的房室模型,将人群分为易感者(S)、感染者(I)和康复者(R)三类,用三个耦合 ODE 描述状态转移。基本传染数 R0 表示一个感染者在完全易感人群中平均能传染的人数,是决定疫情走向的关键参数。R0 的不可辨识性在早期疫情数据中尤为常见:当感染人数还很少、易感池几乎未消耗时,不同 R0 配合不同的初始感染规模或传播速率,可以产生几乎相同的早期增长曲线。这正是 1978 年流感案例中 R0=2.5 与 R0=20 均能拟合前 5 天数据的原因——直到易感池开始被明显消耗,曲线才出现可区分的拐点。
覆盖范围与使用方式
Twindex支持多种模型类型:
- ODE模型:包含多项式、除法、指数、正弦、余弦等运算,覆盖Michaelis-Menten、Hill方程、SIR、药代动力学、捕食者-猎物等常见形式。
- PDE模型:一维/二维椭圆方程与热方程。
- 任意Python模拟器:作为数值审计(明确标注为审计而非证明)。
安装非常简单:pip install twindex。项目还提供了一个浏览器内演示,通过Pyodide在本地运行,每个证明约0.2秒即可完成回放,无需服务器。
诚实的局限性与待突破的方向
Twindex的作者在发布时明确列出了若干局限:
- 有界噪声而非统计噪声:证明基于有界噪声假设,而非统计分布,因此结论是条件性的。
- 条件性证明:证明的有效性依赖于用户声明的模型结构与噪声上界。
- 扩展性限制:参数维度较高时,证明搜索会变得困难。
- 缺乏独立审计:目前还没有独立专家对证明系统进行审计,尽管作者欢迎任何人尝试“攻破”检查器。
作者也指出,有界误差估计与验证积分是已有工作,Twindex的新意在于可移植的精确证书加上一个任何人都能回放的小型检查器,从而降低了验证门槛。
对AI与科学计算的意义
在PINNs和贝叶斯反演日益流行的当下,Twindex提出了一种互补的严谨性工具。它不替代统计推断,而是为参数可辨识性提供可验证的证书。对于需要高可靠性的领域(如流行病建模、药代动力学、物理系统辨识),这种“无法区分”的证明可能比一个点估计更有价值。
项目已在GitHub开源,作者特别欢迎社区尝试破坏检查器——这或许是检验其鲁棒性的最佳方式。
相关推荐

告别Copilot订阅费:三款免费本地AI编程工具推荐
GitHub Copilot每月20美元太贵?Workflows HQ推荐三款免费本地AI编程工具:Cursor离线补全、Clawed 3.7处理多文件架构、Make自动化测试部署,覆盖开发全流程。

AI编程代理如何工作?Codex、Claude Code与Cursor解析
深入解析AI编程代理的工作原理:从探索代码库、拆解任务、生成代码到运行测试与修复错误,揭秘Codex、Claude Code、Cursor等工具背后的代理循环机制,并探讨开发者如何审查与验证AI生成的代码。

Cursor AI 自动搜索:Python+Selenium 实战
用 Cursor AI 生成 Python + Selenium 脚本,一句话提示词实现 Google 自动搜索:定位搜索框、输入关键词、回车提交、打印页面标题,附关键 API 解析与实践注意事项。