Ultrafast 极速体验:用过就回不去的 AI 工具

速度正取代能力成为 AI 工具的隐形护城河,用户「回不去」的体验具有不可逆性。
一条四个单词的推文「Ultrafast is so fast I do not ever want to go back」折射出 AI 产品竞争重心的迁移。文章指出,当响应速度快到接近即时,用户心流不被打断,等待这一动作从交互中消失。这种「回不去」的表述不是推荐,而是排斥性表态,意味着用户对交互节奏的适应不可逆,迁移成本远超预期。围绕速度与能力存在权衡:反对者认为快速响应牺牲推理深度,支持者认为多数日常任务并不需要最深推理。若速度成为核心维度,AI 工具可能分化为轻量即时与重型云端两条路线,用户按场景切换。速度正在从加分项变成入场券。
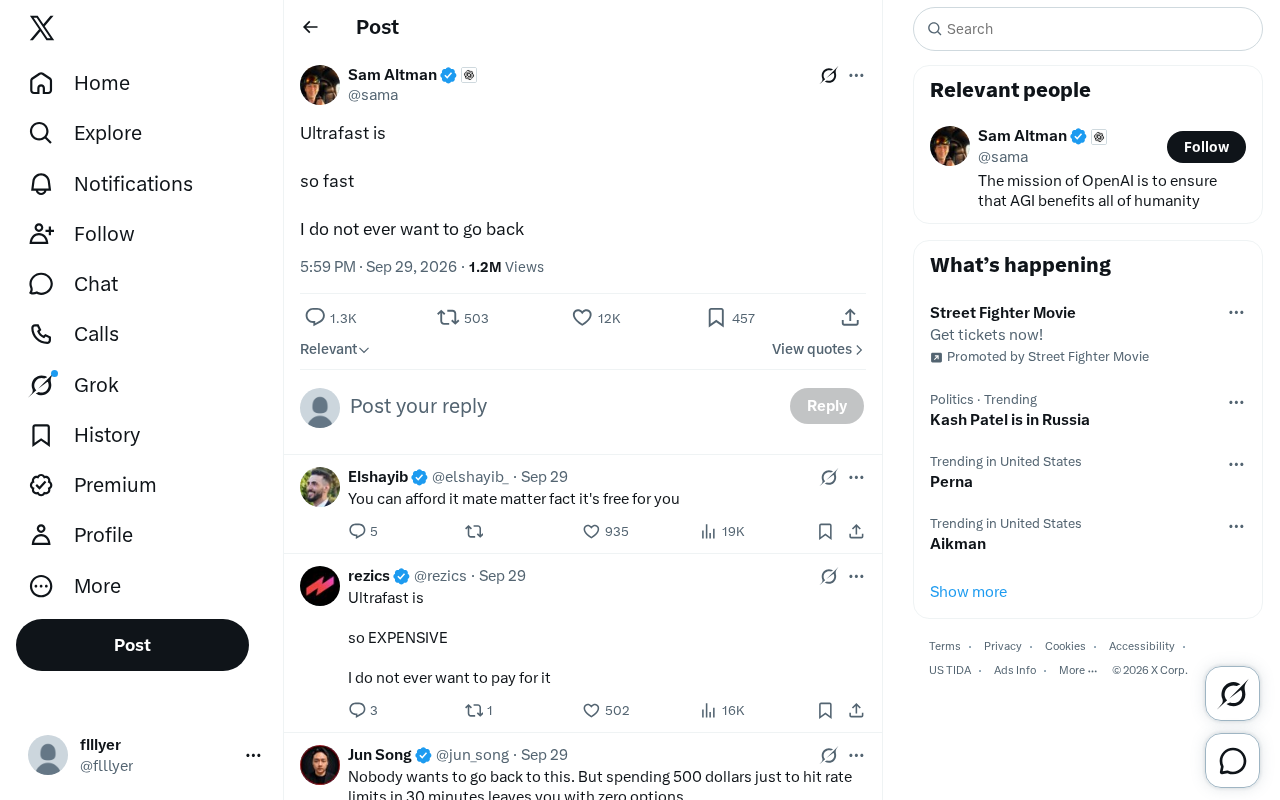
「Ultrafast is so fast I do not ever want to go back.」这条简短的推文在社交平台上引发了不小的共鸣。没有技术参数,没有性能对比,只有一句近乎本能的感叹——用过之后,就再也回不去了。这种表达方式恰恰揭示了当下 AI 工具竞争中一个被低估的维度:速度本身正在成为一种产品壁垒。
速度为什么成了 AI 工具的隐形护城河
过去两年,AI 产品的竞争焦点集中在模型能力上——推理更强、上下文更长、多模态更全。但用户在实际使用中的感受往往是另一回事。一个能在 200 毫秒内返回结果的轻量模型,在交互体验上可能比一个需要等待 5 秒的强大模型更让人「上瘾」。
这背后的逻辑并不复杂。当响应速度快到接近即时反馈时,用户的思维流不会被打断。写作、调试代码、查资料——这些任务需要连续的心流状态,任何一次超过 2 秒的等待都会造成认知中断。Ultrafast 这类工具抓住的正是这个痛点:它未必是能力最强的,但它让「等待」这个动作从交互中消失了。
文中提到的「心流」(Flow)概念由心理学家米哈里·契克森米哈赖提出,指人完全沉浸于某项活动、注意力高度集中且不觉时间流逝的状态。编程、写作等创造性任务尤其依赖心流的持续性。研究表明,一次认知中断平均需要约 23 分钟才能重新回到原有的专注深度。在 AI 辅助工具的场景中,等待响应的时间成本不仅是被浪费的秒数,更是重新进入思维状态所需的隐性代价。这正是毫秒级响应与秒级响应之间体验差距远大于数字本身的原因——它影响的不是效率,而是能否维持连续思考的能力。
「回不去」是一种真实的产品评价
推文中「I do not ever want to go back」这句话值得细看。它不是「很好用」,也不是「推荐」,而是一种排斥性的表态——用户已经无法接受旧的使用方式了。
在 AI 编程领域,这种体验尤其常见。据多位开发者在社交平台上的反馈,一旦习惯了毫秒级的代码补全和即时推理,再切换回需要等待数秒的工具,会产生明显的焦躁感。这和当年从机械硬盘换到 SSD 的感受类似:不是 SSD 「更好」,而是 HDD 变得「不可忍受」。
这种不可逆性对产品来说意味着什么?意味着速度优势一旦建立,用户迁移成本会远超预期。功能可以被追赶,但用户对交互节奏的适应是不可逆的。
多源视角:速度与能力的权衡
围绕 Ultrafast 类工具的讨论并非一边倒。据 X 平台和 Reddit 上多位用户的反馈,快速响应有时以牺牲推理深度为代价——复杂任务上的输出质量可能不如慢速的大模型。
但另一派观点认为,大多数日常任务并不需要最深的推理。写一封邮件、生成一段样板代码、翻译一句话——这些场景下,速度带来的效率提升远大于质量上的微小差距。两方的分歧本质上是在回答同一个问题:你愿意为多少额外质量,付出多少等待时间?
对于这个问题的回答,正在从「质量优先」向「速度优先」倾斜。至少在轻量级任务上,多数用户的天平已经倒向了后者。
「模型蒸馏」与「量化」是当前实现快速推理的两项关键技术。模型蒸馏指用大型「教师模型」的输出训练一个小型「学生模型」,让后者以更少参数逼近前者的表现,代价是复杂推理能力有所衰减。量化则是将模型权重从 32 位浮点数压缩到 8 位甚至 4 位整数,显著降低内存占用与计算时间,但精度损失在极端压缩下会变得明显。这两项技术共同决定了轻量模型的速度上限与能力下限。理解它们有助于判断:速度优势并非纯粹的工程优化,而是以特定方式对能力上限做了取舍,因此「速度 vs 能力」的权衡并非暂时现象,而是架构层面的结构性选择。
速度竞争对 AI 产品格局的影响
如果速度真的成为核心竞争维度,那它会影响的不只是用户体验,还包括产品架构和商业模式。
推理速度的提升依赖几个层面:模型蒸馏与小量化、专用推理硬件、边缘部署、缓存策略。这些技术方向意味着 AI 工具可能从「大而全的云端模型」分化为「轻量、本地、即时」和「重型、云端、按需」两条路线。用户在不同场景下切换使用,而不是依赖单一工具。
Ultrafast 这条推文之所以引发共鸣,可能正是因为它预示了这种分化:未来的 AI 工具不一定要最聪明,但一定要足够快——快到让用户忘记自己在等一个 AI。
「边缘部署」指的是将模型推理从远程云端服务器迁移到用户本地设备(如笔记本、手机或专用芯片)上执行。其优势是消除了网络往返延迟,使响应时间从数百毫秒压缩到几十毫秒以内,同时提升了数据隐私性。但边缘设备的算力与内存有限,通常只能承载经过蒸馏和量化的轻量模型。与边缘部署相对的是云端按需调用大型模型,后者能力更强但延迟更高、成本更贵。两条路线的分化意味着 AI 产品需要重新设计交互范式:轻量工具追求「无感调用」,重型工具则需在等待期间用流式输出、进度提示等手段管理用户预期。
结语
一句四个单词的推文,折射的是 AI 产品竞争重心的迁移。能力依然重要,但速度正在从「加分项」变成「入场券」。对于开发者和产品团队来说,值得思考的问题不是「我的模型够不够强」,而是「用户能不能在思考的间隙里拿到结果」。
原文推文:「Ultrafast is so fast I do not ever want to go back.」
相关推荐

Kimi K3.1实测:开源模型逼近Opus,视频生成意外抢镜
Kimi K3.1在直播实测中完成运动图形、3D渲染、小游戏与视频生成等复合任务。本文分析其2.8万亿参数MoE架构的真实表现、与Opus/GPT的体感差距,以及被官方忽略的视频生成能力,并讨论多模型并用时代的工作流变化。

Sam Altman:人生重大建议,为何仍需来自人类?
OpenAI CEO Sam Altman 谈 AI 建议的边界:AI 能劝阻冲动邮件,但人生重大建议仍应来自人类。他期待 AI 成为会反驳的资深同事,而非谄媚工具。

“黑色十月”:AI挖出史上3%严重漏洞?
Reddit 热帖称过去一个月发现了史上 3% 的严重软件漏洞,被称为「黑色十月」。本文拆解这一说法的统计口径问题,分析 AI 辅助代码审计如何加速漏洞发现,以及开发者和企业该如何应对补丁窗口缩短的挑战。