UnEZ:无监督神经网络如何从光谱中"长出"红移
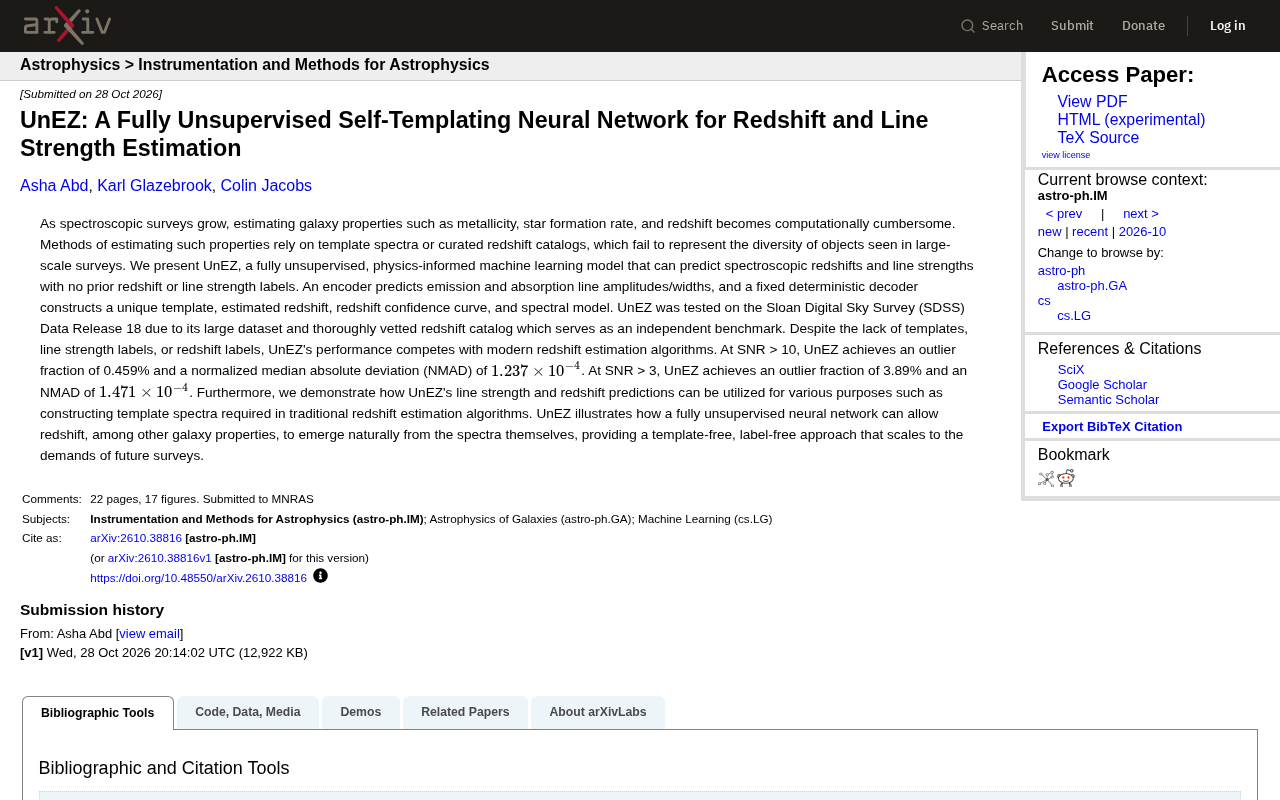
UnEZ 用无监督编码器-解码器从光谱中自涌现红移,在 SDSS 上达到竞争性精度。
UnEZ 是一种完全无监督、物理驱动的光谱红移估计模型,训练时不使用红移标签、谱线强度标签或外部模板库。其编码器预测发射线和吸收线的振幅与宽度,固定确定性解码器据此生成唯一模板并推导红移、置信曲线和光谱模型,实现自模板机制。在 SDSS DR18 上,SNR>10 时离群率 0.459%、NMAD 1.237×10⁻⁴;SNR>3 时离群率 3.89%、NMAD 1.471×10⁻⁴,与传统算法竞争。模型输出还可反哺传统流程构造模板光谱,展示了模板无关、标签无关路径的可扩展性。
传统光谱红移估计长期依赖模板光谱或人工整理的星表,这两条路径在大规模巡天时代都遇到了瓶颈。一篇新论文提出的 UnEZ 模型尝试了一条完全不同的路:不依赖任何红移或谱线强度标签,让红移从光谱数据中自然"涌现"。
当模板和星表都不够用
随着光谱巡天规模持续扩大,估计星系金属丰度、恒星形成率和红移等属性的计算负担越来越重。现有方法要么依赖模板光谱做匹配,要么依赖经过整理的红移星表做监督训练。问题在于,这两类先验知识都难以覆盖大规模巡天中出现的对象多样性——模板是有限的,星表也是有偏的。
UnEZ 的核心主张是:如果网络结构本身嵌入了足够的光谱物理约束,红移和谱线强度就不需要作为标签喂给模型,而是可以从光谱自身结构中学习出来。
光谱红移是天文学中通过测量星系光谱中已知谱线(如氢的巴尔末线、氧的发射线等)的波长偏移来推算星系退行速度的方法。根据多普勒效应,远离观测者的天体发出的光波长会被拉长,红移量 z 定义为观测波长与静止波长之比减一。红移是测量宇宙膨胀、星系距离和宇宙大尺度结构的关键观测量。传统上,红移估计依赖模板匹配:将观测光谱与一组已知红移的模板光谱进行互相关,寻找最佳匹配;或者使用监督学习,以已有红移星表为标签训练模型。这些方法在光谱质量高、对象类型熟悉时表现良好,但面对大规模巡天中大量暗弱、低信噪比或罕见类型的天体时,模板覆盖不足和星表选择偏差会成为系统误差的主要来源。
编码器-解码器架构:预测谱线,而非红移
UnEZ 的设计思路值得细看。它由一个编码器和一个固定确定性解码器组成。编码器负责预测发射线和吸收线的振幅与宽度,解码器则基于这些谱线参数构造出唯一对应的模板、估计红移、红移置信曲线以及光谱模型。
这里的关键在于"自模板"(self-templating):模型不加载外部模板库,而是用自己预测的谱线参数实时生成模板。红移不是直接被回归出来的目标,而是解码过程的副产物。这种设计让模型在没有任何红移标签的情况下依然能输出可解释的中间量——谱线强度和红移置信度。
发射线和吸收线是星系光谱中最重要的特征。发射线由气体受激辐射产生,如 Hα、Hβ、[O III] 和 [N II] 等,通常反映恒星形成活动或活动星系核;吸收线则由恒星大气或星际介质中的原子吸收特定波长的光形成,如 Ca II H&K、Na I D 和 Mg Ib 等。每条谱线可以用振幅(强度)、宽度(速度弥散)和中心波长来描述。在红移估计中,谱线的观测波长与静止波长之比直接给出红移值,因此精确测量谱线参数等价于间接获得了红移信息。UnEZ 让编码器预测这些谱线参数,而非直接回归红移,正是利用了谱线与红移之间的物理对应关系,使模型输出具有可解释性。
SDSS DR18 上的交叉验证
研究团队选择斯隆数字巡天(SDSS)Data Release 18 作为测试平台,原因是该数据集规模大,且其红移星表经过充分校验,可以作为独立基准来评估模型。这一点在方法论上很重要:UnEZ 训练时不使用红移标签,SDSS 星表只用于事后的独立对比。
在信噪比 SNR > 10 的条件下,UnEZ 的离群率(outlier fraction)为 0.459%,归一化中位绝对偏差(NMAD)为 1.237 × 10⁻⁴。在 SNR > 3 的更低信噪比条件下,离群率为 3.89%,NMAD 为 1.471 × 10⁻⁴。考虑到模型完全没有使用模板、谱线强度标签或红移标签,这一表现与传统红移估计算法处于竞争水平。
**离群率(outlier fraction)和归一化中位绝对偏差(NMAD)**是评估光度红移或光谱红移估计精度的两个标准指标。离群率通常定义为红移估计误差超过某个阈值(如 |Δz| > 0.15 或 |Δz|/(1+z) > 0.15)的样本比例,反映严重错误估计的频率。NMAD 则衡量误差分布的离散程度,对离群值不敏感,计算方式为 1.4826 乘以绝对偏差的中位数,数值越小表示估计越精确。在天文学文献中,NMAD 达到 10⁻⁴ 量级通常被认为是光谱级精度,而 10⁻³ 量级则常见于较高质量的光度红移。UnEZ 在 SNR>10 时 NMAD 为 1.237×10⁻⁴,说明其精度接近光谱红移的水平,且完全无需红移标签。
无监督模型的溢出价值
论文还展示了 UnEZ 输出的其他用途。由于模型能预测谱线强度和红移,这些中间结果可以反过来用于构造传统红移估计算法所需的模板光谱。换句话说,一个无监督模型可以充当模板生成器,为依赖模板的既有流程提供输入。
这条思路的更大意义在于可扩展性。未来的巡天将产生海量光谱,人工维护模板库和星表的成本会越来越高。UnEZ 展示的是一条模板无关、标签无关的路径:红移以及其他星系属性可以从光谱本身自然涌现,而不必预先假定一个模板空间。
**自模板(self-templating)**是一种让模型生成自身所需参考模板的机制,区别于从外部模板库加载固定模板的传统做法。在 UnEZ 中,编码器预测的谱线参数(振幅和宽度)被送入一个确定性解码器,解码器根据这些参数实时构造出与该光谱唯一对应的模板。由于模板由模型自身生成,不依赖外部先验,整个流程对模板库的覆盖范围和偏差不敏感。这种设计也使模型输出的中间量——谱线强度和红移置信曲线——具有物理意义,可被其他算法直接复用。自模板思路在无监督光谱分析中具有推广价值,尤其适用于未来巡天中大量未知类型天体的处理。
值得关注的问题
完全无监督意味着没有标签提供的"锚点",模型输出的物理标度如何保证唯一性和一致性,是这类方法需要持续回答的问题。论文以 SDSS 星表做独立基准,在一定程度上缓解了这一疑虑,但跨巡天、跨仪器的一致性仍有待更多验证。
另一个观察点是红移置信曲线的实际可用性——如果置信度能可靠地筛除低质量估计,它在流水线中的价值会显著高于单纯的离群率指标。这可能是后续工作值得深挖的方向。
相关推荐

腾讯WorkBuddy实测:AI Agent如何碾压传统聊天助手
腾讯WorkBuddy实测对比豆包:AI Agent如何直接操作电脑完成PPT转PDF、文件归档等任务。从安装门槛、国内生态、价格、插件市场四方面分析WorkBuddy优势,并给出AI Agent选择建议。

奥特曼称个人PC囤RAM“相当糟糕”,数据中心利用率更高
OpenAI CEO萨姆·奥特曼在Reddit引发热议的表态中称,个人PC配备大量RAM是“相当糟糕”的资源利用方式,数据中心凭借集中调度能实现更高内存利用率。本文解析这一观点背后的技术逻辑与行业信号。

付费5美元教AI说话:一场关于AI训练本质的社会实验
一位开发者搭建了运行真实语言模型的「假AI实验室」,用户支付5美元即可教模型一句话。这个社会实验揭示了AI训练中数据成本、用户参与和话语权的深层关系。