Unlimited OCR 2:单次解析百页文档,计算成本恒定

Unlimited OCR 2 通过 SR-SWA 实现恒定单步成本,将单次解析推进到数百页。
Unlimited OCR 2 针对超长文档解析中视觉上下文膨胀导致计算开销急剧上升的问题,提出稀疏参考滑动窗口注意力(SR-SWA),将活跃参考 token 限制在固定容量内,使单步计算成本不随文档长度增长。结合无限视野解码范式,模型可在几乎无限长度上做单次、不间断解析。在百页文档量级上,相对 Full Attention 和 R-SWA 分别实现 7.0 倍和 5.6 倍单步加速,并在 MPDocBench 与新提出的 MarathonDocBench 上达到当前最优端到端表现。该工作将 OCR 能力从几十页推进到数百页,被视为 OCR 3.0 时代的标志性方向。
从「长文档」到「超长文档」:OCR 的下一道门槛
过去一年,OCR 领域的叙事主线是「长视野解析」——让模型一次性读完几十页文档,而不是逐页切分再拼接。Unlimited OCR 正是这条路线上的代表工作,它把工作记忆的增长压了下来,使文档变长不再线性拖垮模型。
但问题并没有彻底解决。当文档长度从几十页爬升到数百页,视觉上下文总量依然在膨胀,每个解码步的计算开销随之急剧上升。换句话说,工作记忆被控制住了,视觉上下文却成了新的瓶颈,超长文档解析的可扩展性再次被卡住。
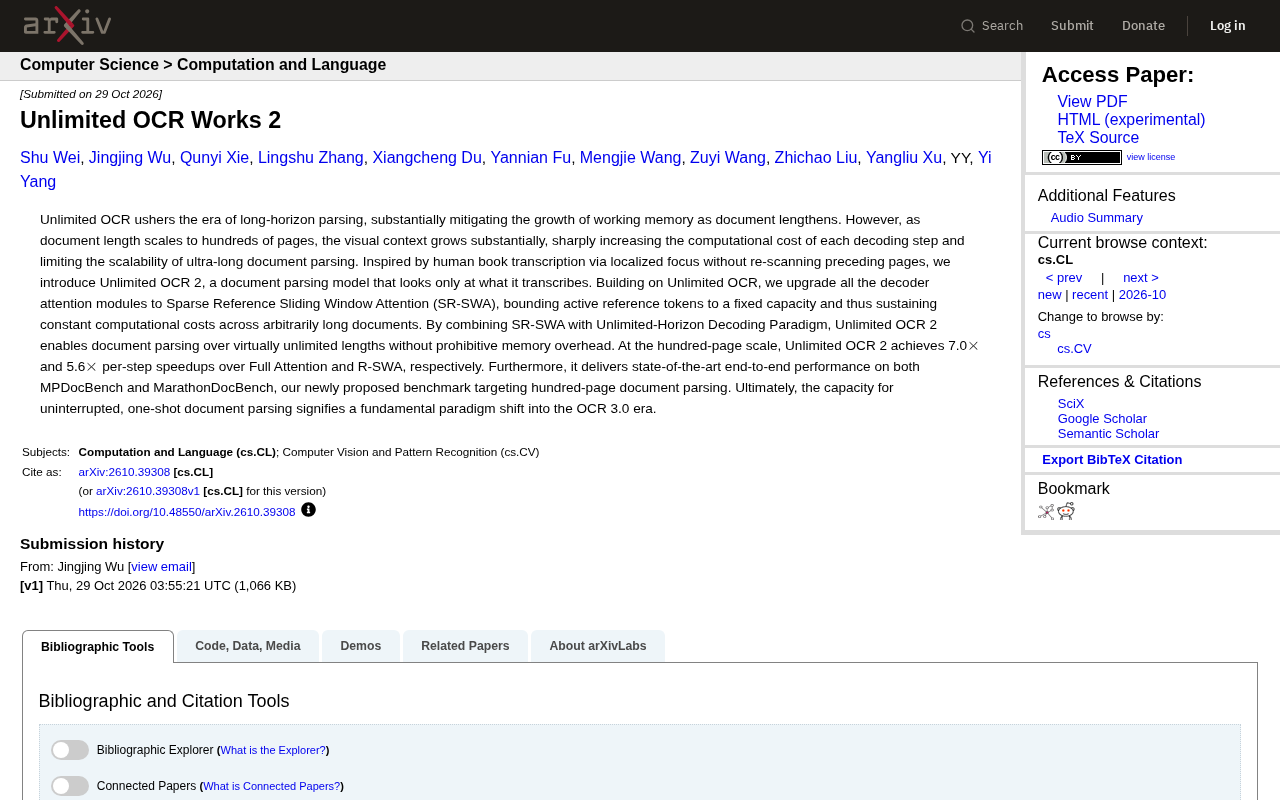
Unlimited OCR 2 要回答的正是这个问题:能不能让模型在解析超长文档时,每一步的计算成本保持恒定?
工作记忆(Working Memory) 在文档解析模型中,通常指模型在处理当前输入时维持的中间状态表示。对于自回归解码的 OCR 模型,工作记忆包括已生成的文本 token 及其对应的视觉特征缓存。若工作记忆随文档长度线性增长,显存占用和计算开销会迅速不可控。Unlimited OCR 通过压缩或固定工作记忆的规模,使模型在读取长文档时不会因缓存膨胀而崩溃,这是其实现“长视野解析”的关键机制之一。理解这一概念有助于区分工作记忆与视觉上下文的不同瓶颈。
核心洞察:像人抄书一样,只看正在写的那一段
研究团队从人类的阅读行为里借了一个类比。一个人誊抄一本书时,不会每写一个字就回头把前面所有页面重扫一遍,而是把注意力集中在当前正在抄写的局部区域。
这个观察被转化成了架构设计原则:模型只「看」它正在转写的内容。基于这一原则,Unlimited OCR 2 在 Unlimited OCR 的基础上,把所有解码器注意力模块升级为 Sparse Reference Sliding Window Attention(SR-SWA,稀疏参考滑动窗口注意力)。
SR-SWA 的关键在于「有界」:它把活跃的参考 token 数量限制在一个固定容量内。无论文档有多长,参与注意力计算的参考 token 数不随长度增长,因此计算成本在任意长度文档上都能维持恒定,而不是像全注意力那样随页数膨胀。
注意力机制中的参考 token 是指在解码每一步时,模型从输入文档中选取参与注意力计算的视觉或文本单元。在全注意力(Full Attention)模式下,所有已编码的参考 token 都会被纳入计算,计算量随文档长度呈二次或线性增长。SR-SWA 通过固定活跃参考 token 的容量上限,将每一步的注意力计算限制在常数规模,从而避免长文档带来的计算膨胀。这与传统滑动窗口注意力约束相邻位置窗口不同,SR-SWA 约束的是参考集合的基数。
恒定成本如何实现:SR-SWA 与无限视野解码
单靠注意力改造还不够。Unlimited OCR 2 将 SR-SWA 与 Unlimited-Horizon Decoding Paradigm(无限视野解码范式) 结合,两者共同作用,使得文档解析在几乎无限的长度上可行,而不必付出难以承受的内存代价。
可以这样理解分工:SR-SWA 负责「每一步看多少」,把单步的参考范围锁死;无限视野解码负责「整个流程怎么走」,让解析过程能够跨越任意长的文档边界持续推进。二者叠加,才构成了「单次、不间断解析」的技术基础。
这也解释了为什么团队强调这是「范式转变」而非单纯的效率优化——它改变的是长文档解析的成本结构,而不是在原有结构上做减法。
性能表现:百页量级的显著加速与端到端领先
在百页文档这一量级上,Unlimited OCR 2 相对 Full Attention 取得了 7.0 倍的单步加速,相对 R-SWA 取得 5.6 倍的单步加速。这两个数字指向同一件事:随着文档变长,恒定成本设计的优势会被放大,而不是被稀释。
端到端表现上,Unlimited OCR 2 在 MPDocBench 和 MarathonDocBench 两个基准上都达到了当前最优水平。其中 MarathonDocBench 是团队专门为百页级文档解析新提出的基准——现有评测集普遍没有覆盖这一长度区间,这也是超长文档解析长期缺乏统一衡量标准的原因之一。
Full Attention 是 Transformer 解码器的标准注意力模式,每个解码步都会对全部历史 token 或参考 token 计算注意力权重。其优点是信息无损,但计算和内存开销随序列长度增长而显著上升,在百页文档上单步成本极高。R-SWA(Reference Sliding Window Attention) 则是一种参考滑动窗口注意力,通常只在固定窗口内选取参考 token,但仍可能随窗口滑动引入额外开销。Unlimited OCR 2 的 SR-SWA 进一步将活跃参考 token 限制为固定容量,从而在百页量级上相对前两者分别取得 7.0 倍和 5.6 倍的单步加速。
为什么这件事值得关注
超长文档解析的真实需求一直存在:合同卷宗、学术论文合集、招投标文件、历史档案,动辄上百页。此前的主流做法是分页处理再合并,代价是跨页上下文丢失、版面逻辑断裂、错误逐页累积。
Unlimited OCR 2 的价值在于把「一次性读完」从几十页推进到数百页乃至更长,同时不让计算成本随长度失控。团队将这一能力描述为 OCR 3.0 时代的标志——从「能识别」到「能连续、单次地解析任意长度文档」,衡量的维度变了。
当然,摘要披露的信息仍集中在架构与基准成绩上,真实场景中的版面复杂度和多语言表现还有待更多独立评测验证。但就「恒定计算成本 + 百页级单次解析」这一组合而言,它确实为超长文档处理提供了一个值得跟进的工程方向。
常见问题
SR-SWA 和普通滑动窗口注意力有什么区别?
普通滑动窗口通常作用于相邻 token 的位置窗口;SR-SWA 约束的是「参考 token」的活跃容量,把参与计算的参考范围固定在一个上限内,从而在文档任意长度下保持单步成本恒定。
恒定成本是否意味着精度会下降?
从公开结果看,Unlimited OCR 2 在 MPDocBench 和 MarathonDocBench 上均达到当前最优,说明有界注意力并未以牺牲端到端效果为代价。但更多场景下的鲁棒性仍需后续验证。
MarathonDocBench 是什么?
它是该工作新提出的百页级文档解析基准,用于填补现有评测在超长文档区间上的空白。
相关推荐

Cognition SWE-2 实战:一个提示词搞定产品发布全流程
解析 YouTube 创作者用 Cognition SWE-2 发布产品的完整提示词:落地页、七封邮件序列与未购买用户跟进工具三段式结构,以及"测试并汇报"这一约束如何改变 AI 的交付质量。
AWS AgentCore Gateway:用MCP打通AI Agent与企…
AWS AgentCore Gateway:用MCP打通AI Agent与企业后端
AWS AgentCore Gateway如何作为主MCP服务器聚合REST API、Lambda与已有MCP服务?解析其AST实时映射、零冷启动、语义搜索治工具过载、会话隔离与密钥注入安全设计,以及企业AI Agent解耦后端的架构思路。

一个链接给Figma AI装上新技能:MCP连接器实战
通过粘贴一个MCP服务器链接,Figma中的AI Agent就能获得新工具能力。本文拆解配置流程、超过20个一键接入应用、读写权限与执行策略设置,以及公开HTTPS链接这一关键限制。