Unsloth Desktop完整评测:本地AI模型部署推理微调一站式解决方案

对于本地部署过大模型的用户来说,Unsloth(安斯洛斯)这个名字并不陌生。这家以高效微调和模型量化闻名的团队,近期推出了一款全新的桌面客户端——Unsloth Desktop,试图把本地模型的部署、推理、微调乃至生图生视频等能力,统一封装进一个傻瓜式的桌面应用中。据B站UP主昆蓬Talk的实测分享,这款工具或许是目前本地部署方案里功能最全面的选择之一。
Unsloth Desktop解决了什么核心痛点
目前本地跑大模型的方案不少,Ollama、LM Studio 等工具已经相当成熟。那么为什么还要再多一个 Unsloth Desktop?
核心痛点在于本地模型在 Agent 场景下的可靠性。凡是真正在本地把大模型用起来的人都有一个共同感受:单纯聊天基本可用,但一旦涉及 Coding Agent 或工具调用(Tool Calling),本地模型就非常容易出错。这几乎是所有本地部署方案的通病。
所谓 Tool Calling(工具调用),是指大语言模型在对话过程中,按照预定义的 JSON Schema 格式输出结构化指令,以调用外部工具(如搜索引擎、代码执行器、数据库查询等)。这一能力是构建 AI Agent 的基础。AI Agent(智能体)是指能够感知环境、自主决策并执行动作的AI系统,与简单的问答对话不同,Agent需要将复杂任务分解为多个步骤,并在每个步骤中决定是否调用外部工具。这种范式的典型架构是ReAct(Reasoning + Acting),模型需要交替进行推理和行动。Tool Calling的难点在于模型必须严格遵循预定义的JSON格式输出,任何格式错误(如括号不匹配、字段名拼写错误、类型不符)都会导致工具调用失败。然而,量化后的本地模型在这一任务上表现远不如云端全精度模型,主要原因包括:量化会损失模型对格式约束的遵循能力、小参数模型本身的指令跟随能力有限、以及不同量化方案对模型逻辑推理能力的影响程度各异。
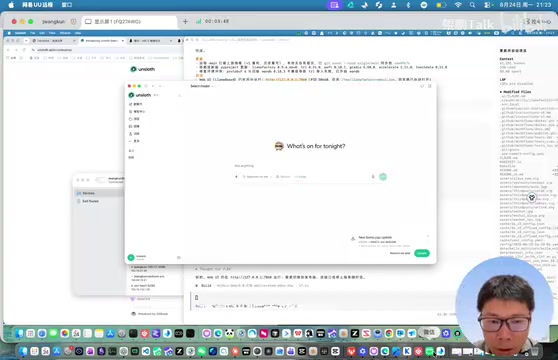
Unsloth 恰恰针对这个问题做了优化。它们自家量化的模型在工具调用、Agent 交互上的表现更稳定,这也是为什么即便有那么多推理工具,仍然值得单独尝试 Unsloth 的关键原因。底层上,Unsloth Desktop 依然基于成熟的 llama.cpp 引擎,兼容性和性能都有保障。
llama.cpp 是由 Georgi Gerganov 于2023年开源的 C/C++ 推理引擎,其核心贡献在于实现了大语言模型在纯 CPU 环境下的高效推理,后续又扩展了对 Apple Metal、CUDA 等 GPU 加速的支持。该项目使用 GGUF 格式存储量化模型,支持从 2-bit 到 8-bit 的多种量化精度,使得原本需要数十GB显存的模型能够在消费级硬件上运行。目前几乎所有主流本地推理工具(包括 Ollama、LM Studio)底层都依赖 llama.cpp,它已经成为本地部署大模型的事实标准推理后端。
跨平台安装与推理性能实测
Unsloth Desktop 目前同时支持 Mac、Windows 和 Linux 三大平台。安装完成后,它启动的是一个独立的桌面 App,就像打开微信、WPS 一样简单。对于不习惯命令行的普通用户来说,这种封装极大降低了使用门槛。
在实测中,UP主在 Mac M3 Ultra 上运行了一个 Qwen3 系列的量化模型,Q8 量化下推理速度达到约 34 tokens/s,日常对话完全够用。这里的 Q8 量化是指将模型参数从 FP16(每参数16位)压缩为 INT8(每参数8位)的表示方式。模型量化是将神经网络中的浮点参数压缩为更低位宽表示的技术——以一个70B参数的模型为例,FP16下需要约140GB存储,而Q4量化后仅需约35-40GB,大幅降低了内存和显存需求。
Unsloth 团队的 Dynamic Quantization(动态量化)方法号称能在同等位宽下保留更多模型能力,尤其在结构化输出和推理任务上的精度损失更小。与传统量化方法对模型所有层采用统一位宽压缩不同,Dynamic Quantization的核心思想是:对模型中关键层(如注意力层的QKV投影、输出层等)保留更高精度,对不太敏感的层则采用更激进的压缩。这种混合精度策略能在整体模型体积与统一量化相当的前提下,在关键任务(尤其是结构化输出、逻辑推理)上保留更多原始模型的能力。类似的思路在GPTQ、AWQ等量化方法中也有体现,但Unsloth声称其方案在Tool Calling等实际应用场景中的表现优于同类方法。
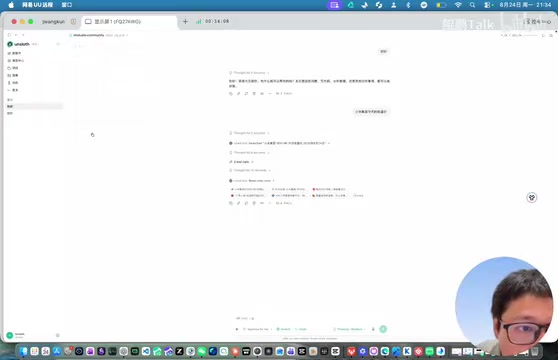
值得一提的是,客户端内置了一个免费的 WebSearch 功能,可以让模型联网获取实时信息。比如查询「小米集团今天的收盘价」这类模型本身无法回答的实时数据,通过内置搜索就能直接补全,这是一个相当实用的加分项。
一个应用覆盖整个本地AI工作流
Unsloth Desktop 最大的亮点是功能的全面性。它远不止是一个文本对话工具,而是把整条本地 AI 工作流都整合了进来:
模型管理与下载
应用内置了模型中心,既能在线浏览、下载 Unsloth 官方量化的大量模型,也能自动扫描并接管本地设备上已有的模型。当前已经支持包括 Qwen3、Meta 系列模型以及 DeepSeek广告 等在内的多种主流模型。
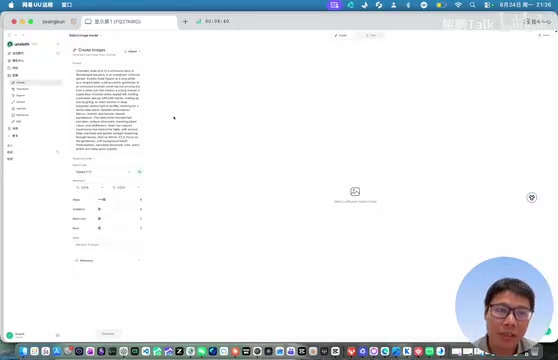
多模态生成能力
除了文本大模型,Unsloth Desktop 还支持文生图、TTS 语音合成、ASR 语音识别,甚至规划了视频生成能力(部分模型如某些视频模型暂未完全支持)。这一点是 Ollama 等纯文本推理工具目前做不到的。
将文生图、TTS、ASR等多模态能力集成到一个桌面应用中面临多重技术挑战。文生图模型(如Stable Diffusion系列)基于扩散模型架构,推理时需要多步去噪迭代,对GPU显存和计算能力要求较高;TTS(Text-to-Speech)语音合成涉及文本前端处理、声学模型和声码器三个阶段;ASR(Automatic Speech Recognition)语音识别则需要处理音频信号的特征提取和序列解码。这些模型各有不同的运行时依赖和硬件需求,统一封装在一个应用中需要精心设计资源调度和模型加载策略,避免多个模型同时占用显存导致OOM(内存溢出)。
本地训练与模型微调
作为以微调起家的团队,Unsloth 把它的看家本领也搬进了桌面端。用户可以直接在本地微调一个小模型,或对模型进行量化处理,这对研究者和开发者来说是极具价值的能力。
本地微调(Fine-tuning)允许用户在预训练模型的基础上,使用自己的领域数据进一步训练模型,使其在特定任务上表现更好。典型应用场景包括:企业用内部文档微调模型以提升领域问答准确率、开发者用自己的代码库训练专属编码助手、研究者在特定学术领域数据上调优模型。Unsloth团队此前因其LoRA/QLoRA微调方案的显存效率而知名——LoRA(Low-Rank Adaptation)通过仅训练低秩分解的适配器参数,可将微调所需显存降低至全参数训练的十分之一。Unsloth的实现在此基础上进一步优化了内核计算,号称比标准HuggingFace实现快2-5倍,使得在单张消费级GPU上微调7B-70B参数模型成为可能。
对接Claude Code与Codex的Agent能力
对开发者而言,Unsloth Desktop 最实用的功能之一是将本地模型以 API 形式暴露出去,并直接对接主流的编码 Agent。
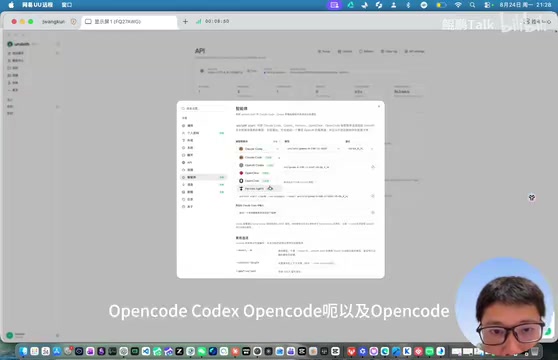
它支持连接 Claude Code、Codex、Open Code 等工具。Claude Code 是 Anthropic 推出的命令行编码 Agent,能够理解整个代码库并自主完成开发任务;Codex 是 OpenAI 推出的类似工具;Open Code 则是开源社区的替代方案。这些工具的共同特点是通过 OpenAI 兼容的 API 接口与大模型通信,因此任何能提供兼容 API 的本地推理服务都可以作为它们的后端。
OpenAI在GPT-3.5发布时定义的Chat Completions API格式(包括/v1/chat/completions端点、messages数组结构、role/content字段等)已成为LLM应用层的事实标准协议。几乎所有下游工具和框架(LangChain、AutoGen、各类IDE插件等)都以此格式作为默认通信接口。这意味着任何本地推理服务只要能提供兼容这套API的HTTP端点,就能无缝接入整个生态系统,无需对上层应用做任何修改。这种标准化极大降低了本地模型替代云端模型的集成成本,也是Unsloth Desktop能够一键对接Claude Code等工具的技术基础。
将本地模型接入这些 Agent 的核心价值在于:数据不出本地(代码隐私保护)、无 API 调用费用、不受速率限制,但代价是本地模型的编码能力通常弱于云端顶级模型。
使用方式非常简单:在客户端里选好并启动模型,复制生成的命令,粘贴到目标工具的命令行中即可一键接入。这意味着你可以用本地跑的模型驱动 Claude Code 完成编码任务,既保护隐私又节省 API 成本。
此外,它还提供远程 API 与内网穿透能力。在本地启动一个服务端口后,Unsloth 会尝试通过 Cloudflare 创建一个内网穿透 URL,让你即便在外网也能远程访问本地部署的模型。
内网穿透(NAT Traversal/Tunnel)是一种让处于内网环境中的服务能够被外网访问的技术。由于大多数家庭和企业网络处于 NAT(网络地址转换)之后,外部无法直接访问内网设备。Cloudflare Tunnel 通过在本地运行一个轻量级守护进程,与 Cloudflare 边缘网络建立加密的出站连接,然后 Cloudflare 为该连接分配一个公网 URL。这种方案无需开放路由器端口、无需公网 IP,安全性较高。对于本地部署 AI 模型的场景,这意味着你可以在家中的高性能主机上运行模型,然后在办公室或手机上通过公网 URL 远程调用推理 API。
若网络条件受限,也可以直接在内网通过本地地址调用接口。配套的还有数据统计和执行日志,方便排查远程调用或 Key 配置问题。
桌面版与网页版Studio如何选择
Unsloth 此前已经推出过网页版的 Studio,那么这次的桌面客户端该怎么选?
UP主给出的建议是:
- 如果你在 Linux 服务器或 Mac 上部署,且主要通过网页页面访问或以 API 方式调用,推荐用网页版 Studio。安装只需一行命令,远程调用也更方便。
- 如果你是 Windows 用户,则更推荐桌面 App。因为 Windows 下命令行操作体验较差,图形化桌面客户端会让操作顺畅很多。
两者内核功能完全一致,桌面版本质上是为简化普通用户使用而做的封装。
国内用户模型下载的解决方案
需要注意的是:Unsloth 从 Hugging Face 下载模型对国内用户不太友好,可能需要自行解决网络问题。UP主的做法是先用 ModelScope(魔搭)把模型下载到本地,再让 Unsloth 自动扫描接管——这也是为什么演示中部分模型显示来源为 ModelScope。
ModelScope(魔搭)是阿里巴巴达摩院推出的开源模型社区和托管平台,可以理解为 Hugging Face 的国内替代。它托管了大量开源模型的权重文件,国内用户可以高速下载而无需科学上网。许多模型作者会同时在 Hugging Face 和 ModelScope 上发布模型,两个平台的模型文件格式完全兼容。对于国内本地部署用户而言,从 ModelScope 下载模型再导入各类推理工具,已经成为标准操作流程。除了ModelScope之外,国内用户还可以选择HF-Mirror等Hugging Face镜像站点,或者使用百度网盘、阿里云广告盘等国内云存储平台上社区分享的模型文件。
好在 Unsloth 能够智能识别本地已有模型,这种曲线方案完全可行。
总结:谁适合使用Unsloth Desktop
整体来看,Unsloth Desktop 把模型下载、推理、多模态生成、本地微调、API 导出、Agent 对接、内网穿透等能力集于一身,可以说是目前本地部署方案中功能最全面的工具之一。对于希望在本地掌控完整 AI 工作流、又不想折腾复杂命令行的用户,尤其是 Windows 用户,它值得一试。当然,国内下载模型的网络门槛,仍是使用前需要提前准备的一环。
相关推荐

前端转AI Agent开发:一线架构师解析职业路径与红利
一线AI架构师解析前端转AI Agent开发的行业变化与落地路径:纯前端岗位为何消失、Agent+全栈为何成为招聘主流,以及Agent开发工程师、FDE、远程接单三条转型路线和对应学习策略。

AI Agent开发课程怎么选?五条避坑指南
机械转行开发者踩坑两年总结的AI Agent开发课程筛选清单:完整交付链路、可写进简历的项目、真实开发视角、更新频率、陪跑反馈五个维度,附具体判断方法和避坑要点。

扣子(Coze)智能体搭建入门:零代码开发AI Agent实战指南
扣子(Coze)是字节跳动推出的一站式AI应用开发平台,支持零代码拖拽搭建AI智能体。本文基于B站教程梳理扣子的核心概念、三大优势、国内版与国际版差异,以及智能体与应用的区别,帮助初学者快速入门AI Agent开发。