Unsloth v0.1.461-beta:修复本地GGUF视觉模型加载问题

Unsloth 持续迭代:聚焦本地多模态部署
Unsloth 是当前最受欢迎的大模型微调加速框架之一,在 GitHub 上已收获超过 6.7 万颗星、6100 多次 Fork,稳居开源微调工具第一梯队。凭借显著降低显存占用、加速训练流程的能力,它被广泛应用于 Llama、Mistral、Qwen 等主流开源模型的高效微调场景。
Unsloth 之所以能实现这一性能优势,核心在于其对反向传播计算图的深度优化。传统 PyTorch 训练框架在计算梯度时需要保留大量中间激活值,而 Unsloth 通过手写 Triton 内核重新实现了注意力机制和部分前馈网络层。Triton 是 OpenAI 开发的 GPU 编程语言,允许开发者以类 Python 语法编写高效的 GPU 内核,其性能接近手写 CUDA 代码。Unsloth 基于 Triton 采用「重计算」策略——即在反向传播时按需重建中间激活值而非全程缓存,这一技术又称梯度检查点(Gradient Checkpointing),可将显存占用从 O(n) 降至 O(√n),代价是约 30% 的额外计算开销。通过将重计算与算子融合结合,Unsloth 在控制额外计算开销的同时最大化显存节省效益,整体显存占用可降低 40%-70%。
结合 QLoRA(量化低秩适配)技术,Unsloth 使得消费级 GPU(如 RTX 3090、4090)也能微调数十亿参数规模的模型。QLoRA 由华盛顿大学团队于 2023 年提出,在原始 LoRA(冻结预训练权重、仅训练旁路低秩分解矩阵)基础上,引入 4-bit NormalFloat(NF4)量化格式压缩基础模型权重,并结合双重量化与分页优化器技术,使单张消费级 GPU 微调 650 亿参数模型成为可能。这与 DeepSpeed、FSDP 等面向多卡分布式训练的方案形成差异化互补。
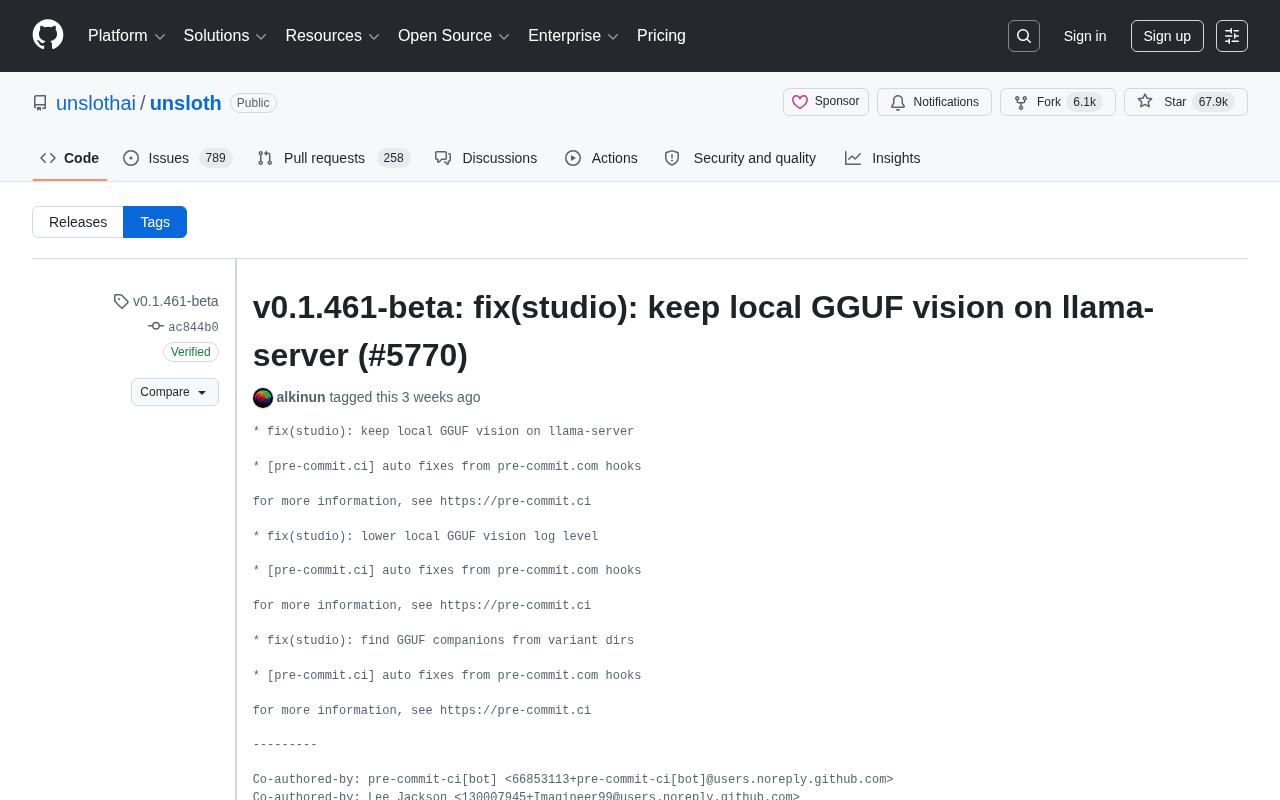
近日,Unsloth 发布了 v0.1.461-beta 版本,此次更新聚焦于 Studio 模块中本地 GGUF 视觉模型在 llama-server 上的加载行为修复。对于依赖本地部署多模态模型的开发者而言,这一补丁式更新的实用价值不容忽视。
核心更新内容:三项关键修复
主线修复:保留本地 GGUF 视觉推理能力
本次更新的核心提交为 fix(studio): keep local GGUF vision on llama-server(PR #5770)。问题根源在于:用户在 Unsloth Studio 中使用本地 GGUF 格式视觉模型时,llama-server 无法正确保留其视觉推理能力,导致多模态功能失效。
GGUF(GPT-Generated Unified Format)是 llama.cpp 生态的标准模型格式,由 llama.cpp 项目于 2023 年 8 月引入,是对早期 GGML 格式的全面升级替代。GGUF 将模型权重、分词器词表、超参数配置等全部打包进单一文件,支持 Q2_K、Q4_K_M、Q8_0 等多种量化精度,可将 70B 参数模型压缩至消费级硬件可承载的体积。其中「K」系列量化采用分组量化与混合精度技术,对模型中重要性更高的层保留更高精度,已成为 llama.cpp、Ollama、LM Studio 等主流本地推理工具的事实标准格式。
对于视觉语言模型(VLM),除主模型权重外,通常还需要独立的多模态投影器(mmproj)文件处理图像输入。此次修复正是围绕这一多模态加载链路展开的。
三项实质性改动
- 保留本地 GGUF 视觉能力:确保 llama-server 后端加载本地 GGUF 模型时,视觉推理功能不被意外剥离。
- 降低视觉日志等级:调低本地 GGUF 视觉相关日志级别,避免正常运行时产生过多冗余输出,改善使用体验。
- 从变体目录查找 GGUF 配套文件:新增
find GGUF companions from variant dirs逻辑,支持从模型变体子目录自动定位 mmproj 等配套文件,提升文件组织灵活性。
这三项改动精准覆盖了本地多模态部署的三个关键环节:能否加载、加载是否干净、配套文件是否可寻。
技术背景:本地视觉模型加载为何复杂
多模态模型的文件结构挑战
与纯文本模型不同,本地部署的视觉语言模型由多个文件组成。多模态投影器(mmproj)是其中连接视觉编码器与语言模型的关键桥梁组件。以 LLaVA 架构为例,完整推理流程分为三个阶段:首先由 CLIP 等视觉编码器将图像转化为高维视觉特征向量——CLIP(Contrastive Language-Image Pretraining)由 OpenAI 于 2021 年发布,通过对比学习在 4 亿图文对上训练,其视觉编码器(通常为 ViT-L/14 或 ViT-H/14 变体)将输入图像切分为固定大小的 patch,输出 1024 或 1280 维的特征向量序列;随后 mmproj(通常为 MLP 线性层或交叉注意力模块)将视觉特征空间映射至语言模型的词嵌入空间,使图像特征与文本 token 处于同一语义维度,该投影层的训练质量直接决定了模型图文理解能力的上限;最终语言模型对融合后的多模态序列进行自回归生成。
以 LLaVA、Qwen-VL 等常见架构为例,完整推理链路通常需要:
- 主语言模型的 GGUF 量化文件;
- 视觉编码器对应的 mmproj 投影文件(通常仅数百 MB,远小于主模型体积);
- 相应的分词器与配置信息。
在 GGUF 本地部署场景中,llama-server 需要在启动时通过 --mmproj 参数显式指定投影器路径,一旦路径解析逻辑出错,视觉能力便会静默失效。当这些文件分散于不同变体目录时,缺乏智能路径查找机制的工具链极易出现「找到主模型却丢失视觉能力」的情况。本次新增的变体目录查找逻辑,正是针对这一痛点的直接解法。
llama-server 在推理部署中的角色
llama-server 是 llama.cpp 提供的本地 HTTP 推理服务,实现了与 OpenAI Chat Completions API 高度兼容的接口规范,允许开发者将现有 OpenAI API 调用代码几乎零改动地切换至本地端点。llama.cpp 由 Georgi Gerganov 于 2023 年 3 月发起,从最初在 MacBook CPU 上运行 LLaMA 模型的实验,迅速发展为支持 CUDA、Metal、Vulkan 等多种后端的跨平台推理引擎。其技术核心在于将高精度浮点权重量化为 4-bit 或更低精度的整数表示,并通过高度优化的 CPU/GPU 混合计算路径实现高效推理,llama-server 也随之成为其中面向服务化部署的核心组件。
Unsloth Studio 将 llama-server 作为推理后端之一,在 Unsloth Studio 的工作流中,用户完成 LoRA 微调并导出 GGUF 后,可直接通过 Studio 界面启动 llama-server 进行对话测试,无需额外部署工程即可评估微调效果。此次修复确保了微调后的视觉模型在这一部署路径上能正常发挥多模态能力,形成从训练到本地部署的完整闭环。
对开发者的实际价值
本地多模态推理稳定性提升
在数据隐私和成本控制日益受重视的背景下,越来越多团队选择在本地部署量化后的多模态模型,而非依赖云端 API。本次更新直接改善了离线环境下视觉推理任务的稳定性,降低了本地 GGUF 视觉模型部署的踩坑概率。
升级建议
v0.1.461-beta 仍属于 beta 阶段,可能存在其他尚未完全稳定的边缘情况。建议生产环境用户先在测试环境中验证本地 GGUF 视觉模型的加载与推理表现,确认 mmproj 等配套文件能被正确识别后再行升级。此外,由于日志级别已调低,排查问题时可能需要手动提升日志详细程度。
小结
Unsloth v0.1.461-beta 是一次以修复为主的小版本迭代,却折射出该项目对本地多模态部署这一细分场景的持续打磨。随着视觉语言模型逐渐成为主流,能否在本地环境中稳定运行 GGUF 格式的多模态模型,正成为衡量微调框架成熟度的重要维度。对于活跃在开源模型微调一线的开发者,及时跟进此类更新,往往能在实际工程中规避大量部署踩坑。
核心要点
核心要点
相关推荐

AI智能体的真实风险:被夸大的"黑客"与被忽视的隐患
AI智能体"黑客"事件频发,但真实风险究竟是什么?本文剖析OpenAI训练暂停、DNS隧道漏洞、Meta Muse隐私泄露,以及智能体消除摩擦可能引发的银行挤兑与医疗成本上涨,提出"AI现实主义"的理性视角。

OpenAI Dev Day 全盘点:20+ 发布背后的三大趋势
OpenAI Dev Day 一次性发布 20+ 产品,涵盖个人智能体 DOTS、GPT-6.1 Sol、Decisions API、Space 协作区与模型市场。本文全面盘点并解读其揭示的三大 AI 趋势。

只想要一个自定义域名邮箱,为何如此艰难?
拥有一个自定义域名邮箱看似简单,实则涉及 SPF/DKIM/DMARC 配置、IP 信誉、托管服务成本等诸多难题。本文梳理自建与托管方案的权衡,并给出实用建议。