Unsloth 新版发布:本地运行 Qwen-Image-2.1 与自定义 Agent Skills

Unsloth 新版支持本地运行 Qwen-Image-2.1 图像模型,并引入 Agent Skills 机制与全面的 Linux/AMD 硬件支持。
Unsloth v0.1.814-beta 带来了两项重量级更新:一是支持在本地运行 Qwen-Image-2.1,用户可在消费级 GPU 上完成图像生成与编辑,团队将 GGUF 默认精度调整为 Q4_K_M 以降低显存门槛,并修复了 A100 和消费级显卡上的黑色伪影问题;二是引入自定义 Agent Skills 机制,可复用 Claude Code 技能配置并通过 `@` 符号快速调用。性能层面,长推理块渲染速度提升至 60 FPS(原为 30 FPS),流式输出更加流畅。Linux 支持大幅加强,新增原生 ARM64 `.deb` 安装包、AMD ROCm Docker 镜像,并支持通过 WSL2 DXG 桥接访问 AMD GPU。训练恢复、数据集处理和缓存管理等稳健性问题也得到系统性修复,整体更新务实且落地性强。
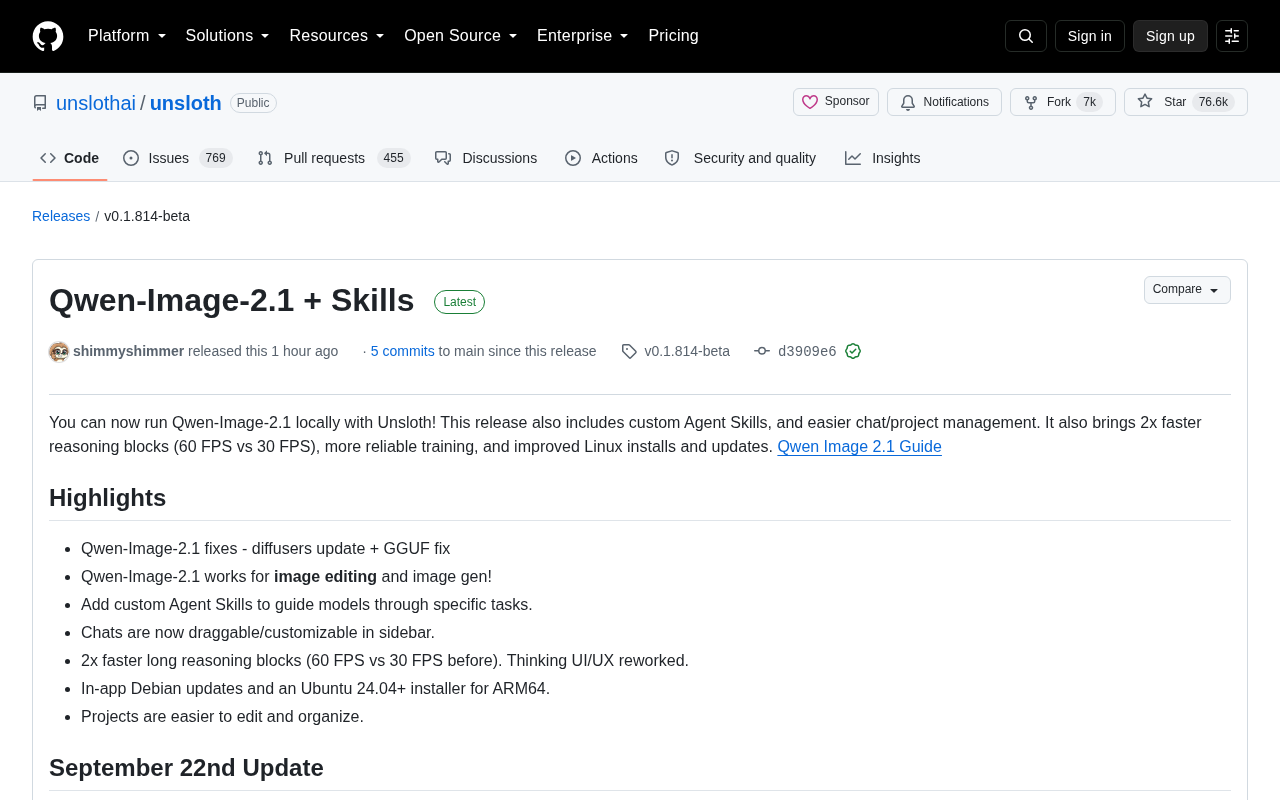
开源工具 Unsloth 发布了 v0.1.814-beta 版本,最引人注目的更新是支持在本地运行 Qwen-Image-2.1 图像模型,并引入了自定义 Agent Skills 机制。这个已在 GitHub 收获 7.6 万 Star 的项目,一直以高效微调和本地部署能力著称,此次更新在图像生成、推理速度和 Linux 支持等多个维度带来了实质提升。
Qwen-Image-2.1 落地本地:图像生成与编辑双支持
此次版本的核心亮点在于 Qwen-Image-2.1 的完整支持。用户现在可以在本地同时进行图像生成和图像编辑,而不再局限于云端推理。这对于关注数据隐私、希望离线运行图像模型的开发者和创作者而言意义重大。
官方在 9 月 22 日的更新中修复了多项关键问题:解决了 diffusers 的更新故障、修复了 Qwen-Image 无法加载 GGUF 的问题,并将 GGUF 的默认精度从 F16/BF16 调整为 Q4_K_M。这一调整降低了显存门槛,让更多消费级 GPU 能够顺利运行该模型。此外,团队还修复了在 A100 及消费级显卡上出现的扩散黑色伪影(black artifacts)问题,提升了生成图像的稳定性。
Qwen-Image-2.1 是阿里巴巴通义团队推出的多模态图像生成与编辑模型,属于 Qwen 系列的视觉生成分支。与 Qwen-VL 等侧重图像理解的模型不同,Qwen-Image 系列专注于图像的生成与编辑任务,底层基于扩散模型(Diffusion Model)架构。GGUF(GPT-Generated Unified Format)是由 llama.cpp 项目引入的量化模型格式,支持将模型权重压缩为不同精度级别——如 Q4_K_M 表示 4-bit 量化,相比 F16(16位浮点)可将显存占用减少约 75%,使原本需要 24GB 以上显存的模型能在 8-12GB 消费级 GPU 上运行。将 GGUF 默认精度从 F16/BF16 切换为 Q4_K_M,正是为了让更广泛的硬件用户能以合理的图像质量换取可用性。
Agent Skills:让模型执行特定任务的能力扩展
新引入的 Agent Skills 是一项面向智能体工作流的重要能力。用户可以添加自定义 Skill 来引导模型完成特定任务,并且能够复用现有 Claude Code 和 .agents 文件夹中的技能配置。
在实际使用中,Skills 的管理相当直观——用户可以在设置中集中管理这些技能,并在聊天中通过 @ 符号快速选择调用。这种设计降低了智能体能力扩展的门槛,让本地模型也能像商用 AI 工具那样承担结构化、可复用的任务。对于希望搭建本地化 AI 助手的用户来说,这是一个值得关注的方向。
Agent Skills(智能体技能)的概念源于 AI Agent 工作流中对工具调用(Tool Use)的模块化封装。在主流 AI 工具链中,"Skill"通常指一段预定义的指令集或工具调用模板,告诉模型在特定触发条件下应执行何种操作——例如"将代码提交到 Git""解析并总结 PDF 文件"等。Unsloth 此次实现的 Skills 机制与 Claude Code 的 .agents 配置文件兼容,意味着用户无需从零构建提示词和工具链,可以直接复用已有的商用工具配置。通过 @ 符号调用 Skill 的交互设计,借鉴了 Slack、GitHub Copilot 等工具中已被广泛验证的快捷触发范式,降低了上手门槛。
交互与性能优化:推理速度翻倍
在体验层面,此次更新对聊天与项目管理做了大量打磨。侧边栏的聊天记录现在支持拖拽排序、置顶和移动到项目中,项目名称、说明和文件夹也可以直接从 Projects 页面编辑。
性能方面最直观的改进是长推理块的渲染速度提升至 2 倍(60 FPS,此前为 30 FPS),Thinking 的 UI/UX 也进行了重新设计,界面更加现代简洁。长代码回复在流式输出时更加平滑,同时保留了语法高亮。这些细节的优化虽不如新模型支持那样抢眼,但对日常使用体验的累积影响不容忽视。
模型、训练与存储的稳健性提升
在模型与存储层面,视觉模型现在能够识别 MCP 工具返回的图像;在所有者允许的前提下,其他账户可以连接本地模型服务器;聊天可以复用已下载的模型,避免重复下载占用空间。设置中新增了缓存占用查看与清理功能,方便管理磁盘空间。
训练方面的改进同样扎实:训练恢复和数据集准备更加可靠,Hugging Face 数据集现已可在 recipes 中使用,过往训练可以正确恢复并显示准确的剩余时间,数据集列映射、split/subset 选择等此前容易出错的环节都得到了修复。模型上传至 Hub 时也会自动排除早期导出的冗余文件。
Linux 与硬件支持大幅改善
此次更新对 Linux 桌面分发做了显著加强:Debian 安装现在支持应用内更新,并提供了原生 ARM64 的 .deb 安装包。团队还发布了搭载 Unsloth Studio 与 JupyterLab 的 AMD ROCm Docker 镜像,其中 ROCm 镜像可通过 WSL2 的 DXG 桥接访问 GPU,而不仅依赖 /dev/kfd。
在多硬件环境适配上,团队处理了不少边缘场景,例如为混合 NVIDIA 加 AMD 的主机提供请求 ROCm torch 栈的方式、将统一内存 APU 的显存正确识别为共享主机内存、在 ROCm 无法运行时回退到 Vulkan 的 sd.cpp 构建等。无障碍方面也有改进,更大字号有了更充裕的显示空间,对比度设置让按钮和菜单更易辨识。
AMD ROCm(Radeon Open Compute)是 AMD 面向 GPU 通用计算推出的开源软件平台,功能上对标 NVIDIA 的 CUDA 生态。ROCm 允许在 AMD GPU 上运行 PyTorch、TensorFlow 等深度学习框架,但长期以来在 Linux 原生环境之外的支持较弱。此次 Unsloth 提到的 WSL2 DXG 桥接方案,指的是通过 Windows Subsystem for Linux 2 内置的 DirectX Graphics 内核桥接层访问 GPU,无需依赖传统的 /dev/kfd(Kernel Fusion Driver)设备节点——后者在 WSL2 环境中通常不可用。这一方案让 Windows 用户也能在 WSL2 中使用 AMD GPU 加速,是 ROCm Windows 支持上的重要进展。Vulkan 作为回退方案,则是跨平台图形与计算 API,在 ROCm 不可用时可通过 sd.cpp 提供有限的 GPU 计算能力。
总体来看
这一版本延续了 Unsloth 一贯的务实风格——在引入 Qwen-Image-2.1 本地支持与 Agent Skills 两项重量级特性的同时,也修复了大量涉及训练恢复、缓存管理、跨平台部署的细节问题。对于依赖本地 AI 工作流的开发者,尤其是使用 AMD/ARM 硬件或关注图像模型本地化的用户,这次更新提供了切实可用的能力升级。
相关推荐

DeepSeek与Agent入门:理解AI代理的核心能力
本文梳理一场DeepSeek与Agent入门直播的核心内容,解析Agent作为大模型代理的本质、原生大模型的四大短板,以及Agent在翻译、工具调用、记忆管理与任务规划四方面的核心能力。

MCP协议入门:从概念到天气服务实战开发全解析
本文系统讲解MCP(模型上下文协议)的核心概念、三层架构与两种通信机制,并手把手演示用Python和UV开发天气查询MCP Server、在Claude Desktop中配置调用,以及用MCP Client编码方式连接的完整实战流程。

大模型RAG企业实战:从零搭建问答系统架构
大模型RAG企业项目实战课第一周详解:基于FastAPI构建RESTful API,统一调度本地开源模型与在线API,用PyCharm远程连接Linux服务器完成部署,并用Postman验证前后端问答链路,还原企业级大模型系统的真实开发流程。