Unsloth 新版发布:决策模型训练把准确率从30%拉到80%

Unsloth 新版支持将任意LLM微调为结构化决策模型,并原生整合ComfyUI及MoE训练提速。
Unsloth v0.1.905-beta 带来三条核心更新线:一是决策模型训练能力,通过 QLoRA 在任意文本或视觉 LLM 上附加决策头,使模型能在多个选项间输出带置信度的结构化决策,官方称准确率从 30% 提升至 80%,训练产物可导出为 GGUF 并通过 llama.cpp 部署;二是扩散模型与 ComfyUI 生态的原生打通,支持 Krea-2、HunyuanImage-2.1 等主流模型及量化格式,INT8 ConvRot 兼顾质量与速度;三是 MoE 架构训练提速,Qwen3.5-35B-A3B 在 A100 上最高提速 4.1 倍。桌面端同步引入跨平台代码沙箱和浏览器功能增强,整体将 Unsloth 的定位从文本生成微调工具扩展至结构化决策与多模态生成的统一平台。
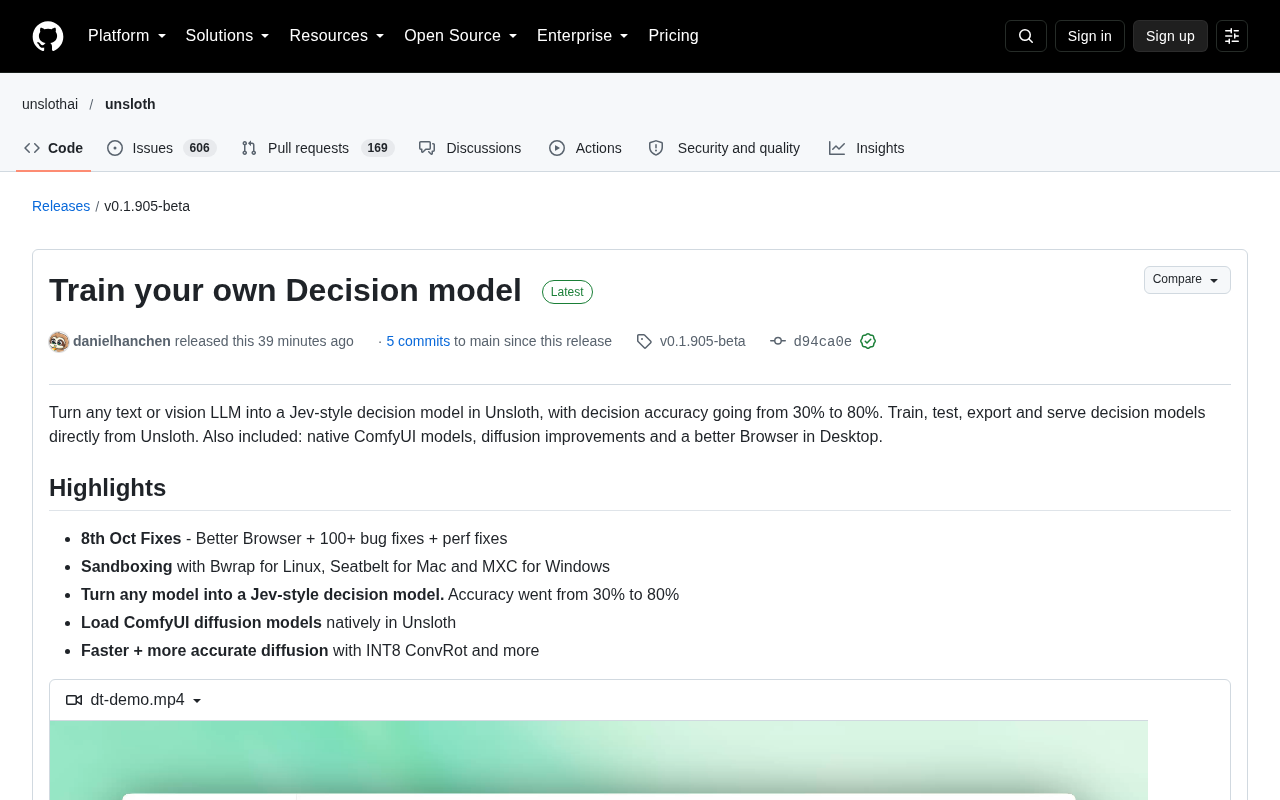
开源微调框架 Unsloth 发布 v0.1.905-beta(内部版本 2026.10.2),带来一项颇具实用价值的新能力——把任意文本或视觉大模型训练成「决策模型」。官方给出的数据相当直接:决策准确率从 30% 提升到 80%。同一版本还集成了原生 ComfyUI 模型支持、扩散推理优化,以及桌面端浏览器的大幅改进。
决策模型:让 LLM 学会「做选择」
这次更新的核心是所谓的 Jev 风格决策模型。它的思路不是让模型生成一段自由文本,而是在给定的若干选项中做出选择,并为每个选项附带置信度分数。这类能力在路由、分类、工具调用判断、Agent 决策环节都有明确用武之地——传统做法往往要靠 prompt 工程硬凑,稳定性和可解释性都欠佳。
Unsloth 的方案是用 QLoRA 对任意文本或视觉 LLM 进行微调,训练出一个带「决策头」的模型。整个流程——训练、测试、导出、部署——都可以直接在 Unsloth 内完成,不需要在多个工具之间来回切换。从 Decision API 设置里就能直接测试训练好的模型,这种闭环体验对工程落地很友好。
从 30% 到 80% 的准确率跃升是官方宣传的最大卖点。需要客观看待的是,这一数字来自 Unsloth 自身的发布说明,并未附带独立基准和测试条件说明,具体效果仍需结合实际任务验证。
导出与部署的灵活性
训练产物支持多种落地路径:带 Qwen3.5 骨干的 Clef 模型和 Laya 模型都能导出为 GGUF 格式,并通过 llama.cpp 提供服务,其中还包括能理解图像的多模态决策模型。此外,框架支持保存和恢复更小的适配器(adapter)与决策头检查点,这意味着增量训练和断点续训的成本更低。官方文档地址为 unsloth.ai/docs/basics/train-your-own-decision-model-with-unsloth。
QLoRA(Quantized Low-Rank Adaptation)是当前主流的参数高效微调技术之一。其核心思路是先将预训练模型以 4-bit 精度量化以大幅降低显存占用,再在此基础上仅训练少量低秩适配矩阵(LoRA 层),而不更新原始权重。这意味着原本需要数十 GB 显存才能微调的大模型,在消费级 GPU 上也能完成训练。「决策头」(decision head)则是附加在主干模型顶端的轻量分类层,专门负责将模型最后一层的隐状态映射为各选项的 logit 分数并转化为概率,而非生成自由文本 token 序列——这使推理延迟更低、输出更可控。
扩散模型与 ComfyUI 原生打通
另一条值得关注的更新线是扩散模型生态的整合。Unsloth 现在可以直接运行来自 Hugging Face 的 ComfyUI 图像和视频模型,并能自动识别 ComfyUI 的 checkpoint 和本地模型文件夹,连带复用你已有的文本编码器与 VAE。
支持的模型阵容相当丰富:Krea-2、HunyuanImage-2.1、Wan2.2 专家对(expert pairs),以及 ComfyUI 的 NVFP4 和 MXFP8 量化模型都在列。对习惯 ComfyUI 工作流的用户来说,这降低了迁移和混用的门槛。
在性能侧,Qwen-Image-2.1 默认启用 INT8 ConvRot,官方称这能在压缩的同时保留更多全精度图像细节,并在受支持的 NVIDIA GPU 上获得更快的 ConvRot 生成速度。这类「量化不掉质」的工程优化,正是 Unsloth 一贯擅长的方向。
ComfyUI 是目前最主流的扩散模型节点式工作流界面,用户通过拼接功能节点(如采样器、文本编码器、VAE)构建图像/视频生成流程,并能保存为可复用的工作流 JSON 文件。其 checkpoint 格式(.safetensors 或 .ckpt)已成为扩散模型生态的事实标准,Civitai 等社区发布的绝大多数模型均采用该格式。INT8 ConvRot 是一种将卷积或线性层的权重量化到 8-bit 整数并结合旋转变换以减少量化误差的技术,相比暴力 INT8 量化能更好地保留模型的感知质量,在图像生成场景中体现为细节保真度更高、色彩偏差更小。
训练性能:MoE 模型提速明显
对训练效率的持续打磨依然是这个版本的重点。使用 QLoRA 在 A100 和 RTX PRO 6000 上,Qwen3.5-35B-A3B 的训练速度最高提升 4.1 倍,Qwen3-30B-A3B 最高提升 3.3 倍。这两个都是 MoE(混合专家)架构模型,提速幅度说明 Unsloth 在稀疏激活模型的训练链路上做了针对性优化。
配套的改进还包括:
- 改进了 gated-delta、Mamba2 和短卷积(short-convolution)模型的样本打包(sample packing)
- 支持把 prompt 和 completion 的消息列表作为同一段对话来训练
- 视觉数据集现在能保留每一行自己的问题
- 聊天导出和训练数据会包含系统提示词(system prompt)
这些看似琐碎的修复,恰恰是决定实际训练数据质量的关键细节,尤其是系统提示词和多轮对话的正确处理。
MoE(Mixture of Experts,混合专家)是一种稀疏激活的神经网络架构。与密集模型(每次前向传播所有参数都参与计算)不同,MoE 模型包含大量专家子网络,每次推理或训练时由一个轻量「路由器」动态选择少数专家参与计算,其余专家保持静默。这使得模型的总参数量可以远大于实际激活参数量——例如 Qwen3.5-35B-A3B 的总参数为 35B,但每次前向传播仅激活约 3B。MoE 在大规模语言模型中已被广泛采用(如 Mixtral、DeepSeek广告-MoE),其稀疏计算模式对训练框架的内存管理和算子调度提出了不同于密集模型的要求,这也是 Unsloth 此次专项优化能带来 3-4 倍提速的根本原因。
桌面端:更强的浏览器与安全沙箱
Unsloth Desktop 作为免费开源的桌面应用,这次也迎来 100 多项 bug 修复和性能优化。浏览器部分的改进最为集中:可以针对打开的页面直接提问、确认下载并选择保存位置、像管理聊天一样重排侧边栏的固定页面、搜索能跳过无效结果并回退到 Wikipedia、回复中的 [1] 式引用现在会变成可点击链接。此外,RAG 菜单里可以直接选择、固定或卸载嵌入模型。
安全层面引入了跨平台的代码沙箱机制:Linux 用 Bwrap、macOS 用 Seatbelt、Windows 用 MXC,对模型运行的代码进行隔离。用户可以在设置中查看沙箱状态并选择保护等级。随着模型执行代码能力越来越强,这种默认内置的沙箱对本地运行场景是必要的安全兜底。
桌面端提供 Windows、macOS、Linux x64/ARM64(deb 与 AppImage)以及 Windows ARM64 的下载包,覆盖了主流平台。
总体评价
这个版本的信息量很大,但主线清晰:决策模型是最具新意的功能,把微调从「生成文本」延伸到了「结构化决策」;ComfyUI 原生整合扩大了扩散模型的覆盖面;MoE 训练提速和一堆数据处理修复则巩固了 Unsloth 作为高效微调框架的基本盘。对于需要把 LLM 嵌入到判断、路由类任务的开发者,决策模型值得一试,但准确率数字应以自己的任务基准为准。
相关推荐

AI SDK 发布版本更新:sandbox-just-bash 组件信息速览
AI SDK 生态组件 @ai-sdk/sandbox-just-bash 发布 1.0.147 补丁更新,同步 @ai-sdk/harness 依赖。本文梳理该发布记录的版本信息与升级建议。

@ai-sdk/sandbox-vercel 1.0.147 发布说明
@ai-sdk/sandbox-vercel 1.0.147 版本发布,这是一次补丁级更新,主要同步升级内部依赖 @ai-sdk/harness 至相同版本,通过 GitHub 可信签名验证。

ChatGPT洗碗记:一支叉子引发的AI过度推理反思
一支洗碗机没洗净的叉子,引发AI启动"深度研究"、消耗海量算力甚至挑战纳维-斯托克斯千禧难题的荒诞实验。这则ChatGPT洗碗讽刺视频,折射出AI过度推理、算力成本与场景错配的真实困境。