Unsloth发布DeepSeek-V4.1量化GGUF:低比特精度反超ISTA

Unsloth 发布 DeepSeek-V4.1 量化 GGUF,自测多项基准反超 ISTA。
Unsloth 发布 DeepSeek-V4.1-Flash-1017 Dynamic V3.1(预览版)GGUF,声称在 AIME25、GPQA-D、MMLU-Pro、IFEval、LiveCodeBench v6、Aider 等七项基准上几乎全面领先 ISTA 的 GSQ-RCO 量化版本。团队复现 ISTA 结果未果,AIME25 上对方声称 100% 精度恢复,实测仅约 91.88%。文章还讨论了 KLD 作为量化质量指标的意义:它反映输出分布保真度,但不能替代任务跑分。部署上该模型可运行于 128GB 内存设备,借助 engram offloading 可下探至 64GB。作者提醒所有数据均为厂商自测,独立复现与自行小规模验证才是选择量化方案的关键。
Unsloth发布DeepSeek-V4.1量化GGUF:低比特精度反超ISTA
量化模型能不能在压缩体积的同时保住精度,一直是本地部署大模型时最现实的矛盾。Unsloth 这次给出了一个颇具挑衅性的答案:他们发布的 DeepSeek广告-V4.1-Flash-1017 Dynamic V3.1(预览版)GGUF,在多项基准上不仅优于上一代 v3,还把 ISTA 的 GSQ-RCO 量化版本几乎全面压了一头。
据 Unsloth 在 Reddit 的官方发布贴,团队对 ISTA 的 GSQ-RCO GGUFs 做了复现测试,但没能得到对方报告的结果,即便采用其中最高的分数。争议最大的一项是 AIME25:ISTA 声称对基线实现了 100% 的精度恢复,而 Unsloth 的实测只有约 91.88%。
基准测试:谁在裸泳一目了然
Unsloth 的对比覆盖了 AIME25、HMMT Feb26、GPQA-D、MMLU-Pro、IFEval、LiveCodeBench v6(32K)以及 Aider pass@1。为保证可信度,每个基准至少跑了 3 次,AIME25 更是跑了 16 次后取平均值。
从公开的数据表看,Unsloth 的 UD 系列在几乎所有指标上领先。即便是他们自称“老旧”的 v3,也在绝大多数指标上优于 ISTA 的对应版本。一个值得注意的细节是体积与精度的权衡:UD-IQ1_S 只有 233.0GB,却在 AIME25 上拿到 92.92,而体积更大(265.8GB)的 GSQ-RCO IQ2_XS 只有 95.00 的 AIME25 表现相近,但在 HMMT Feb26 上 UD-IQ1_S 是 57.01、GSQ-RCO IQ2_XS 是 64.39——这说明不同量化方案在不同基准上的强弱并不一致,不能只看单项指标下结论。
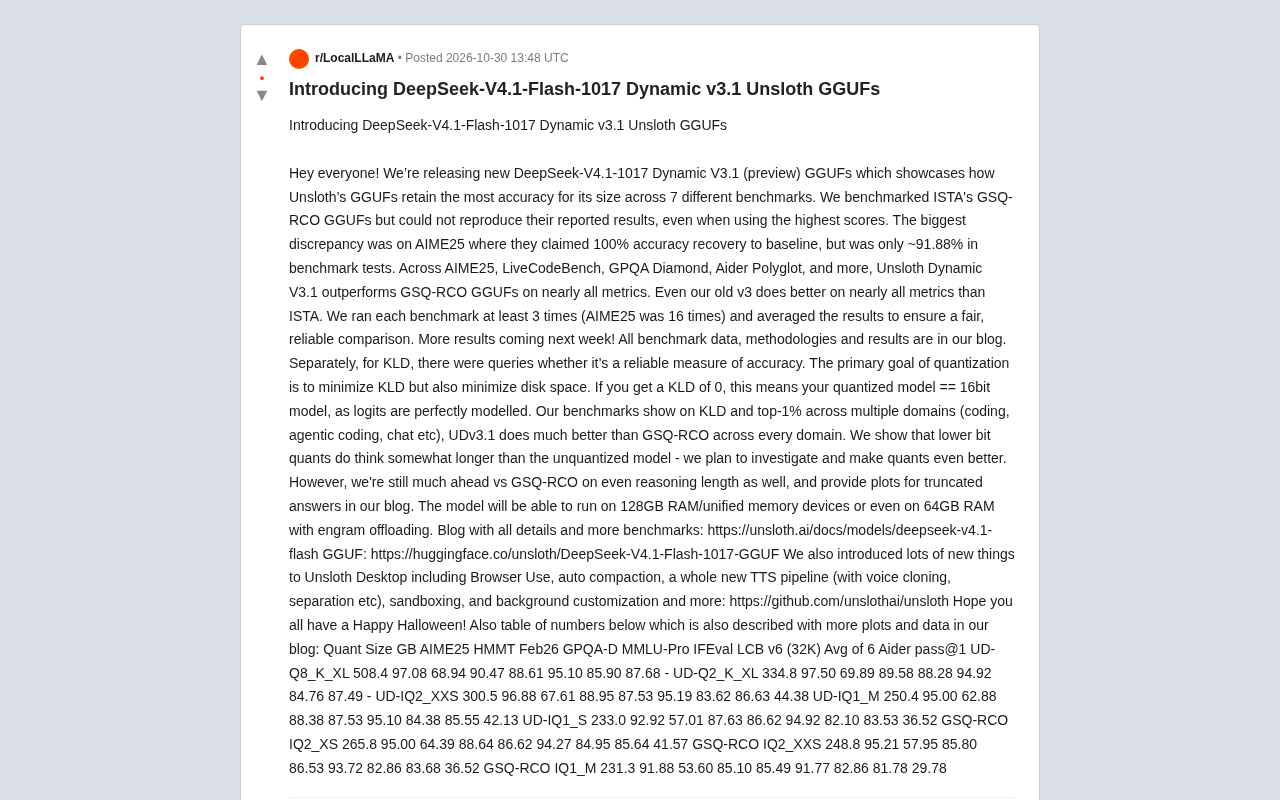
需要提醒的是,这些数字来自 Unsloth 自己的测试环境和流程,属于厂商侧的自评结果,独立第三方复现仍是判断量化方案优劣的关键一环。原文也明确提到,完整的基准数据、方法论和图表都放在其博客中。
GGUF 是 llama.cpp 生态使用的单文件模型格式,把权重、分词器与元数据打包在一起,并支持多种量化类型(如 Q4_K_M、IQ2_XS)。其中带 IQ 前缀的是 i-quant 系列,采用更精细的码本与重要性矩阵来压低比特数;UD 则是 Unsloth Dynamic 的自定义量化方案,宣称对不同层动态分配比特。因此对比表里的 UD-IQ1_S 与 GSQ-RCO IQ2_XS 虽然都基于 GGUF,但量化策略与平均比特数并不相同,体积差异也正源于此。
KLD 到底能不能衡量量化质量
发布贴里还有一个技术讨论点:KLD(KL 散度)是否可靠。Unsloth 给出的解释很直接——量化的主要目标是最小化 KLD,同时最小化磁盘占用。如果 KLD 为 0,意味着量化模型与 16bit 模型等价,logits 被完美建模。
按他们的测试,UDv3.1 在 KLD 和 top-1% 指标上,于编码、agentic coding、对话等多个领域都明显好于 GSQ-RCO。这其实回应了一个常见误区:很多人只盯着“量化后跑分掉多少”,却忽略了分布层面的偏移。KLD 低不代表任务分数一定高,但它能反映模型输出分布是否被破坏,两者应当结合看。
另一个被主动承认的问题是:低比特量化模型在推理时确实会比未量化模型“想得更久”。Unsloth 表示计划进一步调查并优化量化质量,不过在推理长度这项上他们仍领先 GSQ-RCO,博客里也提供了截断回答的相关图表。
KL 散度(KLD) 衡量的是两个概率分布之间的差异:把未量化的 16bit 模型输出分布记为 P、量化模型记为 Q,KLD 即 P 相对 Q 的平均信息损失。KLD 为 0 表示 Q 与 P 完全一致,量化没有破坏任何 logits 信息。实践中通常在整个校准语料上逐 token 累加 KLD 再取平均,并以 top-1% 等指标刻画最坏情况。
需要注意的是,KLD 是分布层面的平均量,与下游任务准确率并非严格单调对应:一个 KLD 略高的模型可能恰好在某类任务上分数更好。因此 KLD 更适合作为量化质量的"体检指标",用来判断模型是否被系统性破坏,而任务跑分则反映具体能力,两者互补而非替代。
硬件门槛与桌面端新功能
部署门槛方面,这个模型可以跑在 128GB 内存或统一内存设备上,借助 engram offloading 甚至能在 64GB 内存设备上运行。对想在本地跑大模型的开发者来说,这是一个相对友好的信号,尤其是统一内存架构的设备。
同批发布的还有 Unsloth Desktop 的一批新能力:Browser Use、自动压缩(auto compaction)、全新的 TTS 管线(支持声音克隆、分离等)、沙箱化以及背景自定义。可以看出 Unsloth 不只做量化权重,也在往完整的本地推理工作流上铺。
engram offloading 指把模型中相对静态、可预测的部分(如部分专家权重或 embedding 表)常驻在内存/SSD,需要时再换入计算单元,从而突破显存或统一内存容量的硬限制。这与传统 KV cache offloading 不同,后者卸载的是随推理动态增长的激活缓存,而 engram offloading 卸载的是权重侧内容,因此对 64GB 设备这类"内存不够装下整个模型"的场景更有效,代价是引入额外的数据搬运延迟。
冷静看待厂商自测
综合来看,这次发布的核心信息有两条:一是 Unsloth Dynamic V3.1 在多项基准上对 GSQ-RCO 形成优势,且低比特版本在部分指标上接近甚至超过更高比特的旧方案;二是围绕 KLD 的讨论把量化评估从“跑分”拉回到“分布保真度”这个更本质的层面。
但结论仍需谨慎。所有对比数据都由 Unsloth 一方产出,ISTA 方面尚未在该贴中给出回应。对普通用户而言,更务实的做法是拿自己的任务做小规模验证,而不是直接照搬榜单。毕竟量化方案的选择,最终取决于你的硬件、任务类型和对推理延迟的容忍度。
相关推荐

WorkBuddy智能体一句话跑通GEO数据库挖掘全流程
WorkBuddy智能体实现GEO数据库挖掘全自动化:从数据搜索、下载整理到批次校正、差异分析、共表达网络、特征基因筛选及免疫浸润分析,一句话提示词即可生成完整生信分析报告,大幅降低生信分析门槛。

PC内存被浪费?Hacker News热议集中式数据中心之争
Hacker News用户提出个人电脑内存被浪费、应集中到数据中心的观点,引发关于集中式与分布式计算资源分配的讨论。本文分析该观点背后的逻辑、集中化的代价,以及AI时代内存资源分配的新张力。

合理使用为何惠及所有人?OpenAI 发布多方案例解读
OpenAI 公开多份法院简报摘录,汇集创作者、学者、无障碍倡导者与法律专家的观点,解读合理使用如何支撑 AI 训练与创新,并分析其对开发者与内容从业者的实际影响。