Unsloth新版发布:本地运行Qwen-Image-2.1并支持自定义Agent技能

Unsloth新版支持本地运行Qwen图像生成模型,并全面优化Agent技能、训练稳定性与跨平台硬件适配。
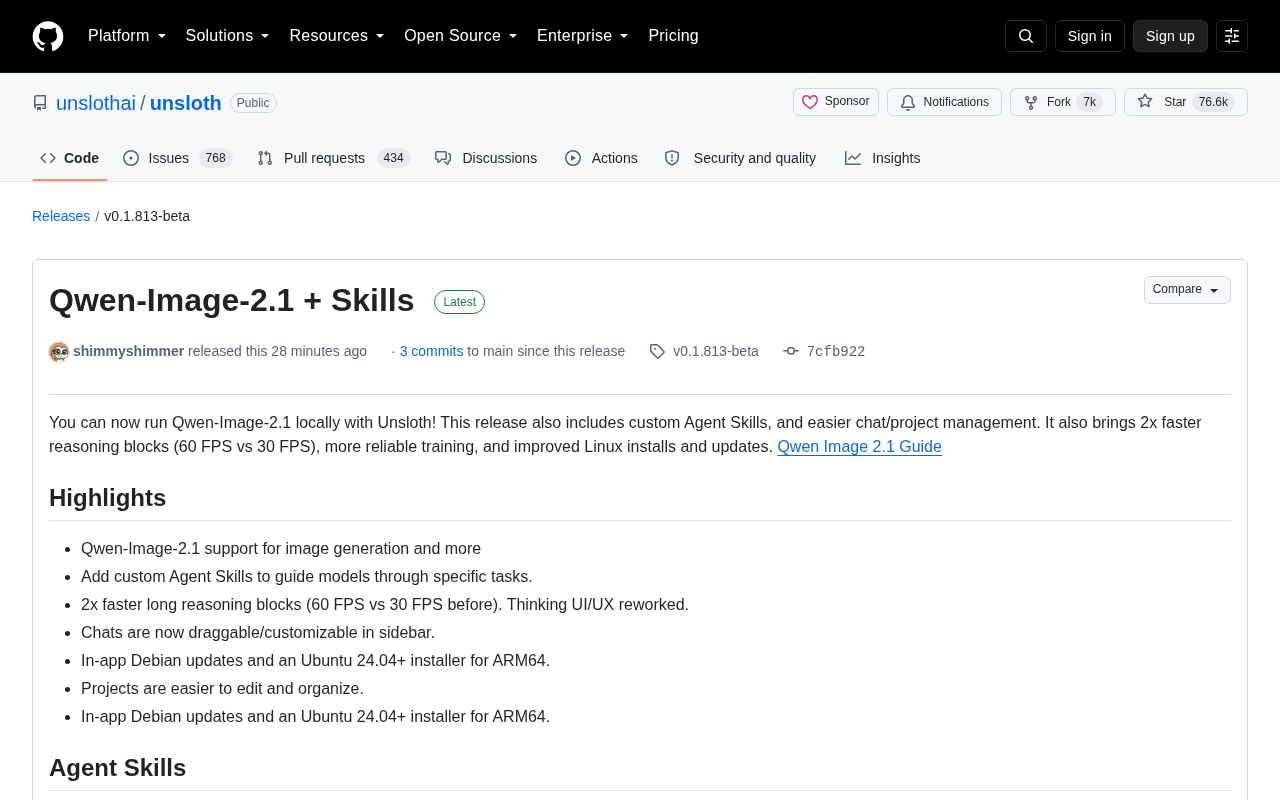
Unsloth v0.1.813-beta是一次横跨多个维度的系统性更新。最核心的新能力是支持在本地运行阿里通义千问的图像生成模型Qwen-Image-2.1,让用户无需依赖云端API即可完成文生图任务。与此同时,新版引入了自定义Agent Skills机制,可直接复用Claude Code和`.agents`文件夹中的已有技能配置,通过`@`符号快速调用。性能层面,长推理块渲染速度从30 FPS提升至60 FPS,训练恢复与Hugging Face数据集支持更加稳定可靠。在硬件覆盖方面,本次更新新增了AMD ROCm Docker镜像、ARM64原生deb安装包,并改善了WSL2下AMD GPU的访问方式,大幅提升了在异构硬件环境下的可用性,对本地部署和微调开源模型的开发者具有较高参考价值。
开源微调工具Unsloth发布了v0.1.813-beta版本,最核心的更新是让用户可以在本地运行阿里通义千问的图像生成模型Qwen-Image-2.1,同时引入了自定义Agent Skills(智能体技能)机制,并对推理性能、训练可靠性和Linux桌面体验做了系统性优化。这次更新覆盖了从图像生成到模型训练、从UI交互到硬件适配的多个维度,对本地部署AI模型的开发者是一次值得关注的迭代。
本地运行Qwen-Image-2.1
新版本最引人注目的能力是支持在本地通过Unsloth运行Qwen-Image-2.1进行图像生成。Qwen-Image是阿里通义千问广告系列的图像模型,2.1版本在生成质量和指令遵循上有所提升。Unsloth将其纳入本地运行支持后,意味着用户无需依赖云端API,就能在自己的设备上完成文生图任务,对数据隐私敏感或希望降低推理成本的场景尤其有价值。
官方同时提供了配套的Qwen Image 2.1使用指南,帮助用户快速上手部署流程。对于视觉模型的支持也进一步扩展——现在Vision模型可以直接读取通过MCP工具返回的图像,让多模态工作流更加连贯。
Unsloth本身是一款专注于大模型高效微调的开源框架,其核心技术是通过手写Triton内核和计算图优化,将LoRA/QLoRA微调的显存占用和训练速度大幅改善——相比Hugging Face原生方案通常能减少50-70%的显存使用,并提速2倍以上。在本次更新前,Unsloth主要以文本/多模态语言模型的微调和推理闻名;将图像生成模型(Diffusion类)纳入支持是其生态扩张的重要一步。Qwen-Image-2.1属于文生图扩散模型系列,与Qwen语言模型共享品牌但架构不同,能够根据自然语言描述生成高质量图像。将其纳入本地运行支持,意味着整条从提示词到图像的推理链路均可在用户自有硬件上完成,不经过任何第三方服务器。
自定义Agent Skills:复用已有技能库
这次更新引入的Agent Skills机制,允许用户添加自定义技能来引导模型完成特定任务。更实用的是,它能直接复用你现有的Claude Code和.agents文件夹中的技能,避免重复配置。
在实际使用中,用户可以在设置里统一管理这些技能,并在聊天时通过@符号快速选择调用某个技能。这种设计思路与Claude Code的技能体系保持了兼容性,降低了从其他工具迁移的门槛。对于希望把常用工作流沉淀为可复用模块的开发者来说,Skills提供了一个轻量的组织方式。
Agent Skills本质上是一种提示词或工具调用模板的封装机制,类似于"宏"或"预设工作流"。用户将常用的任务指令、工具组合或上下文配置保存为一个命名技能,之后在对话中通过@技能名快速注入,避免每次手动输入大段指令。与Claude Code中.agents文件夹的兼容性意味着Unsloth直接读取该目录下的YAML/JSON配置文件,用户无需迁移或重新定义已有技能。MCP(Model Context Protocol)是Anthropic推出的一套开放协议,用于规范模型与外部工具、数据源之间的通信接口;本次更新中Vision模型能读取MCP工具返回的图像,说明Unsloth的多模态工作流已与该协议实现对接,便于接入文件系统、浏览器截图等外部图像来源。
性能与推理体验优化
性能方面,长推理块(long reasoning blocks)的渲染速度提升了2倍,从此前的30 FPS提升到60 FPS,思考过程的展示更加流畅。较长的代码回复在流式输出时也更平滑,同时保留了语法高亮,不再出现卡顿或高亮丢失的问题。
从更新日志中可以看到大量针对训练场景的底层修复:训练恢复(resume)更加可靠,数据集准备更稳定;Hugging Face数据集现在可以在recipes中正常运行,过往训练可以正确恢复并显示准确的剩余时间,数据集列映射和所选split/subset也能被正确识别。此外还有一项B200上的性能实测——Qwen3.5-9B的LoRA SFT训练每步耗时从0.84秒降到0.77秒,属于模型无关的通用优化。
聊天与项目管理重构
交互层面,聊天记录现在在侧边栏完全可拖拽,且在所有平台上都能正常工作。用户可以拖动聊天重新排序、置顶,或将其移入某个项目。项目管理也变得更简单——可以直接在Projects页面编辑项目名称、指令和文件夹,并按更新时间排序。
Thinking(思考)UI/UX进行了重做,呈现出更简洁现代的观感。同时新版本对模型加载行为做了改进,聊天能够正确记住设置;CLI聊天会保留已加载模型的精度并使用推荐设置。存储管理上,用户可以在设置中查看各类缓存占用的磁盘空间并一键清理,聊天也能复用已下载的模型而非重复拉取第二份副本。
Linux桌面与硬件适配
Linux和桌面端的分发体验有了明显改善。新版本为Debian安装提供了应用内更新(in-app updates),并推出了面向ARM64架构的原生.deb安装包和Ubuntu 24.04+安装器,让ARM设备上的部署更加顺畅。
硬件适配方面亮点不少:新增了包含Unsloth Studio和JupyterLab的AMD ROCm Docker镜像;ROCm镜像可以通过WSL2的DXG桥接访问GPU,而不再仅依赖/dev/kfd;当ROCm构建无法运行时,系统会回退到Vulkan的sd.cpp构建。对于混合了NVIDIA和AMD的主机,也提供了显式请求ROCm torch技术栈的方式。这些改动让Unsloth在异构硬件环境下的可用性大幅提升。
ROCm(Radeon Open Compute)是AMD面向GPU通用计算的开放软件栈,功能上对标NVIDIA的CUDA。由于AI生态长期以CUDA为主,ROCm在框架兼容性和稳定性上历史上有较多摩擦,导致AMD GPU用户在本地运行AI模型时门槛更高。Unsloth此次新增的ROCm Docker镜像打包了完整的依赖环境,显著降低了配置复杂度。WSL2的DXG桥接(DirectX Graphics桥接层)允许Windows Subsystem for Linux通过DirectX驱动访问宿主机GPU,绕过了传统ROCm依赖/dev/kfd字符设备的Linux原生路径,使Windows用户也能在WSL2环境中使用AMD GPU进行推理。Vulkan的sd.cpp回退方案则进一步保证了在ROCm不可用时仍能利用GPU图形API加速图像生成,覆盖更多硬件场景。
总结
这次Unsloth的更新是一次覆盖面很广的迭代:既有Qwen-Image-2.1本地图像生成、Agent Skills这样的能力扩展,也有推理提速、训练稳定性、UI交互和Linux/ARM64/AMD硬件适配等大量务实改进。整体来看,它延续了Unsloth在本地化AI模型运行与微调上的路线,把易用性和硬件覆盖度进一步做深,对本地部署和微调开源模型的开发者值得一试。
相关推荐
我让Claude构建可漫步的物理精确O'Neill圆柱:AI生成3D模拟的边界
我让Claude构建可漫步的物理精确O'Neill圆柱:AI生成3D模拟的边界
一位开发者让Claude构建物理精确、可实时漫步的O'Neill圆柱太空栖息地模拟。本文解析其中的科里奥利力、重力梯度等物理挑战,以及AI生成交互式3D模拟的现实意义与局限。

破解数据锁定:用REGISTER与UNREGISTER API实现目录可移植性
湖仓架构下,开放表格式解决了存储可移植性,但目录锁定成为新难题。本文解析REGISTER与UNREGISTER API如何实现元数据松耦合,帮助企业避免厂商绑定、支持多目录协作并安全迁移数据。
macOS 27 AI模型清理工具:如何移除与禁用Apple本地AI
一款登上Hacker News热榜的开源工具可移除和禁用macOS 27中的Apple本地AI模型,帮助用户释放磁盘空间、节省资源并提升隐私可控性。本文解析其工作原理、风险与背后的用户诉求。