Upsolve Data Models:让AI真正理解你的业务指标定义

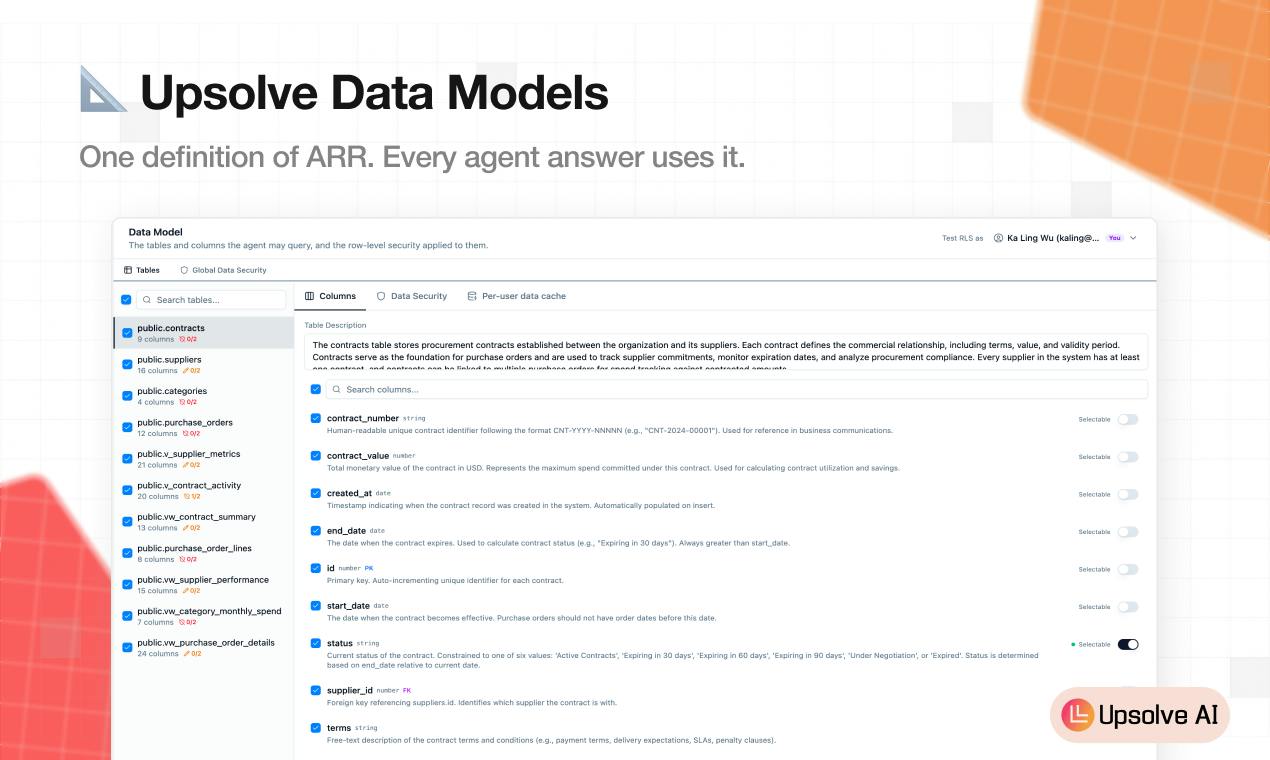
Upsolve Data Models 通过统一注册业务指标定义,让AI Agent回答锚定可信语义而非临场猜测。
企业部署AI数据分析时,最大的信任障碍不是AI能否回答问题,而是答案是否可信——根源在于"活跃用户""月度经常性收入"等业务概念在不同团队间口径不一,AI只能靠猜。Upsolve Data Models 的解法是在AI Agent与数据仓库之间构建一层语义基础设施:用户一次性将数据模型、指标定义和业务词汇注册进来,所有Agent回答都被"锚定"在这套定义上。产品还支持类似代码的版本管理,让口径变更可追溯;并通过每夜自动刷新列值,确保AI掌握最新数据分布。这一思路与dbt Semantic Layer、Cube等语义层产品一脉相承,差异化在于明确面向AI Agent场景。产品近期登上Product Hunt获74赞,但社区反馈有限,初始录入成本与数据栈集成深度仍待实际验证。
数据分析的老问题:AI答案为何总是"似是而非"
企业在引入AI做数据分析时,往往遇到一个尴尬的现实:AI能生成看似合理的SQL和答案,却经常搞错关键指标的定义。什么叫"活跃用户"?"月度经常性收入"该如何计算?"客户流失"以哪个时间窗口为准?这些业务概念在不同团队、不同文档里可能有多套口径,而AI在缺乏统一语境时只能靠猜。
Upsolve Data Models 试图从根源上解决这一问题。它的核心思路很直接——把你的数据模型、指标定义和业务词汇"教"给AI一次,之后每一次AI Agent的回答都会以这套定义为基准,而不是临场发挥。这款产品近期登上 Product Hunt,获得74个赞并排名第18位,归类于 Analytics、Developer Tools 和 Artificial Intelligence 三个领域。
三个关键机制:注册、版本化、每夜刷新
一次注册,全局生效
Upsolve 的第一个设计原则是"注册一次"。用户将企业内部的数据模型结构、每个指标的精确定义以及业务术语表登记到系统中,形成一个统一的语义层。此后所有 Agent 的回答都被"锚定"(grounded)在这套定义之上。这意味着无论谁来提问、以什么方式提问,AI给出的指标口径都是一致的,避免了同一个"销售额"在不同报表里出现三个数字的经典难题。
像代码一样做版本管理
第二个亮点是把指标定义"像代码一样版本化"。业务定义并非一成不变——随着公司战略调整,"合格销售线索"的判定标准可能改变,"付费用户"的门槛可能上调。Upsolve 将这些定义纳入版本控制,让每一次修改都可追溯。这一点对数据治理尤为重要:当某个季度的报表数字出现异动,团队可以回溯到底是数据本身变了,还是定义口径被调整过。
将业务定义纳入版本控制,本质上是把数据治理(Data Governance)的实践引入了语义层管理。数据治理关注数据资产的可用性、完整性、安全性和一致性,其中指标口径的统一历来是企业数据治理中最难落地的部分,因为它依赖组织内部的协商共识,而非单纯的技术手段。版本化的价值不仅在于回溯——当下游 AI Agent 引用的指标定义发生变更时,版本记录还可以作为审计线索,帮助合规团队确认某一时段的报表是基于哪套口径生成的。这与 dbt 将 SQL 转换逻辑纳入 Git 管理的理念一致:把原本隐性的、散落在各处的业务知识变成显式的、受控的工程制品。
每夜刷新列值,答案随数据演进
第三个机制是"每夜刷新列值"(refreshes column values nightly)。数据是活的,枚举值、分类标签会随业务发展不断新增。通过每晚自动刷新,Upsolve 确保AI掌握的是最新的数据分布,而非过时的快照。官方的说法是让"答案随数据变化而保持正确",这解决了很多AI分析工具"上线即过时"的通病。
定位:面向开发者与数据团队的语义基础设施
从分类归属看,Upsolve Data Models 更像是一层介于原始数据仓库与AI Agent之间的语义基础设施,而非面向终端用户的报表工具。它把"业务知识"这个通常散落在员工脑袋里、Confluence文档里、SQL注释里的隐性资产,显式地结构化并交给AI使用。
这一方向与近年来数据领域兴起的"语义层"(Semantic Layer)和"指标层"(Metrics Layer)概念一脉相承。dbt 的 Semantic Layer、Cube 等产品都在尝试解决类似问题,而 Upsolve 的差异化在于它明确面向 AI Agent 场景,强调"grounding"——即用可信定义约束大模型的生成,降低幻觉风险。
语义层(Semantic Layer)是数据架构中位于数据仓库与消费端之间的抽象层,其核心作用是将物理表字段映射为业务可理解的指标和维度,并统一口径。指标层(Metrics Layer)是语义层的子集,专注于将「指标」定义为一等公民——包括计算逻辑、过滤条件、时间粒度等——以确保跨工具、跨团队引用时语义一致。dbt Semantic Layer 基于 MetricFlow 引擎,允许在 dbt 模型上声明式地定义指标,下游 BI 工具和 AI 工具可通过统一接口查询;Cube 则提供独立的语义层服务,支持缓存和多租户。Upsolve 在这一生态中的差异化在于其设计目标从一开始就是服务 AI Agent,而非 BI 仪表板,因此"grounding"(用可信定义约束大模型输出)是其核心价值主张,而非仅仅提供一致的查询接口。
价值与待验证之处
对于正在部署AI数据助手的团队来说,Upsolve 触及了一个真实痛点。AI分析工具最大的信任障碍不是"能不能回答",而是"回答能不能信"。一套统一、可版本化、持续刷新的定义体系,正是建立信任的前提。
不过,从目前公开的信息看,仍有几个问题值得关注:定义的初始录入成本有多高?对已有数据栈(如 Snowflake、BigLake 等)的集成深度如何?每夜刷新对大规模数据集的性能与成本影响怎样?这些都需要实际使用后才能评估。Product Hunt 上仅3条评论,社区反馈样本还比较有限,产品的真实成熟度有待更多用户验证。
对于关注AI落地企业数据场景的从业者而言,Upsolve Data Models 代表了一个务实的趋势:与其追求让AI"更聪明",不如先让它"更懂业务"。
相关推荐
人类能离太阳多近?帕克探测器穿越日冕的科学原理
人类能离太阳多近?NASA帕克太阳探测器曾飞至光球层上方380万英里,深入数百万度的日冕。本文解析为何探测器不会被汽化——温度与热量的区别、阳光强度及隔热罩设计的科学原理。
从空气中制造汽油:合成燃料为何尚未普及?
合成燃料能用空气中的二氧化碳、水和电力制造汽油、甲烷和火箭推进剂。本文解析萨巴蒂埃反应与费托合成的化学原理、热力学税、碳中和账本,以及合成燃料为何尚未普及、又将如何重塑能源地缘格局。
Router Rumble:用WiFi路由器演示梯度下降为何败给NSGA-II
Router Rumble 是一个开源 Python 项目,通过在模拟房间摆放 WiFi 路由器,直观对比梯度下降与 NSGA-II 进化算法在离散目标函数上的表现,揭示无梯度优化方法的优势。