uRun:每秒多次决策,让语音视频Agent更聪明
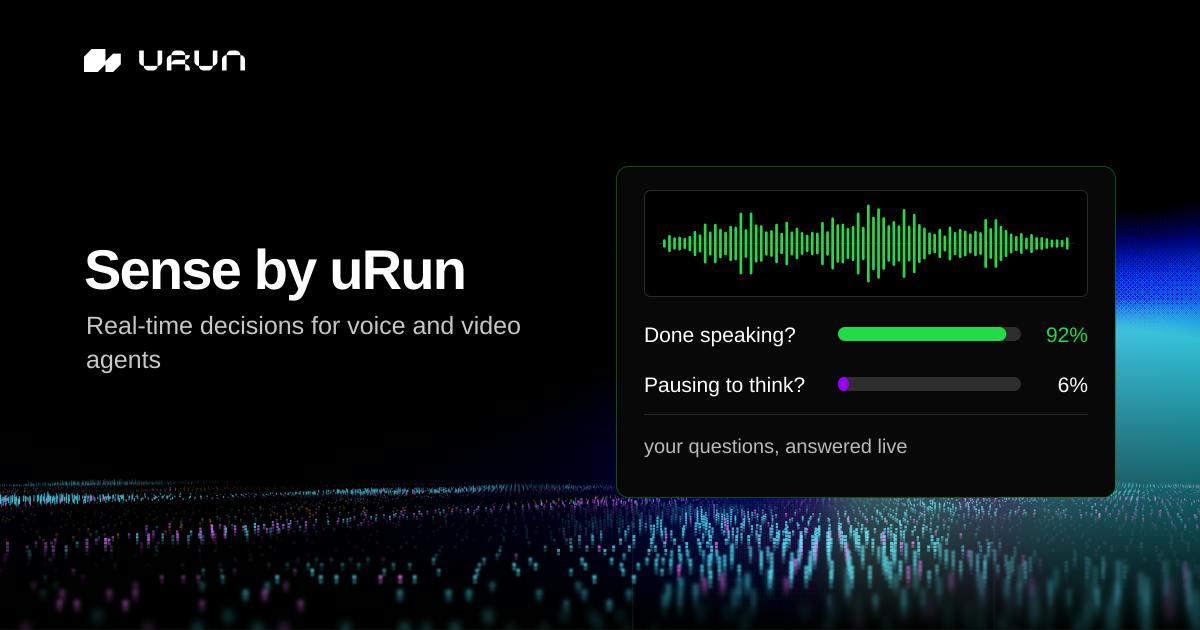
uRun(Sense)用实时决策模型判断语音视频Agent的对话状态,填补VAD之外的交互控制层。
uRun(Sense)是一款面向语音和视频Agent的实时决策模型,运行在流式音视频之上,每秒多次回答开发者自定义的对话状态问题,例如用户是否说完、是否刚刚打断、Agent是否应该停止说话。它试图解决传统VAD在嘈杂环境、多人对话和用户犹豫时容易误判的问题,把控制权交还给开发者。产品提供SDK实时会话和单次请求两种接入方式,新账户赠1,000免费额度,定位为API与开发者工具,填补ASR/TTS之外的“对话状态理解”层。该产品在Product Hunt获得105票、18条评论,排名第13,但准确率、延迟等性能指标尚未披露,实际表现仍需开发者自行验证。
语音和视频Agent正从简单的问答机器人演变为实时交互系统,但一个核心难题始终存在:如何让Agent准确判断对话的微妙状态?比如用户是否说完、是否被打断、Agent是否该停止说话。uRun(产品页称Sense)试图用实时决策模型解决这一问题,并在Product Hunt上获得105票、18条评论,排名第13。
实时决策:语音视频Agent的“神经系统”
传统语音Agent通常依赖语音活动检测(VAD)判断用户是否说完,但这种方式在嘈杂环境、多人对话或用户犹豫时容易误判。uRun的思路更进一层:它运行在流式音频和视频之上,每秒多次回答开发者自定义的问题,例如“用户是否说完”“用户是否刚刚打断”“Agent是否应该停止说话”。
这种“提问-决策”模式把控制权交还给开发者。你只需定义关心的状态问题,Sense返回决策结果,Agent据此行动。这类似于为Agent装上一套实时神经系统,让交互更自然、响应更及时。
语音活动检测(VAD) 是一种通过分析音频能量、频谱特征或过零率等信号,判断当前音频帧中是否存在人声的技术,通常输出“有声/无声”的二值状态。在语音Agent中,VAD的主要作用是端点检测(Endpoint Detection),即判断用户何时开始说话、何时停止说话,从而决定何时启动ASR或结束一轮对话。传统VAD的局限在于它只关注“有没有声音”,而不理解语义和对话意图:背景噪声、咳嗽、多人交谈可能被误判为用户发言;用户思考时的停顿则可能被误判为说话结束,导致Agent过早抢话。uRun试图用“决策模型”替代或补充VAD,正是为了从“声音有无”升级到“对话状态”的理解。
SDK与单次请求:两种使用路径
uRun提供两种接入方式。其一,使用SDK构建实时会话,适合需要连续交互的生产级语音或视频Agent。其二,发送单次请求进行探索,方便开发者快速验证模型能力。新账户注册即获赠1,000免费额度,降低了试错门槛。
从产品分类看,uRun属于API与开发者工具,目标用户是构建实时语音/视频Agent的工程团队。它的价值不在于替代ASR或TTS,而是填补“对话状态理解”这一层空白。
流式处理(Streaming) 是指数据以连续小片段的形式实时到达并被即时处理,而不是等待完整数据后再一次性计算。在语音和视频场景中,音频以每20毫秒左右的帧持续输入,视频则以每秒数十帧的速率产生,Agent必须在数据流动过程中持续做出判断,无法等到一句话说完再处理。uRun所强调的“每秒多次决策”,正是建立在流式处理架构之上:模型需要对不断到来的音视频帧进行低延迟推理,并维持对话状态的连续性。这与传统的“录音—上传—识别”批处理模式有本质区别,也对模型的推理延迟和计算效率提出了更高要求,因为任何明显的处理滞后都会直接表现为交互上的卡顿或误判。
多源佐证下的产品定位
据Product Hunt的发布信息与产品官网描述,uRun(Sense)定位为“实时决策模型”,强调流式处理与高频决策。这一描述与开发者社区对实时Agent的普遍需求一致:Agent需要更快、更准地理解对话节奏,而非仅仅识别文字内容。
有意思的是,目前公开信息中关于模型准确率、延迟等性能指标尚未披露,仅有免费额度作为体验入口。这意味着开发者在实际集成时仍需自行评估其在特定场景下的表现。
ASR(自动语音识别)与TTS(文本转语音) 是语音Agent流水线中的两个基础环节:ASR负责将用户语音转写为文本,供语言模型理解与生成回复;TTS则负责将Agent的文本回复合成为语音播放给用户。二者解决的是“内容转换”问题,即把声音变成文字、把文字变成声音。然而,一场自然对话还包含大量非内容层面的信息:谁在说话、是否被打断、对方是否还在思考、轮次何时切换。这些属于“对话状态”或“轮次管理”问题,ASR和TTS并不负责。uRun定位为填补这一层空白,意味着它不与ASR/TTS竞争,而是作为它们之上的协调层,让Agent知道“现在该听、该说还是该停”,从而把各环节串联成流畅的实时交互。
总结
uRun切入的是语音视频Agent交互中的关键一环——实时对话状态判断。通过可自定义的问题与高频决策,它为开发者提供了比传统VAD更细粒度的控制手段。尽管性能细节尚待验证,但其思路值得关注,尤其适合对交互自然度要求较高的实时Agent场景。
相关推荐
比格犬缉毒队:从水果到GHB的国境防线
比格犬缉毒队如何守护美国边境?本文基于《To Catch A Smuggler》实录,展现农业检测犬查获水果肉类,以及执法部门追踪GHB、可卡因走私的全过程,揭示从东南亚到圣路易斯的毒品供应链与多部门协作。
番茄高产秘诀:稳定供水如何让盆栽番茄远超地栽
一段来自YouTube的种植记录显示,容器中的番茄产量远超主菜园地栽植株。种植者认为关键在于稳定供应适量的水,而非施肥。本文分析稳定供水对番茄结果期和产量的影响,并讨论容器种植的可控性优势。
反向角色扮演:当你在游戏里成为LLM的子代理
Hacker News上出现一款反向角色扮演游戏,玩家扮演LLM的子代理执行任务。本文分析其游戏机制、AI代理热潮下的哲学意味,以及独立开发者如何用轻量交互探讨人机权力关系。